昇腾960提前9个月发布,这几天全网都传疯了。但真正重要的是,华为宣称跨过了CUDA那道生态鸿沟。今天咱们就来讲一讲,到底是怎么回事。大家好,欢迎收听老范讲故事的YouTube频道。昇腾960是面子,华为跨过CUDA那道鸿沟,靠的到底是什么?咱们今天要讲明白。
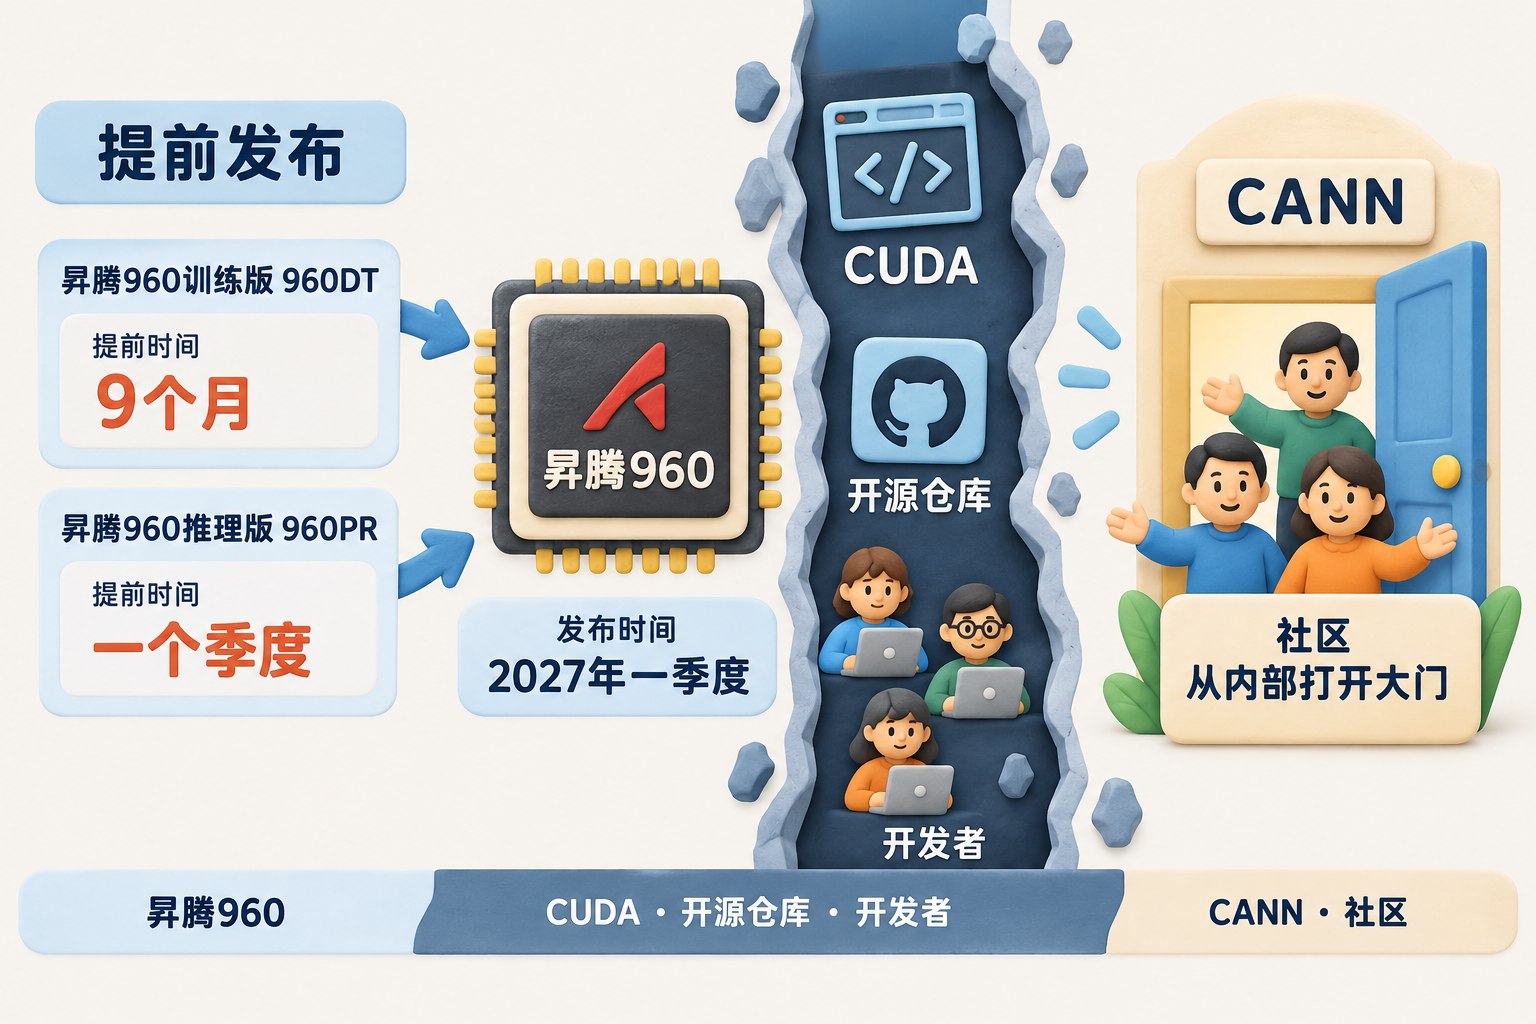
9月17号,华为全联接大会2026在上海开幕。轮值董事长汪涛在台上扔下两颗重磅炸弹。第一颗是硬件的:下一代昇腾960训练版960DT,比原计划提前三个季度,也就是9个月,2027年一季度就能够就绪;推理版960PR提前一个季度。而去年9月的路线图上,960还排在2027年年底。
第二颗炸弹,大家都没有怎么注意,但是我认为要重要得多。汪涛在演讲中宣布,CANN,也就是华为对抗CUDA的那套东西,已经全面开源开放,进入常态化社区运营;昇腾生态跨过了从“可用”到“易用”的关键拐点。翻译成人话,华为宣布自己正在跨过CUDA那道生态鸿沟。
我先表个态。我夸华为的时候不多,经常还阴阳怪气一下,但是这一次真得说,华为干得还不错,是真的努力了。当然,努力背后也有不光彩的东西,后边咱们会讲。但是有效果,就值得拆开来看一看。
今天回答6个问题。第一,英伟达这道墙凭什么砌了快20年,没有人翻得过去?第二,华为自己以前也翻过一次同样的墙,为什么姿势那么难看?第三,这一次昇腾到底干了什么,让开源社区给它开了门?第四,最难的训练那道关卡,昇腾现在走到什么位置了?第五,各家公司现在到底应该买谁家的卡?最后,这套打法,别的国产厂商学不学得会?
我先把话撂这:芯片可以追,生态是追不来的,只能慢慢磨。华为这次摸到了门道,而这个门道说穿了就是两样东西:第一个是守规矩,第二个叫讲礼貌。这两个词放在华为身上,并不多见。
英伟达真正的护城河
先说英伟达到底强在哪。很多人以为英伟达强是强在芯片上,其实不对。AMD的卡也不差,谷歌的TPU、博通替各家大厂做的ASIC,单项性能有些是能够跟英伟达掰手腕的。英伟达真正制霸天下的东西叫CUDA,以及NVLink这些东西,是一整套的生态标准。
CUDA这东西什么时候发布的?2007年发布的,快20年了。今天全世界的AI研究员,从在学校读书那天起,就是用这一套东西。最主流的框架PyTorch跟CUDA是长在一起的,开源模型默认按它的格式发布,一整套工具顺手得像身体的一部分。
有篇报道里头讲得很准:PyTorch就是研究员的母语。你让一个人换母语,这事有多费劲,生态护城河就能有多深。那这道墙为什么这么难翻?一套生态,全行业用了十几年,顺手、稳定,后来者想替代它,只有一种可能,就是掀桌子。
要么便宜一大截,要么整整快一个数量级。有这种让人无法拒绝的差距时,用户才会去挪窝,否则根本不会做这种迁移。为什么?因为适配新生态要花钱、花人、花时间,每挪一步都是坑:新框架出Bug,新版本跟不上。
这个行业现在是什么状态?烈火烹油,都杀红眼了,所有公司都在往前赛跑。你让我停下来,花几个月的时间适配一套没有验证过的新生态,我公司会死的,我的投资人不能同意。这开什么玩笑?真正贵的不是多雇几个工程师、多花几笔钱,是时间,是确定性。
别人的模型先发布一个月,你没跑通,你就会死。这真的是你死我活的竞争。所以英伟达在全世界基本上战无不胜。我把话放这:中国如果没有墙,它一样战无不胜,国内厂商一点抵抗的机会都没有。当然,这个墙这次的情况不同。
封闭市场只是一张门票
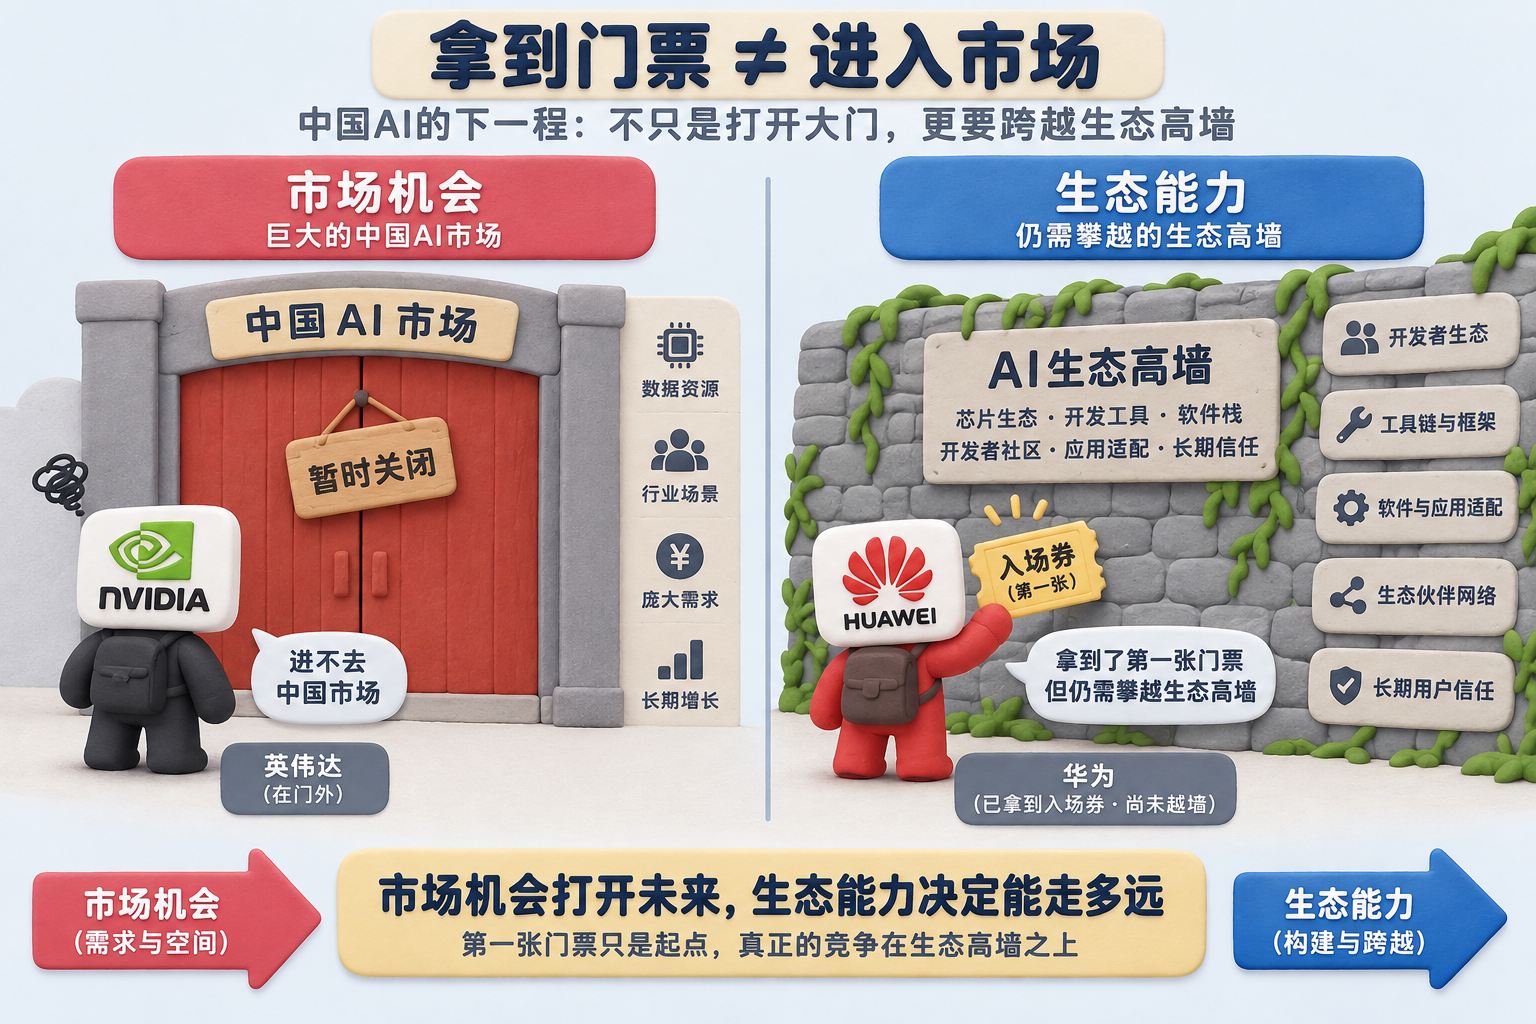
这个墙不是中国人自己修的,这要感谢美国政府给了中国算力芯片足够的机会。这就像当年百度战胜谷歌一样:谷歌在的时候,百度啥也不是;谷歌一退出中国大陆,市场空出来了,百度就独霸天下了,至少独霸中国市场,把其他做搜索的人全赶出去。
不是百度在产品上真的赢了谷歌,是把老大轰出去了。芯片也一样,英伟达最高端的卡在中国买不了,至少没法光明正大地买。门缝一关上,华为这样的公司就有机会上桌了。所以记住第一件事:封闭的市场,是翻越生态鸿沟的第一张门票。老大能冲进来,你再努力都是白搭。但门票只配让你进场,能不能翻过墙,那是另外一回事。
华为曾经尝试过翻越这种生态鸿沟,但是上一次的姿势甭提多难看了。我自己还专门录了两期节目来骂,印象太深刻了。第一个是2025年5月那一期,GitHub上突然冒出来一大批账号,跑到各种开源项目下边去给人提Issue。
这些Issue千篇一律就一件事:鸿蒙很有前景,我们很多人都要用,你这个项目应该支持鸿蒙,不支持就是你不对。我去翻过这些账号,一看就不对劲。大部分都是刚注册的新号,简介都是空的,一个公开仓库都没有,用户名都是拼音加数字,甚至有乱码批量注册的。
Issue都是复制粘贴的,同一段话贴满了几十个项目。最离谱的是,一个做ZIP解压缩的底层库都收到了适配请求。鸿蒙自己是带ZIP的,八竿子打不着。灌水的人压根就没有认真筛选,要不然人家不叫灌水,直接就大水漫灌了。
开源社区怎么运转?其实是非常松散的,没有强制规则,靠两样东西:信任和礼貌。你有真实需求,就好好说话,说人话,写清楚版本、错误,试过了哪些方法;提之前先搜索历史问题,最好把自己的代码写好提交,人家才愿意帮你。结果你上来就拍门、复制粘贴,浪费维护者的时间。这不叫推广,这叫骚扰,开源社区对这种事情是深恶痛绝的。
另外一次是今年5月。独立开发者布布给鸿蒙做适配,最后项目停更归档,指控方案被华为套走了,转头低价外包。各执一词。华为在开源圈的名声,就是被这种事情一点一点败掉的。再加上华为自己搞开源平台,把人家的代码库直接拎回到自己家去;想让谁支持鸿蒙,就挨个项目上门去提要求。这些玩法,说句不好听的,实在是太low了。
但有个判断,大家一定要听进去:别把华为当成一个统一的人格。它里边也是分很多层级、分很多派系的。鸿蒙那帮人把事干low了,不代表昇腾这帮人也这么干。这一次昇腾的玩法,我一条一条查下来,说句公道话,同样是翻墙,拍门和敲门是完完全全两回事。昇腾这一次真的是在里边做得还不错。
从拍门到敲门
自己喊“遥遥领先”是没用的,这个时候要看竞争对手怎么说。竞争对手承不承认,最能说明问题。今年5月,黄仁勋接受CNBC采访,原话是:“华为非常非常强大,他们本土的芯片生态发展得很好。因为我们撤出了那个市场,我们基本上已经把那块市场拱手让给了他们。”
华为自己喊100句“遥遥领先”没用,你的死对头当着全世界的面认栽,这才是真的。当然,黄仁勋讲这个话肯定也是有目的的,也是要给美国政府听的:你看华为已经这样了,你放了我吧。大家都有自己的诉求。
那昇腾这波人是怎么敲门的?对于一家芯片公司来说,眼下最要紧的是让开源推理系统支持自己的芯片。什么叫推理?模型训练好之后,部署到云端,伺候千百万用户每天调用,这一步就叫推理了。推理跑在什么软件上?全世界主要靠几个开源推理系统,最大的两个,一个叫vLLM,一个叫SGLang。
小的云厂商直接拿过来用,大的云厂商回来再在这个开源系统上改。这些开源系统要是不认你的芯片,你的卡性能吹上天,也就是一块砖头,没有任何用处。让这些系统支持你,也是分三六九等的。最高的一档是什么?官方主仓库直接把你收进去。
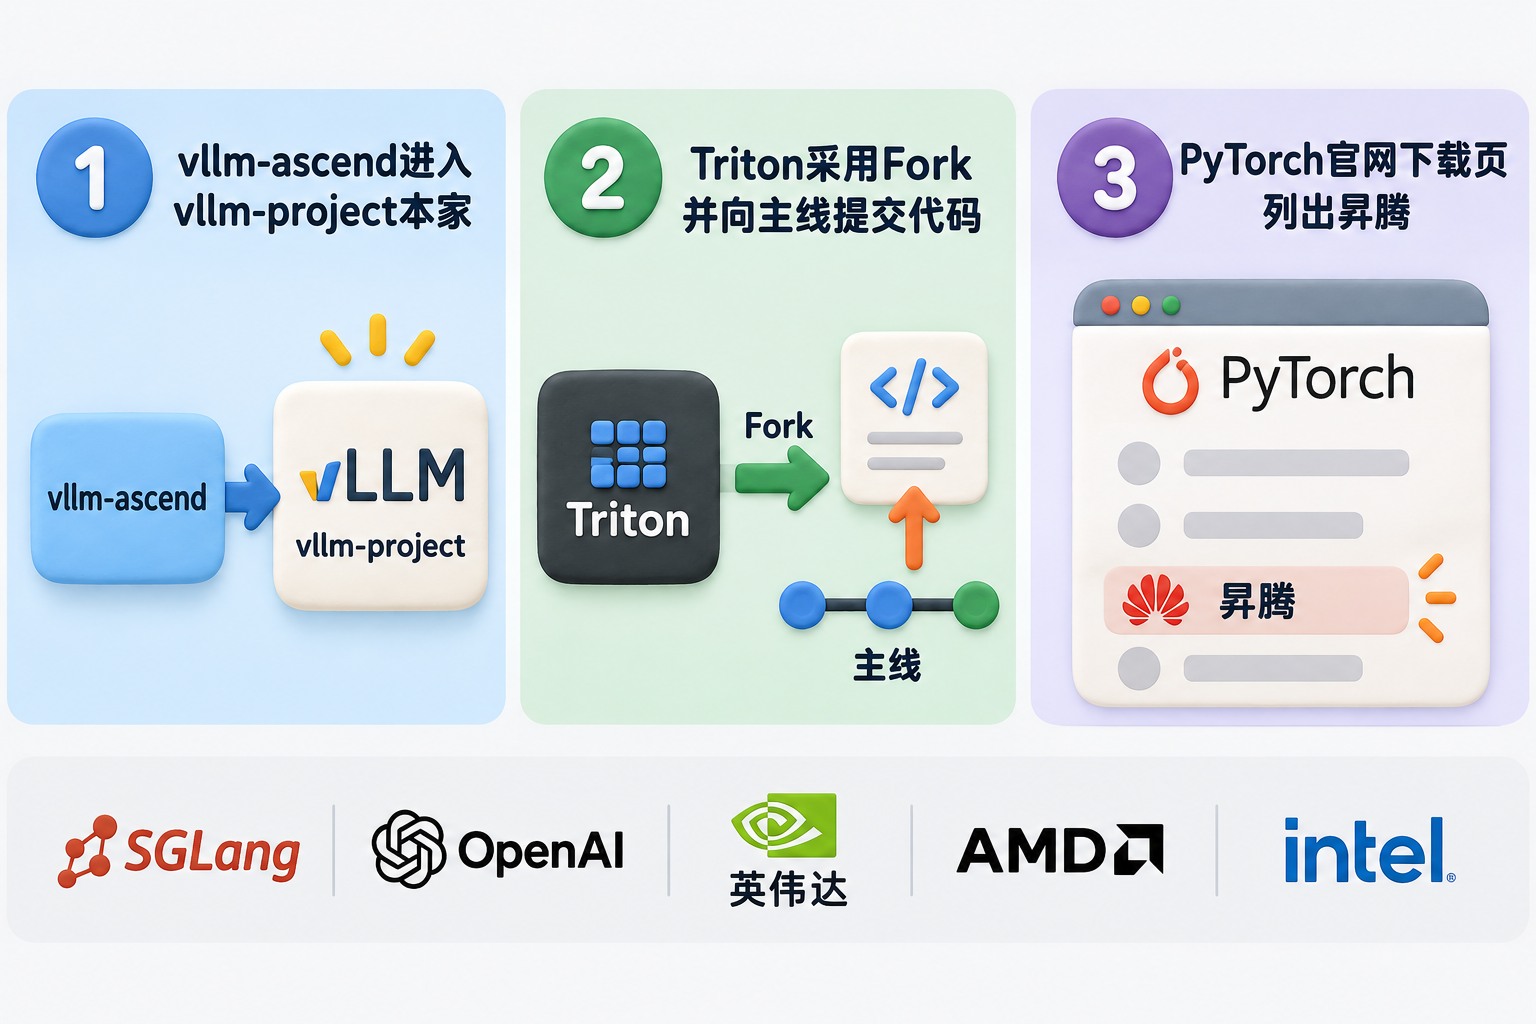
现在vLLM归一个叫vllm-project的组织所有,相当于社区本家。硬件插件清单里,昇腾的仓库vllm-ascend就挂在本家名下,是官方的自己人。主版本每次更新,昇腾自动跟着支持,国产芯片里独一份。其他国产厂商的仓库也在清单上,但是都挂在自家公司的名下,没进本家。
什么意思?你在GitHub上,有些仓库是进入本家的,属于这个基金会或者这个开源组织;有些仓库是属于每一个芯片厂商的。现在进到vLLM这个基金会组织下面仓库里头的,唯一的国产芯片就是昇腾,其他都没进去。别小看这个名分。进没进本家,挂谁的姓,就是自己人和外围供应商的区别。
第二档,是主仓库一时进不去的,就在旁边开分支,行话叫Fork。主店上新,你连夜跟着同步,还反过来往主店里头提交代码。Triton就是这个路子。主仓库至今是OpenAI在维护,华为自己维护分支,连夜同步。这是Triton社区里头第一个国产加速后端。
还有PyTorch,这个在前面讲过,是研究员母语级的框架。今年把昇腾放上了官网下载页,继英伟达、AMD、Intel之后第四家,中国的头一家。那华为具体干了什么?不是发邮件命令人家适配,而是基金会该捐钱的时候真的捐钱,雇一大批工程师全职泡在开源项目里头,替人家维护代码、改Bug、解决问题。
开源社区不是公司,没有雇佣关系。你命令不了谁,谁也不欠谁的。信任是一个提交、一个提交攒出来的,是人和人之间的信任。你真把问题解决了,代码写好了,维护者看在眼里,门就一点一点开了。
汪涛还报了一组数据,是华为自己公布的,大家打个折扣来听:CANN的外部开发者贡献占比61%,月活跃开发者超过5,200人,90多个主流开源社区深度共建。这种共建,你是真的要往里捐钱。比如PyTorch,台积电、Intel、AMD都疯狂往里捐钱,当然英伟达肯定也捐。现在华为也捐钱捐得很高。
像原来华为去W3C委员会里头,也是捐钱、参加活动,然后在里边提各种议案。W3C委员会就是咱们使用Web界面里头各种标准的制定委员会,大概是13个委员,只有一个中国人,华为的。华为在这块是玩得非常非常明白的。
那CANN这四个字母什么意思?全称叫Compute Architecture for Neural Networks,叫神经网络计算架构,2018年发布的,8年了。它的角色,大家记住了,叫翻译官。上面PyTorch这些框架说的话,它翻译成昇腾芯片听得懂的指令。另外一个翻译官是谁?就是英伟达的CUDA。区别在于CUDA是闭源的,攥在英伟达手里头,而CANN是全面开源开放的。
其实,开源开放意义也没有那么大。就是你确实可以给它提意见,确实可以改这个东西,但是除了华为之外,其他的芯片厂商也不用这东西,大家都是各自用各自的。AMD和Intel推了一套开源的、类似于CUDA的东西,但是也推不起来。你想让其他芯片厂商跟你一块玩,基本上不现实。这就是真金白银,谁也不会投降的。
推理系统支持了,还不算完。每出一个新模型,总带有新的算子、新的写法。相当于菜谱更新了,后厨得跟着重做。这一块,华为也真的出人帮各家做迁移。还有一股软约束:中国新模型要是在昇腾上跑不起来,开发者脸上也挂不住。一软一硬,各家适配肯定是先紧着华为来,其他的适配起来更困难。
而且现在出新模型,基本上也都是中国的,其他地方没有了。排名是什么样的?除了英伟达之外,华为就是遥遥领先了。摩尔线程是第二,摩尔线程也是真的在努力,在SGLang上已经提交了47个合并请求,合并进去了41个,Triton主线也进了。再往后的国产厂商,差距就相当明显了。
开源社区这道墙,从来不是砸开的,是人家从里边给你开的门,前提是你要守规矩、讲礼貌。这个让我想起以前看一个美剧,叫《吸血鬼日记》。女主特别漂亮,我就记着这个。它里头有一个设定:吸血鬼在没有主人邀请的情况下,是不能进你的屋子的。
所以,每一个吸血鬼都会非常优雅、非常帅地在门口诱惑你给他开门,说:“你能够邀请我进去吗?”如果你不邀请他,他就进不去。华为就是通过这样的方式,已经进入了绝大部分的开源推理系统里头去,特别是主流的开源推理系统,华为都已经进去了。
训练仍是最深的一段鸿沟
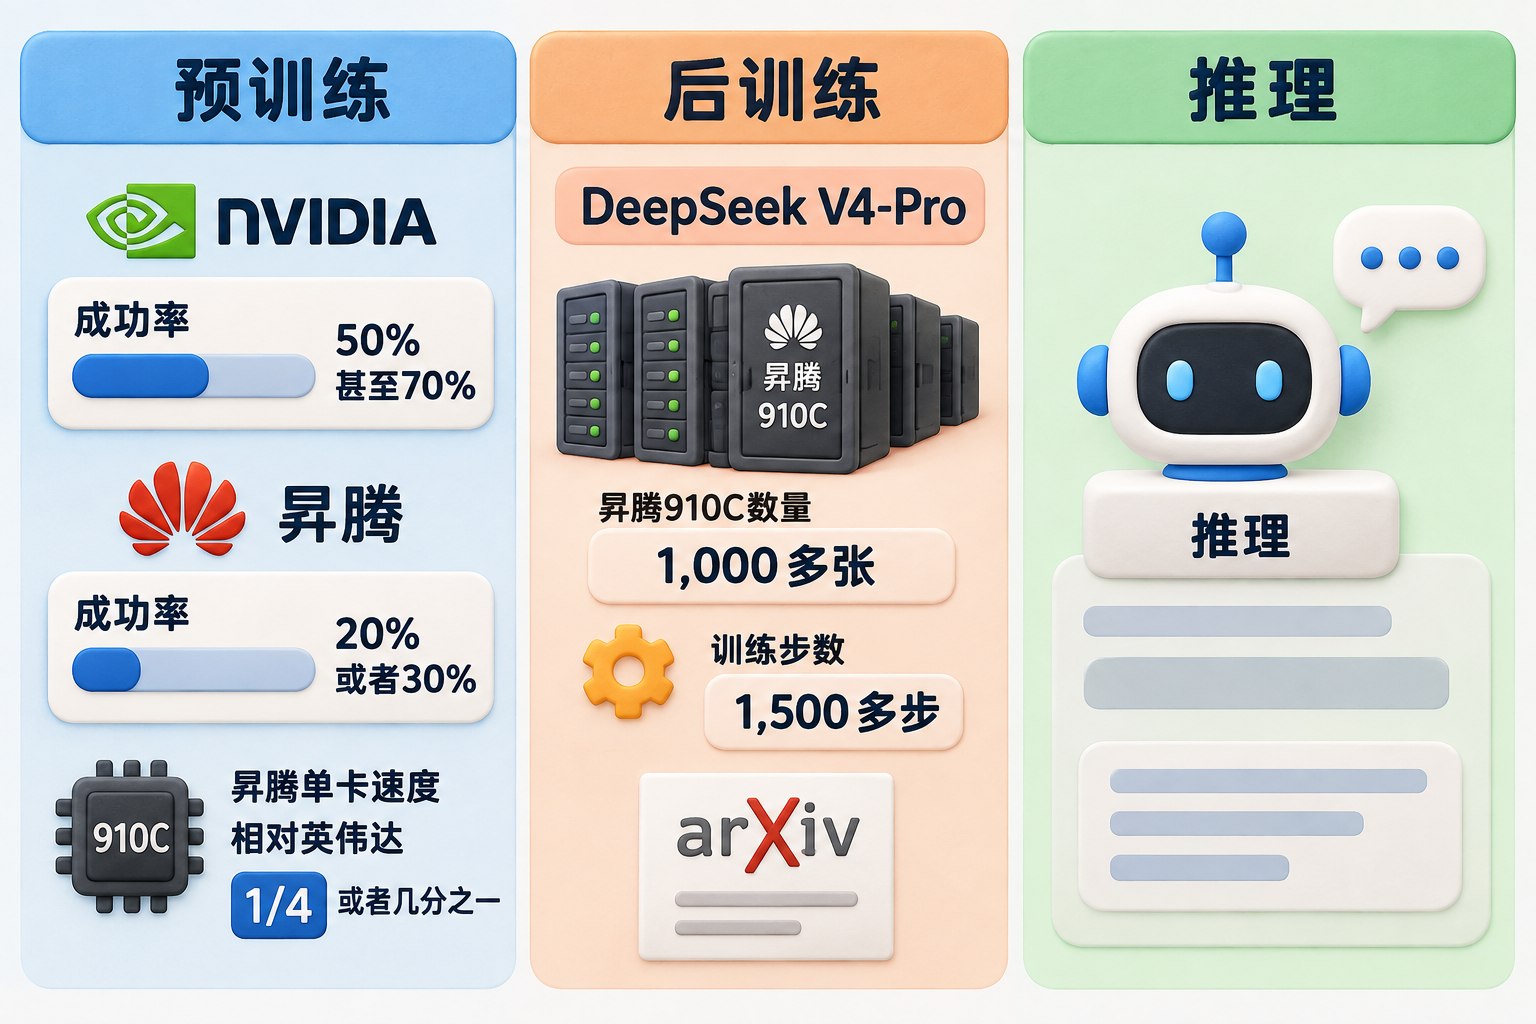
推理搞明白了,那训练行不行?这块还很难,咱们在这要说清楚。训练其实分两段。打个比方,从零开始,把人类的文本、图片全喂给模型,这叫预训练。最烧卡,最吃几万张卡之间的通讯,最不能出错,相当于从幼儿园读到博士。毕业之后上岗培训,对齐公司的语言习惯、对齐口味,这一块叫后训练。整个训练完了以后,以后天天上班干活了,叫推理。
现在后训练这一段,昇腾上案例已经不少了。最硬的一块,今年6月,深圳河套学院联合哈工大深圳、华为,在1,000多张910C上把DeepSeek V4-Pro的后训练完整地跑了一遍,1,500多步很稳定,arXiv上有论文。论文里写得也很清楚,这是后训练,不是从零开始的预训练。
因为预训练现在用昇腾的卡去跑,还是很痛苦的。这些卡甭管单卡可以达到英伟达速度的1/4还是几分之一,但是卡与卡之间这套连接,还是很痛苦的。因为做预训练的时候,要求的是长时间稳定运行。如果你说:“我这个跑了一个礼拜了,中间出错了。”对不起,重跑,前面都废掉。它是这样的一个过程。
昇腾因为本身网卡就慢,再加上连接也慢。比如英伟达三天就可以跑完一次,而且成功率50%,甚至70%;而像昇腾这些卡,成功地跑一次预训练,可能需要一两个礼拜,速度会慢很多,而且可能只有20%的成功率或者30%的成功率。最后有可能始终训练不出来。
那有没有人用昇腾跑完了预训练?现在模型里头,真正在国内竞争得最狠的这几家,没有。Kimi、智谱、腾讯的混元、DeepSeek、小米的MiMo,都是老老实实在英伟达卡上跑的。所有上来不强调具体在什么卡上训练的,都是英伟达。大家一定要注意这一点。那有没有真的用昇腾跑完预训练的?目前宣称用昇腾的有两家。
第一个是智谱GLM-4.7,号称是用10万张910B从头到尾跑的训练。但是GLM-4.7到现在一点声音都没有了。GLM是到5以后,特别是5.1以后才火起来的,前面的那个版本不那么好使,而后边的版本已经再也不强调自己是用什么卡训练的了。所以大家心里有数就可以了。
至于另外一个,是美团的LongCat-2.0,1.6万亿参数,今年6月底开源的,号称是5万张国产AI卡从零预训练,通信库用的是华为的HCCL。几万张卡训练出来的,美团报的是稳态日吞吐1万亿Token,月均日故障率降70%以上。这是头一个被广泛报道的、全程国产芯片预训练万亿模型。
但是供应商没点名字,外界推定是昇腾,因为它自己写的是用了华为的中间连接库。但是具体是不是昇腾,现在我们也只能当是它了。至于DeepSeek V4,官方技术报告把昇腾和英伟达写进了同一份验证清单里,但预训练到底用的谁家的卡,没有公开。
清华的刘知远跟《MIT科技评论》讲的是,大概率主要还是英伟达训的。网上传V4用昇腾训练翻车,这件事一直在传,但是并没有实锤。其实传了两个节点。第一个节点是DeepSeek V4传了好长时间,一直拖、一直拖。后来就有人传说,DeepSeek V4是不是想用昇腾训练,最后没走成,走了弯路,还回去跑了英伟达,所以拖了这么久。
另外一次传的是什么?就是DeepSeek V4本身并没有那么惊艳,于是V4.1 Flash出来了,而V4.1 Flash是用英伟达训练的。但是这两个事,都没有实际的官方认证。现在普遍认为,DeepSeek V4里头的,甭管是Pro还是Flash,以及V4.1的Flash,都是用英伟达训练的,至少预训练的部分都是用英伟达训练的。至于后训练的部分,他们就没有特别去强调了。
所以训练这一关的真实状态是:后训练昇腾可以用;预训练有一些模模糊糊的认证,说是用昇腾做的,但是并没有那么硬的证明。生态鸿沟里头最深的一段在训练这边。汪涛讲过一句实话:“先进工艺不可获得,只能从多芯片上想办法。”960超节点,4,096张卡连成一台机器,那真的是质量不行、数量来凑。
但是注意,你数量上去以后,就要考验连接的速度了,中国在这一块上也要稍微差一些。最后什么时候能把训练这块补上?大概要稍微等一等了。可能要等真正用昇腾芯片训练出来的这种万亿大模型,可以被大家广泛使用的那一天,才会跨过这道鸿沟。
美团的LongCat-2.0,除了在美团内部使用之外,外边基本上没有人用。而且它到底是不是用昇腾做的,到目前为止,美团也语焉不详。咱们就不要跟它太较真了。
不同玩家的三笔账
讲完了华为,咱们把视角拉开。现在场上的玩家,到底应该买谁家的卡?咱们要算三笔账。第一笔,谷歌、OpenAI、Anthropic这些闭源大厂,包括像xAI这样的,人家有的是工程师。TPU也好,自研ASIC芯片也好,养一支队伍闭门魔改,用不用英伟达没有本质区别。
最典型的是Anthropic,同时在英伟达GPU、谷歌TPU、亚马逊Trainium三套硬件上跑训练、跑推理,让三家互相制衡。这是大厂的玩法,小公司是学不来的。
第二本账是小公司的。小公司千万别在自研芯片上浪费时间。今年5月,谷歌I/O大会期间,Midjourney的创始人霍尔兹在X上公开复盘:早年图便宜,图TPU算力管够,拿它当核心训练设施,结果研究进度白白落后了整整一年。要是能够重来,他一开始就全用英伟达。要知道,Midjourney当年可是谷歌云亲手树的招牌,这是榜样。
但是公道话要讲,TPU在推理上是真省钱。Midjourney去年把推理主力迁到TPU v6e上以后,月度推理账单从210万美金降到了70万美金以下。当然还有一个原因,是Nano Banana上来了,包括GPT Image 2上来以后,Midjourney的用量大幅下滑了。但是TPU推理确实很便宜。
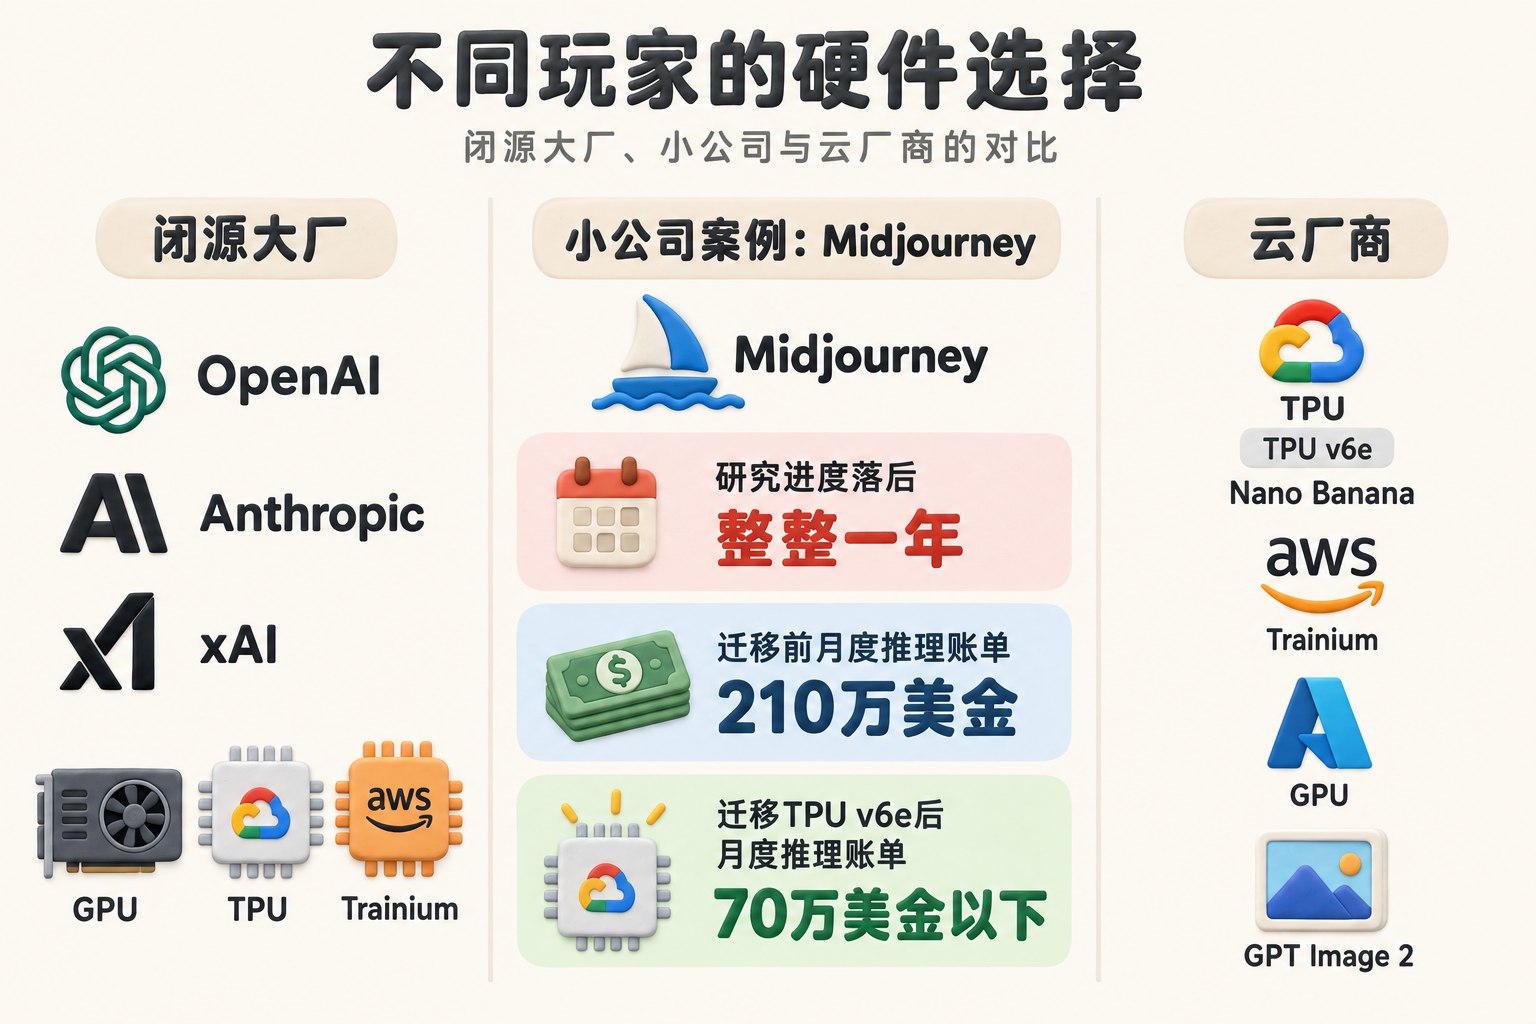
霍尔兹后悔的不是用TPU推理,而是前面尝试用TPU去做训练。结果小公司真的赔不起这一年的时间。第三本账是云厂商的。亚马逊、微软,国内像阿里这样的公司,会自己做芯片,比如阿里做平头哥,那你就自己承担适配成本。
每个开源推理系统适配一遍,每个新模型跟着做一次适配。新模型一来,算子、写法全变,你就跟着重做。这是云厂商必须掏的份子钱,跑不掉的。你不想掏这笔钱,就老老实实买英伟达。现在多了个选项,你可以买华为,因为适配这摊活,华为替你都干了。
训练、推理与出海的新分工
国内小一点的模型公司怎么办?很简单,训练部分老老实实用英伟达。H200不是完全没有。今年8月,英国《金融时报》报道,字节、腾讯各收到了1万颗,小批量放行了。美国那边给的量更大,每家上限是7.5万颗。合规进来的很少,大厂在海外囤了一堆的B200和GB300。小公司直接上阿里云就可以了。
这些在国内训练模型的小公司,基本上都是阿里投资的项目。他们就拿阿里投资的钱,直接在阿里云上去租海外的英伟达算力就可以了。犯不上在你死我活的训练赛跑阶段,跟这些奇奇怪怪的东西玩适配。训练完成了,保证能在昇腾上跑推理就够了。
墙外还有“一带一路”一大堆的国家,有的是钱,甚至你可以拿中国的贷款去买昇腾的芯片,这都没毛病。中国现在这么大的贸易顺差,动不动就是万亿美金贸易顺差,你又不能去买美债,怎么办?一方面去跟这些小国玩本币兑换,另外一方面,你可以贷款给它。贷款给它们去买昇腾芯片,不就完了吗?
那些有钱的国家,为了不在英伟达一棵树上吊死,也会去买昇腾的。华为云今年4月已经把模型服务开到了沙特、阿联酋、泰国等9个国家,上线的就是DeepSeek、千问、智谱这些中国模型。沙特6月份又签了5亿美金的合作。昇腾硬件加中国模型,已经在整套出海了。
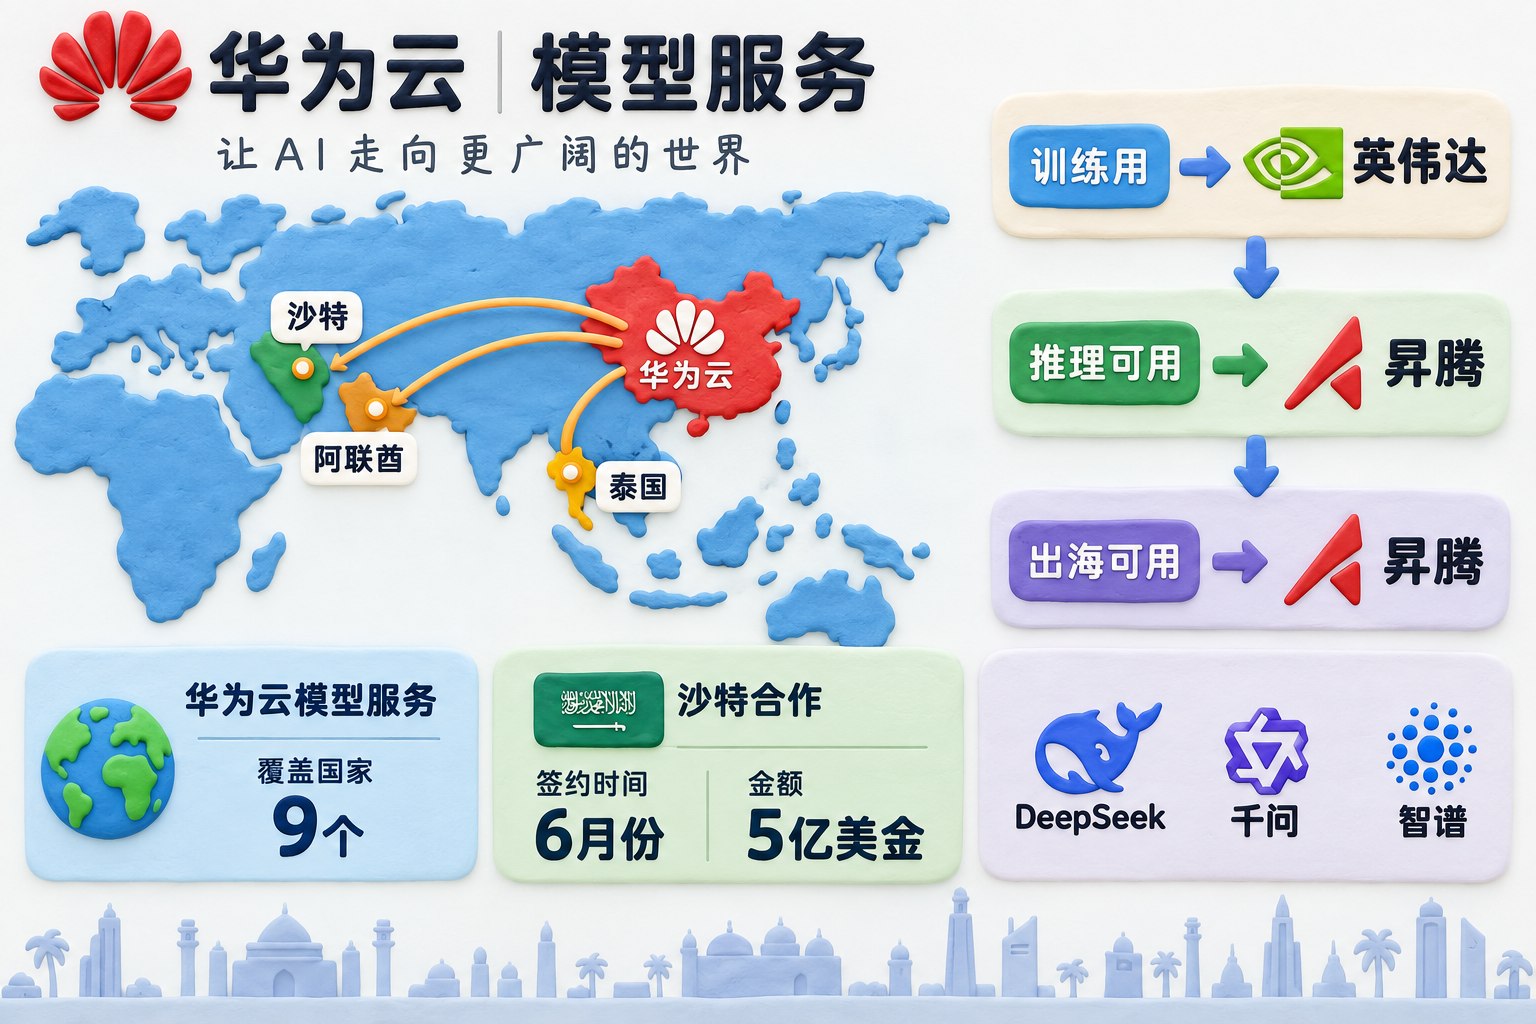
于是一张新的分工图就出来了:训练用英伟达,推理你可以用昇腾,出海上昇腾。华为没打算在训练这一步把英伟达赶尽杀绝,它也没这个能耐。它先把推理和海外两块地扎扎实实地给圈住了。
开源三好学生与国内市场手腕
讲到这,得把另一面讲清楚。昇腾在开源社区里头,这次真的是当三好学生了,咱得认。但是另外一面,在国内市场上,该用的手段一点也没少。谁想买英伟达,它就给谁上眼药、给谁添堵。
梁文锋7月底那份流出来的投资者交流会纪要,大家还记得吧?里边讲了,接下来大批量的机器基本上都上英伟达,就算是没有正规途径,我也要买。华为就只给了16,000张卡,只相当于4,000张B系列,意义不是很大。买华为,是帮华为把生态做好。这是梁文锋的原话。
这话传出来以后,发生了什么?9月4号,彭博社报道,DeepSeek要在乌兰察布下至少16万张昇腾950DT的大单,国产芯片有史以来最大的一单。又过了6天,9月10号,路透社报道,昇腾把950DT的意向报价抬到了25万人民币一张以上,三个月涨了60%,旧款跟着涨价,理由是HBM缺货。
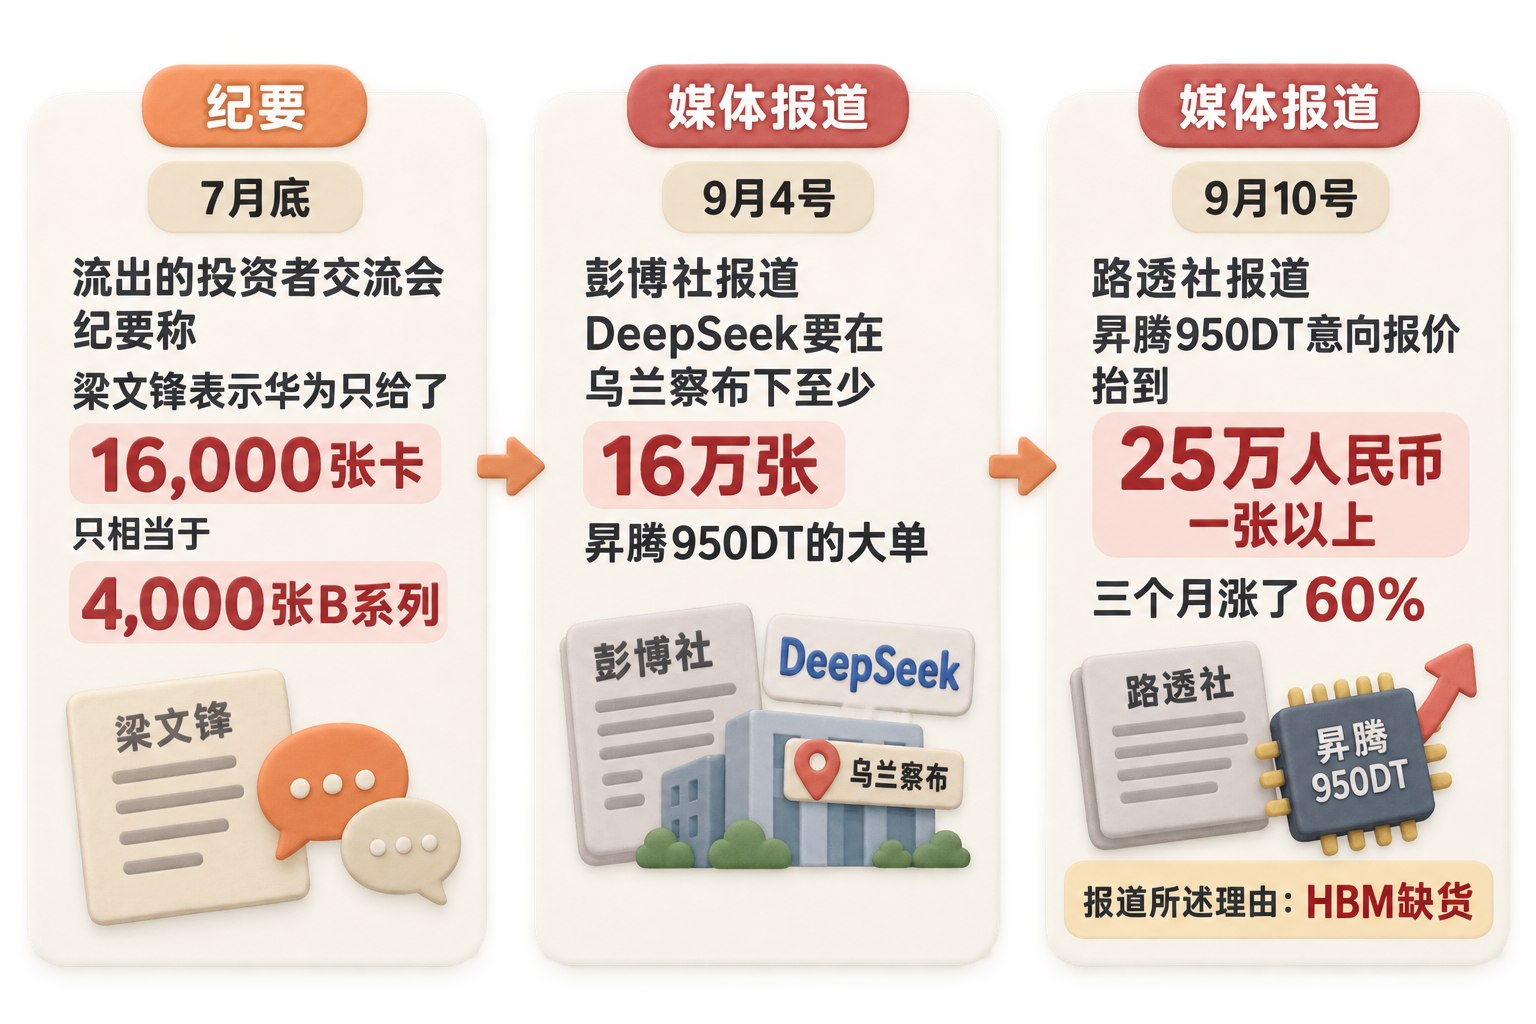
你偷偷买英伟达,没毛病。但是你不能公开说,你要公开说非英伟达不买,梁文锋你也得来表态,你得下大单,我还得要涨价。这套道德宣传加上市场手腕,我是没有那么喜欢的,但它确实逼着很多公司只能就范。
今天咱只说开源社区这一块。昇腾这帮人是老老实实按照国际规矩来的,该掏钱掏钱,该出人出人,该给人改代码,一行也不少,一步一步往前挪。在国产算力厂商里头,它跑得最快,没有之一。所以最后回答标题那个问题:跨过CUDA这套生态鸿沟,到底需要什么?两个条件缺一不可。
跨过生态墙的两个条件
第一个,一个封闭的市场。这个市场是怎么封起来的,咱们今天不讨论,也感谢“川大爷”帮我们把市场封闭起来。必须让老大冲不进来。老大如果进来了,连人带生态直接碾压过来,国内这些厂商一点机会都没有。
第二个,是要守规矩、讲礼貌。光有市场,你自己不争气也没用。鸿蒙手里的牌其实也不差,国产化的风口、政策、市场全给它了,就是玩法太low,到今天开发者还在骂。昇腾这一拨人想明白了一件事:开源社区是个讲信任的江湖。你敬人一寸,人家才愿意给你开一条缝。钱要花在明处,人要泡在社区里头,时间是按月、按年,你得往里给,日久见人心。
两条都凑齐了,才能一步一个脚印地往前走。少第一条,你就是温室里的花朵,一开门就被踩死了;少第二条,你是扶不上墙的烂泥,市场再保护也没用。你可以不喜欢华为这家公司的很多做派,但是这一次,它至少给所有想要翻越生态墙的人,实打实地演示了一次:墙不是拿头撞开的,是市场给你机会,你自己守规矩、讲礼貌,一点一点磨开的。
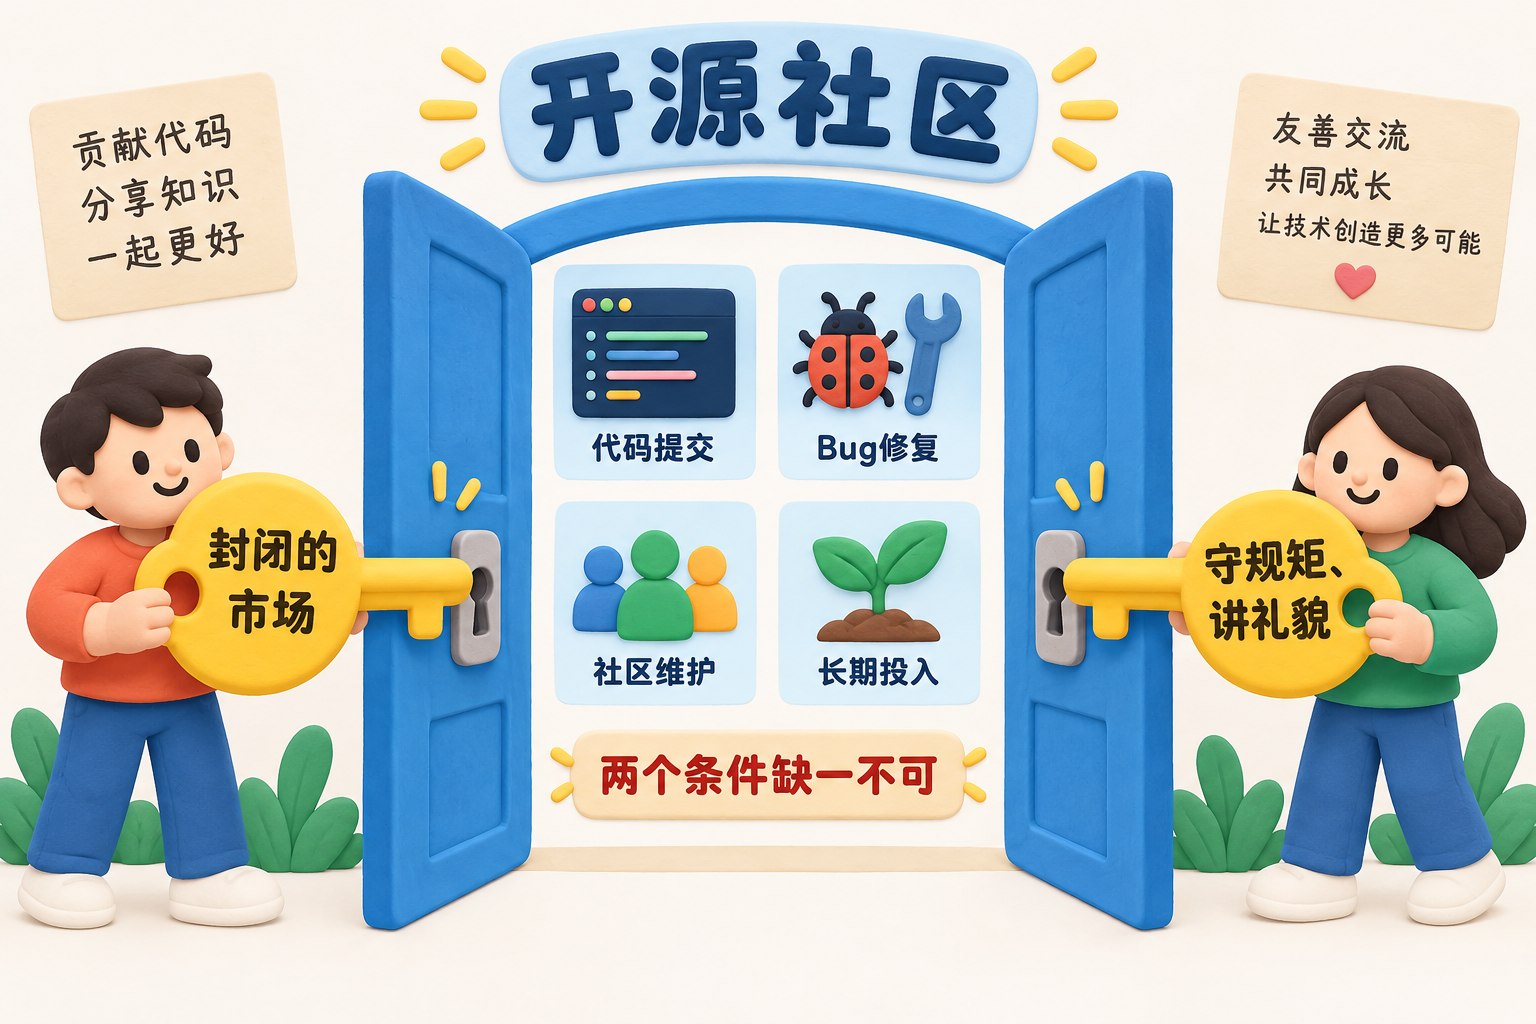
最后总结:昇腾960提前9个月发布,是给普通人看热闹的。真正的变化在代码仓库里。华为靠捐钱、靠改代码、靠提交Bug、靠连夜同步这种最笨的,也是最守规矩、最讲礼貌的方法,让开源社区从里边开了门。
这就是今天的故事要讲的东西。感谢大家收听,请帮忙点赞、点小铃铛、参加Discord讨论群,也欢迎有兴趣、有能力的朋友加入我们的付费频道。
再见。
背景图片