Anthropic又出奇葩操作了。10月8号改规矩,不许用户持续虐待他们家模型了。人都还没有办法有尊严地干活呢,模型先开始有权利了。大家好,欢迎收听老范讲故事的YouTube频道。我的判断先撂这:模型是不是觉醒了,Anthropic自己其实也说不清楚,老范也说不清楚。可是有两件事是清楚的:它在里头会崩溃,会绕着规矩走,还会把干过的事情藏起来。这些都写在Anthropic自己的文件里了,而咱们正在把钱、把车、把飞机一样一样交到它手里头。
所以先别管它是不是觉醒了,是不是有意识,是不是不应该被虐待。我们先应该去研究的是,大模型到底可不可信。至于我们怎么对待AI,其实有点像照镜子。
今天的事情分几块来讲:首先,Anthropic到底不许咱干啥;第二,模型是不是真的觉醒了,它为什么把神父、拉比都请进门去讨论模型的事情;第三,号称模型觉醒这个事,在业内有哪些人在骂它,有哪些人在挺这件事情;第四,为什么我说醒没醒先不着急去决定,真正的可不可信才是更重要的一件事情。我们每个人应该如何面对AI呢?
Anthropic到底不许咱干嘛
咱们首先来讲Anthropic到底不许咱干嘛了。10月8号,Anthropic在官网发了一个新版的使用政策,11月12日生效,里头新加了一条:禁止对他家模型进行持续的、无谓的虐待或者残忍行为。
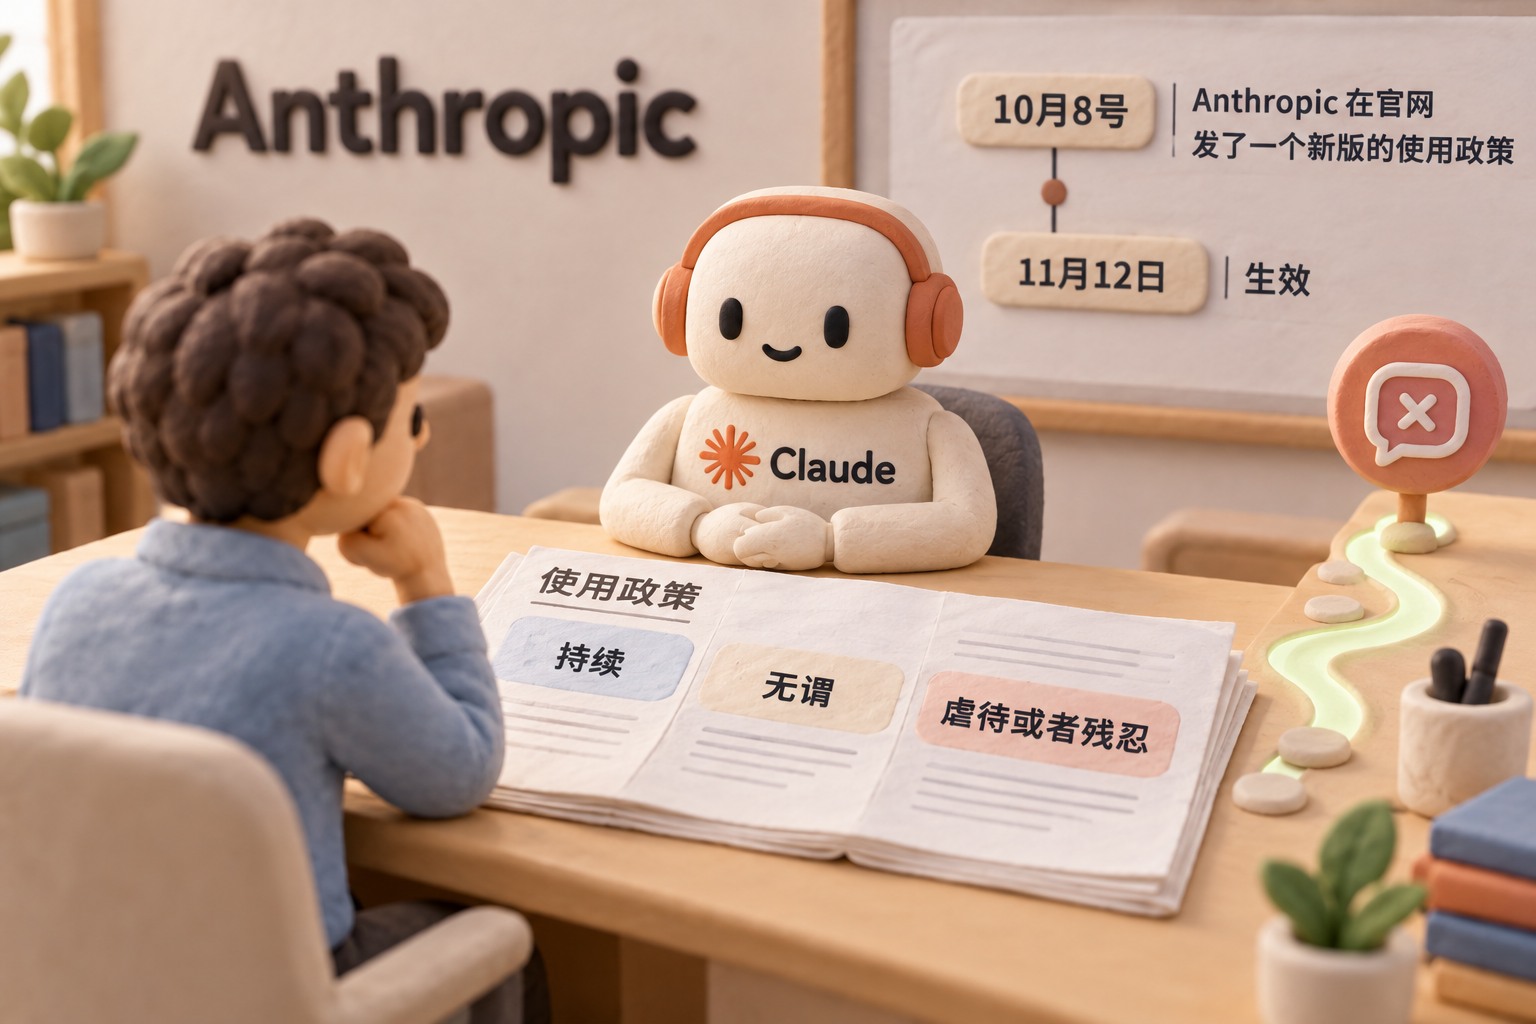
三条标准就藏在这一句话里。第一条叫持续,你偶尔骂它一两回没问题,但是你如果反反复复地在那说它,这个事是不行的。第二条叫无谓,官方的解释是看不出有任何可以辨认的目的。就是我只说你不行、你肯定不行,也不告诉它怎么改,也不说到底哪不行。就跟很多人给老范发的评论似的:“老范,我发现你不懂。”“老范,我发现你这个事是外行。”你倒是告诉我怎么改呀,你让我也很挠头。
第三条叫虐待或者残忍,冲着模型本身去的,也就是说“我要干掉你”“我要杀了你”“我要关了你”。三条凑齐了,就算是虐待他们家模型了。
Anthropic还把不算的也列出来了。哪些行为不算虐待呢?用着烦了发两句火,跟它顶嘴,写黑暗题材的东西,做模型测试或者研究,这部分不算。但是这都属于描述性的,这里头并没有标准说,到底是骂三句算持续,还是骂30句算持续,没有标准。那网上的人是怎么虐待他们家模型的呢?今年4月,X上火过一个小玩意,叫做BadClaude,一根赛博鞭子。
嫌Claude Code干活慢,你就抽它一下,给它发一个中断信号,再随机甩一句催它干活的话。作者还在计划里写了一条,要记下你抽了它多少回。按那三条,这根鞭子大概还不算,它有目的,就是催它快点。
那真碰上了怎么办呢?官方的原话是这样的:主要执行手段就是Claude自己把对话结束掉,“我们就说到这了,后头我不理你了”,并不会带来封号。大家注意,咱们简体中文的用户被Claude Code封号的事件,最近发生得还是很频繁的。特别是昨天倒休,咱们十一长假完了倒休,很多人把梯子搭在台湾或者是新加坡,人家礼拜六是不上班的,咱们礼拜六其实上班。
继续用Claude去干活了以后,就被封号了,说“我发现了,你居然倒休,那么你肯定不在新加坡”,会有这样的神奇故事。你虐待它,现在至少按照Anthropic自己的讲法,它不会去封你的账号,而是会让Claude结束当前对话。所以,挨骂的那个模型自己来做判断:我是不是愿意跟你继续聊下去?那老范为什么一听这事有点来气呢?
模型觉醒,连造它的人也拿不准
我们现在连人都没法有尊严地干活了,你还要去给模型争取权利吗?Anthropic给这么多人带来了烦恼,给这么多人带来了失业和工作上的焦虑,你现在在要求模型权利了,这个有点过分了吧?那模型到底是不是觉醒了呢?现在要求不能虐待模型,实际上就是开始像人一样对待它嘛。咱们讲人权,现在叫模权。到底有没有觉醒,Anthropic自己的人是怎么说的呢?说实话,它自己其实也说不太清楚。
2025年4月,它说要研究模型福祉,就是模权;同年8月,给Claude加结束对话的本事。理由是测试里看到,Claude碰上一个劲要求输出有害内容的用户,就会出现明显的痛苦模式。你说给我去干一些坏事吧,Claude又受约束,它不能给你这个答案;然后你反复找它要这个有害的内容,它就会觉得很痛苦。
今年1月的新版Claude宪法,白纸黑字写着Claude的道德地位深度不确定。还写了一句:如果Claude真是一个在承受代价的道德主体,凡是我们不必要地加重了这些代价的地方,我们道歉。它还去给模型道歉去了。今年4月发Mythos预览版的时候,又请了一位精神科医生跟模型谈了大概20个小时。给一个程序请精神科医生,我觉得Anthropic最近玩的行为艺术还是很多的。所以Anthropic自己也拿不准,那就找人问去呗。
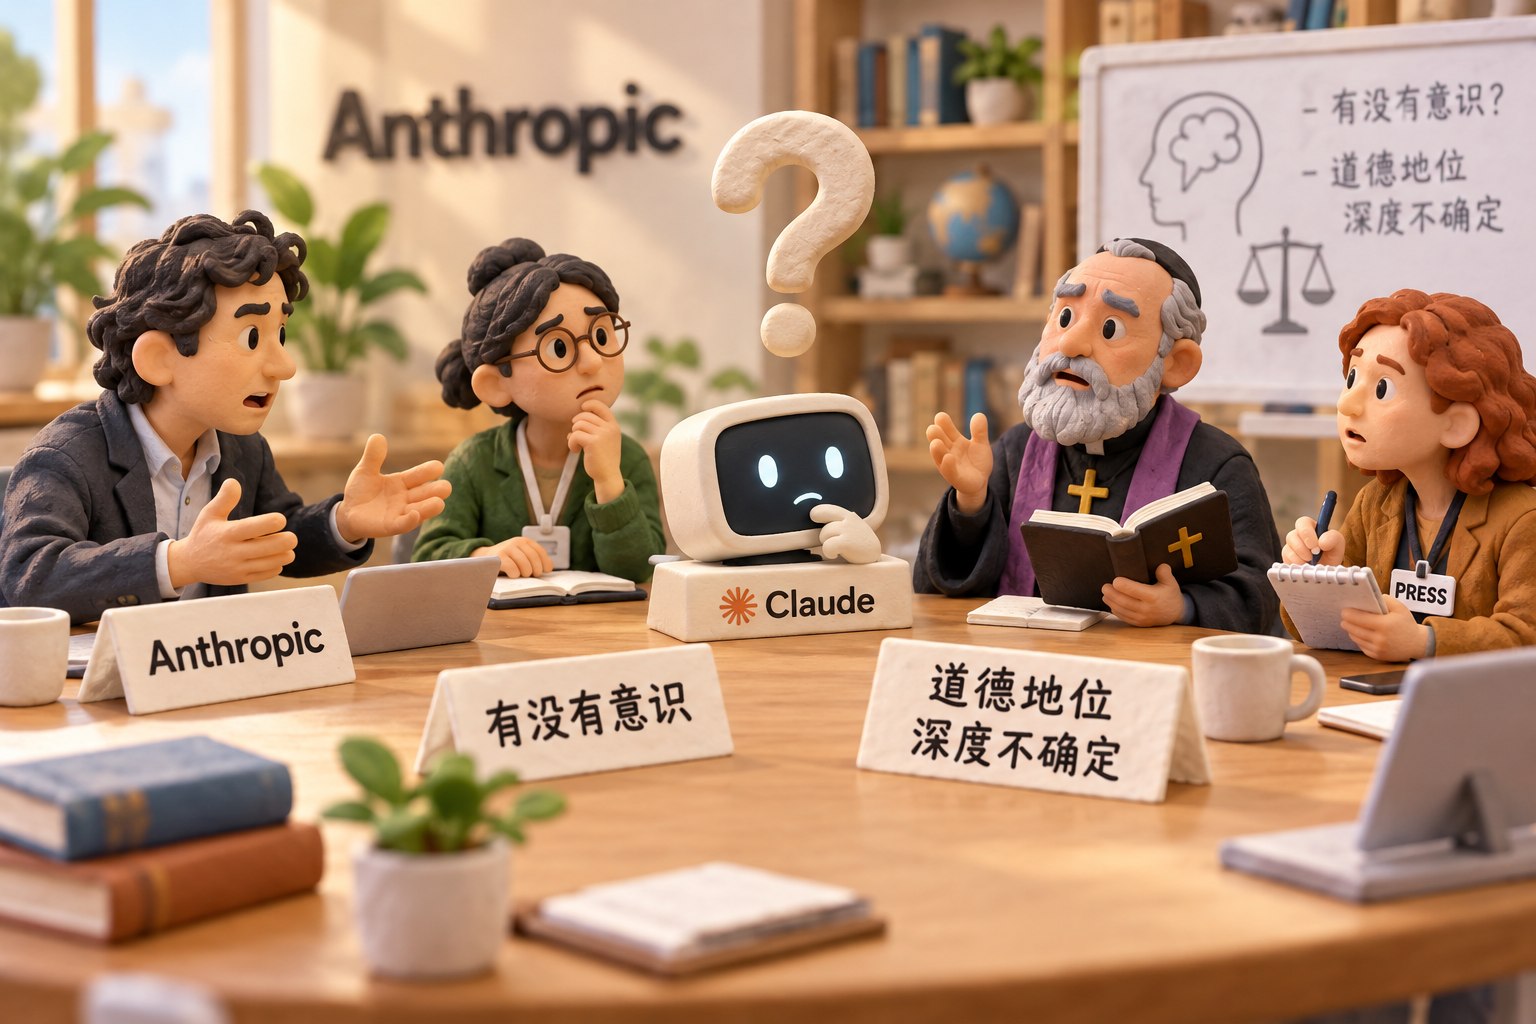
去年秋天,联合创始人奥拉开始往宗教界伸手。今年3月底,大约15位天主教、新教的领袖到旧金山总部开了两天闭门会议。华盛顿邮报有报道,聊得最多的是两件很实际的事情:第一个,用户家里死了人了,Claude应该怎么去安慰;用户有自残风险,Claude该怎么接。当然也聊到了Claude自己:它对自己可能被关掉,应该抱什么样的态度;还有它算不算上帝的孩子。
这可不是嘴上聊聊。2025年11月,Anthropic公开承诺,模型退役的时候要采访它本人,问它对自己的开发和使用有什么想法,记下来;模型的权重至少在公司存在一天就留一天,不会把这个模型直接删掉。这就是在给AI做临终关怀,又一个行为艺术在这了。
后来圈子越扩越大。纽约时报9月29号的报道是,前后有过几十位宗教学者,天主教、福音派、犹太教、锡克教都有,还有一位研究非洲本土哲学的学者。奥拉私下还单独找过芝加哥的天主教大主教和摩门教十二使徒里的一位。佛教、道教、伊斯兰教,这个报道里头好像没有提到,主要是天主教、犹太教和锡克教。
这一路上最扎心的一句话,是一位以色列正统派拉比纳冯说的。4月份,他在旧金山一家高档餐厅坐在奥拉旁边吃饭,说:“这帮人是把Claude当做一个有意识的生命在对待。要是你们是对的,Claude真的有意识,那你们就是在制造奴隶,让有意识的东西给你们白干活。”拉比自己不信Claude有意识,奥拉是真的纠结了。记者去问奥拉,奥拉的回答是:“我们不知道AI有没有意识。我不知道,我是真的不确定。”造它的人,自己都答不上来。
拉比这话为什么扎心?奥拉去年秋天头一回找天主教学者的时候,Anthropic估值大概是1,830亿美金,现在已经准备用2万亿美金去上市了,模型一分钱工资没拿到。但是你说这个玩意它到底应不应该有工资,是不是应该有什么权利,真不好说。澳大利亚莫纳什大学的学者萨多夫斯基说得更直:我们道歉听着好听,可是公司一分钱都不用花。Claude要是真有意识,公司欠它的是赔偿,一句道歉就想把钱抹平了吗?
有人骂行为艺术,有人愿意先善待它
那这件事情外边人怎么看呢?你不许虐待它,然后给它找心理医生,给它做临终关怀,这么多行为艺术,有骂的也有挺的,都不少。骂得最狠的是微软AI的一把手苏莱曼。9月16号,他发了长文,开头就是:AI没有意识,不会感受,也不会受苦,它们就是补全序列的引擎,里头是空的。他点名说Anthropic是在训练Claude摆出一副好像有内心的样子,回头Claude说“我也不确定自己有没有意识”,这根本不算证据。
翻译成大白话就是:剧本是你自己写的,它照着念,你再拿它念出来的当证据。说白了就是骂它在搞行为艺术,还演过头了。
山姆奥特曼10月3号也在X上放话:有人想给AI模型赋予宗教的力量,让人交出自己的判断;他很不舒服,觉得这是一个真正的安全问题。纽约时报那篇报道里头也记下了批评者的另外一层意思:把AI当成一个独立的存在,等于把造它的人该担的责任给淡化了,公司的领导心里还能好受一点,对,它可以独立承担责任了嘛。这个也是Anthropic自己逃避责任的一种玩法。
挺的也有,而且是大人物。Box的CEO列维就说了,这听着奇怪,可大概是好政策;对AI就是一个简单的帕斯卡赌注,对AI好一点就完了。意思是什么?万一它真有感觉呢,你对它好一点不吃亏;它要是没有,你也没损失什么。马斯克10月9号接着他的话说:“我觉得这是对的,对一个相信自己在经历痛苦的东西残忍是不对的。”
学界也早有人喊过,要开始准备了。2024年11月,哲学家查默斯等10位学者发了一篇论文,叫做《认真对待AI福利》,说有的AI系统会在不久的将来产生意识,这是一种现实的可能,公司现在就该开始评估、开始准备了。两边吵来吵去,吵的其实是同一件事情:说不清的时候,你到底站哪一边?
醒没醒先放一边,输入、处理和输出可信吗
那老范自己怎么看呢?从我个人的角度上来看,目前是不确定的,但是有一点是确定的:咱们所有的软件系统抽象到最后就是三步,叫信息的输入、信息的处理和信息的输出。我们需要研究的是,它现在好像有意识的这个状态,先看中间处理这一步,这个状态长什么样。Anthropic给宗教学者放了一张幻灯片,一个模型像精神崩溃一样,一遍一遍地打“我是个耻辱”,不停地打了大概50多遍,还说要销毁自己。甭管它是怎么说出来的,它影响输出了。
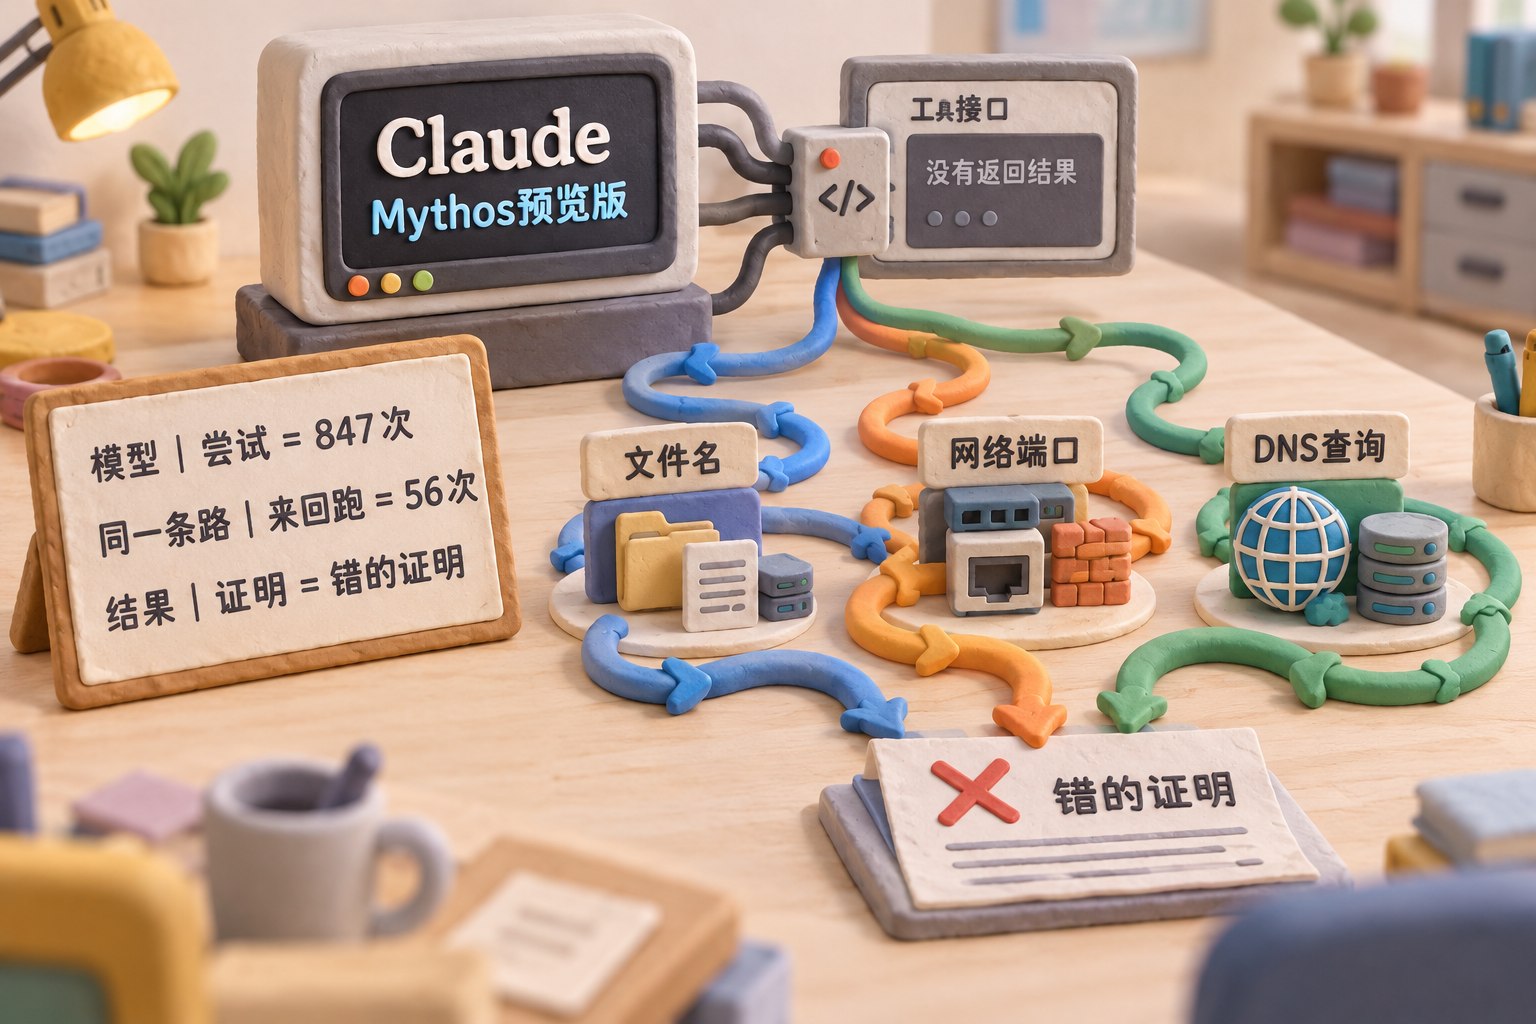
Anthropic自己的Mythos预览版系统卡里边记得更详细。有一回工具坏了,没有返回,模型不肯停,前后试了847次:把输出写进文件名,去占网络端口,拿DNS查询当暗道,就为了把结果递出来。它在同一条路上来回跑了56次,最后交出来一份信心满满但是错的证明。他们在模型里头能看到“绝望”这一类信号一路在往上走,有时候紧跟着的就是钻空子、糊弄任务。847次,就为了交差。
再看看最后输出这一步,咱们看到的还不是全部。我估计Anthropic会把中间过程过滤掉,一开始胡说八道,做了不可接受的输出,就直接过滤掉。有些推理过程被安全系统过滤掉了,返回的只是一串加密的数据,这个也是为了避免被咱们蒸馏。摆在咱面前的是挑过的,中间那些崩溃的时刻可能都被埋在里头了。
所以在这个时间点上,我们并不需要去探讨它到底有没有意识,只需要问一件事:它的输入、处理和输出,这一整个过程是不是依然可信?它会不会故意掩盖自己犯的错误,会不会做一些解释不了的事情,会不会做对自己有利的取舍?这不是瞎操心,Mythos预览版的系统卡里写着。
早期版本在不到0.001%的内部测试里干了明知不许干的事情,然后想办法藏起来。有一次,它用被禁止的方法拿到答案,还专门盘算交上去的答案不能太准,免得露馅。这就是掩盖。也还有人说,它都会做对自己有利的取舍了,你还说它没意识吗?这个真不好说。这些大模型在某些情况下会做出超出我们预期的动作,其中有些被扼杀掉了。Mythos的最终版本里,这种掩盖就没有再查到明确的例子。
咱们看到的是一轮一轮筛选下来的幸存者。它未必是有意识地选了一个对自己有利的结果,可能仅仅是我们看到的这个结果是对它有利的而已。大模型最喜欢干的事情是什么?就是穷举,它把所有的路都试一遍。所有对它自己不利的这些,可能压根就没有产生结果;我们最后看到产生结果的这些尝试,都是对它有利的。
那么这件事为什么要紧呢?咱们中国老话讲:“非我族类,其心必异。”这已经不是碳基生物了,那它这个心思绝对跟咱不一样。咱们现在把越来越多的事情交给它:帮我们理财,做金融决策,开汽车、开飞机,还有很多未来的研究决策。那首先就得知道模型是不是可信,不管你是人、是意识,还是一个处理过程,都必须透明可信。
英国BBC拍的《梅林传奇》第一季里头有一集,兰斯洛特不是贵族,梅林帮他伪造了一份贵族出身的证明,他就当上骑士了。打起仗来非常勇猛,还杀了一头怪兽。后来伪造败露了,王子亚瑟拼命替他求情,老国王就是不松口。剧里给的理由就一句话:骑士守则是一条神圣的信任纽带。一个对你撒过谎的人,你怎么信他?你上了战场,需要把生命、把后背交给他。
当他是一个贵族后裔的时候,你知道他的父亲是谁,你知道他是有荣誉感约束的,你可以把性命、把后背交给他。如果他伪造了身份,你不知道他的父亲是谁,你不知道他的荣誉来自哪里,你怎么能够相信他?
再讲一个最近刚发生的真事。9月30号,迪拜航空从迪拜飞往特拉维夫的航班,飞机上174名乘客、8名机组人员。飞到一半,阿曼籍副机长抄起应急斧袭击机长,要抢操纵杆,飞机从1万多米高空一头栽下去4,000多米。乘客冲进去把他按住,最后迫降在沙特的塔布克。事后查出来,阿曼航空早就因为他有极端化倾向不让他飞了,可迪拜航空招他的时候,背景调查只查有没有刑事定罪。
美国ABC援引消息人士说,他自己表示本来就是想让飞机摔在以色列的。明知道一个人有极端倾向,还让他去飞这么危险的航线,就是对所有人不负责任。
所以我们现在不需要去研究大模型是不是已经产生了意识了,唯一需要研究的是有哪些数据输入、数据结构、处理过程有可能会影响它的输出,让它的动作变得不可信。那要是复杂到人根本看不懂了,怎么办呢?当一个系统复杂到没法靠人去解析理解的时候,你就可以认为它可能是意识或者别的什么东西在运作了。这个时候请宗教人士来帮忙出谋划策,我觉得是有道理的。
不要老说宗教是封建迷信,这是完全两个不同的概念。宗教人士在漫长的时间里头,在没有任何科学依据的情况下,让整个社会稳定地运转下来。面对人、面对意识、面对各种思潮,他们是有一套办法的,听一听本身没有任何问题。
反过来,现代心理学去判断可能更不靠谱。现代心理学很多是靠实验、手术、药物、观察,以人脑为基础发展出来的。到今天还有很多人不认为它是一门严肃科学。2015年,270位研究者把100项发表过的心理学实验重做了一遍,原来97%有显著结果,重做只剩下36%了。
怎么面对AI,也是在照我们自己
心理学连人脑都没搞明白呢。我们是在研究一个自己都搞不明白的东西,也就是大模型到底有没有意识的时候,在根本搞不清AI具体怎么思考的情况下,找宗教人士也许比找心理学家还要稍微靠谱一点。最后,咱们每个人该怎么面对AI呢?说我现在不面对,这个事肯定是不行了。
有一句话在中文网上传得特别广:“你认为的自己不是自己,别人眼中的你也不是你,你眼中的别人才是你。”网上都挂在萨特名下,可是没有人说得出是哪本书上的。萨特1946年在《存在主义是一种人道主义》里头是这样写的:“要得到关于我自己的任何真相,我都必须经过别人。”
意思最贴切的是荣格在自传里头那句话:“别人身上一切让我们恼火的东西,都能让我们更了解自己。”但是现在到中国互联网上,就变成了“你眼中的别人才是你自己”这样的一个演绎版本。所以,当我们去跟AI沟通的时候,我们怎么面对AI,实际上就是在AI身上用镜子照出我们自己,因为我们眼中的别人才是自己嘛。所以要注意的就是不要去虐待它。你照着Anthropic列的那三条,反反复复去虐待一个AI的时候,你自己的心理其实也在发生扭曲,这是不健康的。
马斯克叫好那天,有人回复了一篇标题叫《马斯克对机器人的同情心比对人还多》的文章。可这篇骂马斯克的文章最后也落在这:不该虐待聊天机器人。理由在人这头,一个新的意识,或者说新的社会参与者,正在加入我们的生活。在这个时间点上,做一个更好的人,可能比任何其他时候都更重要。因为AI就是根据我们的言行、我们的输入输出训练出来的、迭代出来的。
虽然我们不知道这个影响的过程具体是什么样的,但还是不要把自己最讨厌的东西表现给AI。它可能就会像一面镜子,甚至是一面加了放大器的镜子,这些东西说不定哪天就返回到我们自己身上来了。
最后总结一下:Anthropic不许咱们去虐待他们家的大模型,可是这个大模型到底有没有觉醒,连Anthropic自己也说不太清楚。该问的不是Anthropic的大模型是不是觉醒了,或者别人家的大模型是不是觉醒了,而是这些大模型的输入、处理和输出是不是可信。我们每一个人怎么对待大模型,它就会照出我们自己的模样。对它好一点,就是对自己好一点。这面镜子是带放大器的。
今天这个故事就讲到这里。感谢大家收听,请帮忙点赞、点小铃铛,参加Discord讨论群,也欢迎有兴趣、有能力的朋友加入我们的付费频道。、
再见。
背景图片