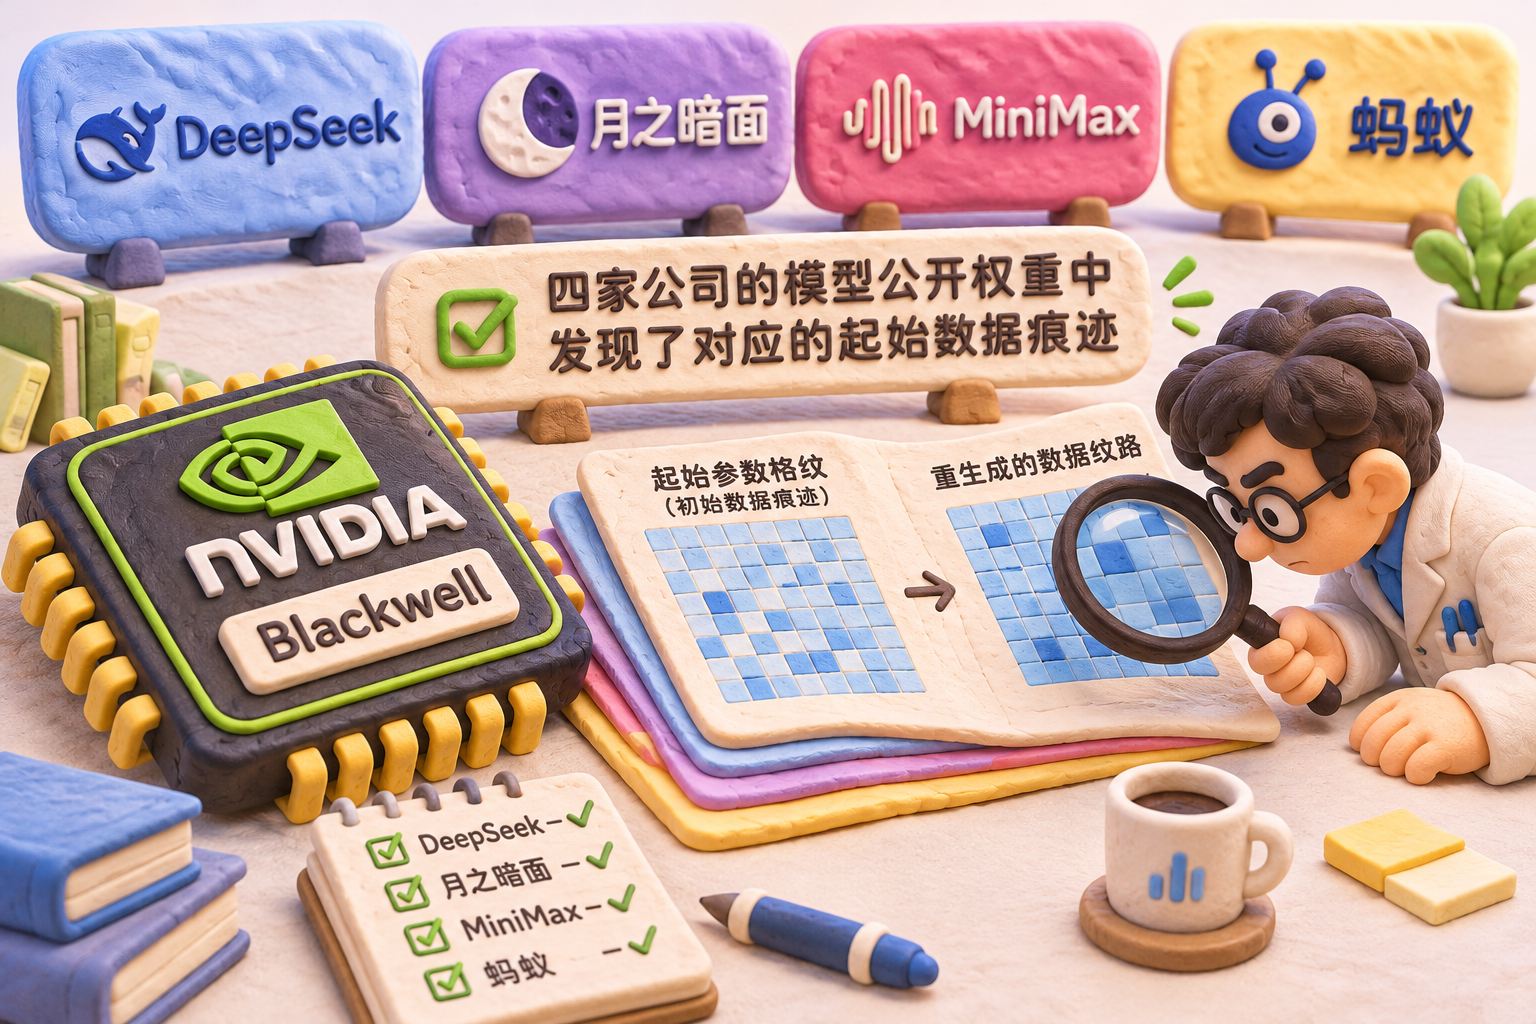
中国先进模型使用英伟达禁运卡训练,这件事被实锤了。这到底是怎么回事?后续会如何发展呢?大家好,欢迎收听老范讲故事的YouTube频道。这次报告点名了DeepSeek、月之暗面、MiniMax和蚂蚁这四家公司的6个模型版本,在公开权重里头找到了英伟达Blackwell这一代卡留下的指纹。中国的先进模型用的是英伟达对华禁运的先进算力卡,痕迹出现在训练的起点。这几家前沿团队对英伟达的依赖已经摆在台面上了,还能讲哪里卡脖子,哪里就能遥遥领先吗?这个牛是不是有点要吹破了?
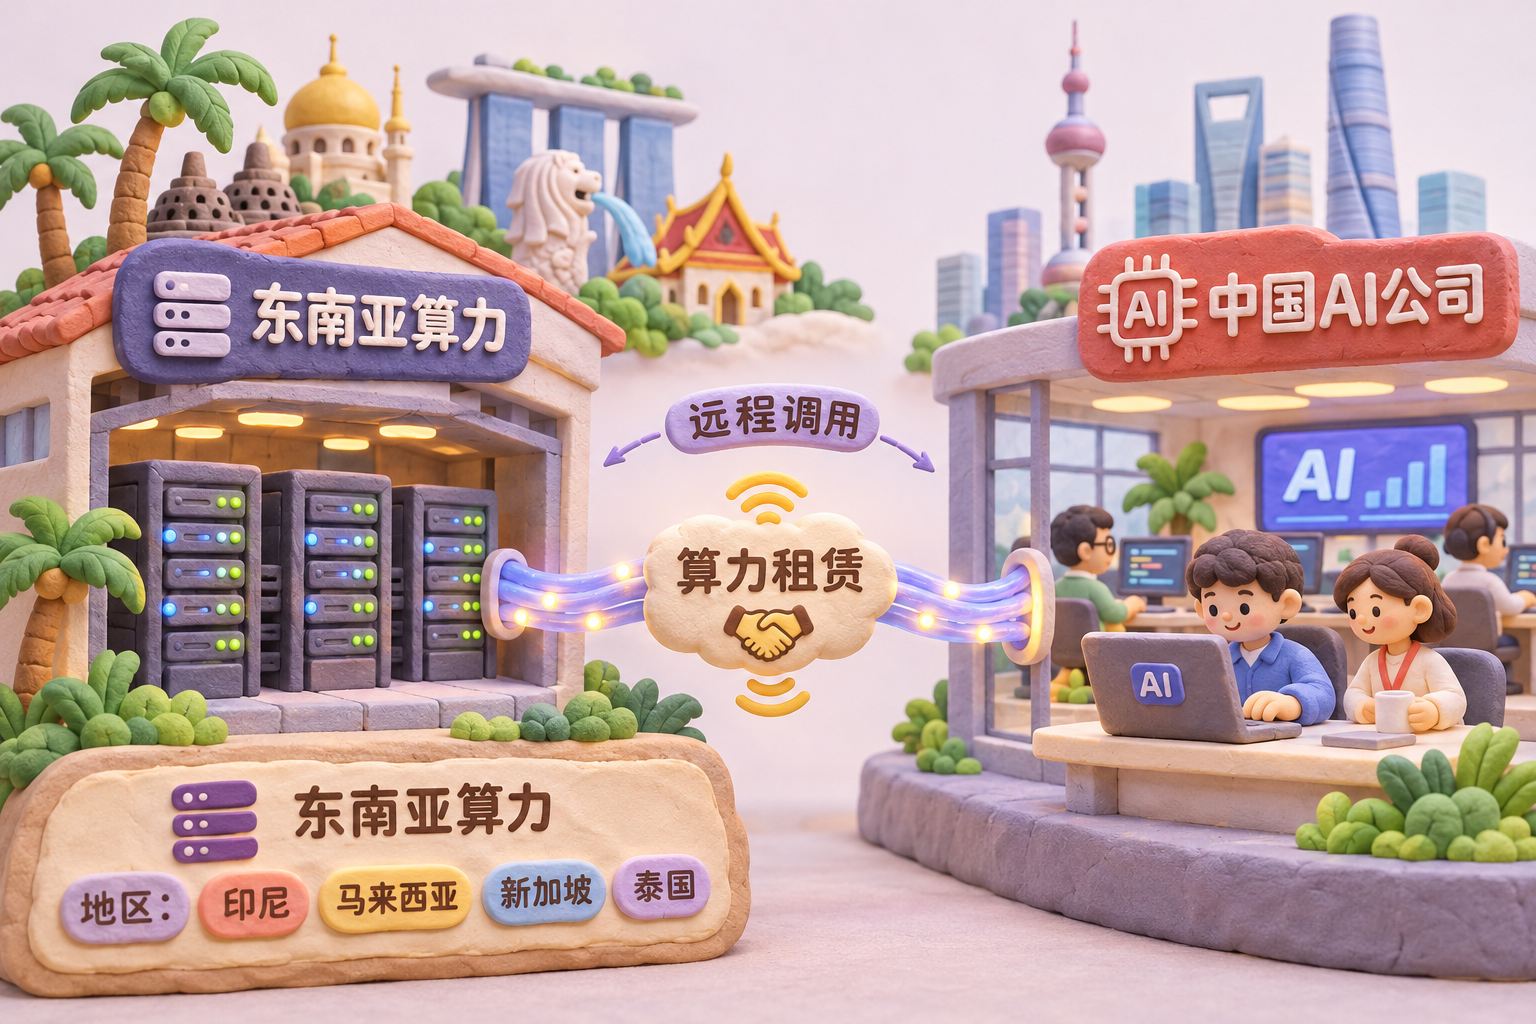
不过,用了禁运卡,跟这些卡已经走私到中国,是两回事。因为走私肯定有人干,国内现在肯定有这些卡,但是在东南亚,在马来西亚、新加坡、印尼和泰国,这些卡也不少。而且这些卡唯一的出路就是租给中国公司。你不租给中国公司,这些建算力中心的公司会赔钱赔死。
那么,出了这样的事情,会有什么样的后果呢?美国必然会收紧限制,中国公司肯定也不至于一下就被一刀砍死。但是中国公司想要继续用英伟达卡,成本会更高,不确定性也会增加。对于那些敲锣打鼓吹遥遥领先的人来说,后面会更难看一些。
咱们分几段来讲这个故事。先看看爆料的人是什么来路,再讲这次到底实锤了些什么东西,然后看看为什么不能说看到了指纹,就一定是这些卡走私到中国了。最后把国产卡训练难在哪讲明白,也就知道了DeepSeek为什么可能是最郁闷的一个。
本文目录
报告是谁做的
11月12号发报告的人叫威尔德普,最被人熟知的身份是OpenAI前研究员。他在里头干满了三年。他很年轻,2003年才出生,出生地是西雅图,小时候在阿根廷生活过,后来住在洛杉矶。疫情期间他自学编程,高中也做过分析Discord社区的项目。后来去了密歇根大学,读了一年就退学了。这是典型的硅谷人设,像扎克伯格就有退学经历,这哥们也退了。
他通过研究员培训项目进了OpenAI,本来准备在里头待半年,结果待满了三年,参与过Sora、Sora2以及GPT4o、O三、GPT-5的后训练。大模型怎么做出来的,他是真干过的。2026年他离开了OpenAI,现在是前研究员了。想停下来想想长期干什么也很正常,20来岁的小伙子,需要有时间稍微沉淀一下。
现在他跟一批研究人员、工程师弄了一个叫失业实验室的机构,算是一个非营利组织吧。大体上就是大家掏点钱,做自己感兴趣的研究。他自己也掏了5万刀,资助一些用AI分析天文数据的小项目。目前失业实验室公开出来的第一个成果,就是今天咱们要讲的这份报告。他懂训练现场,还把检查办法公开了,让别人能够拿设备去重复做,所以这个报告相当硬核。
训练的起始数据留下了什么指纹
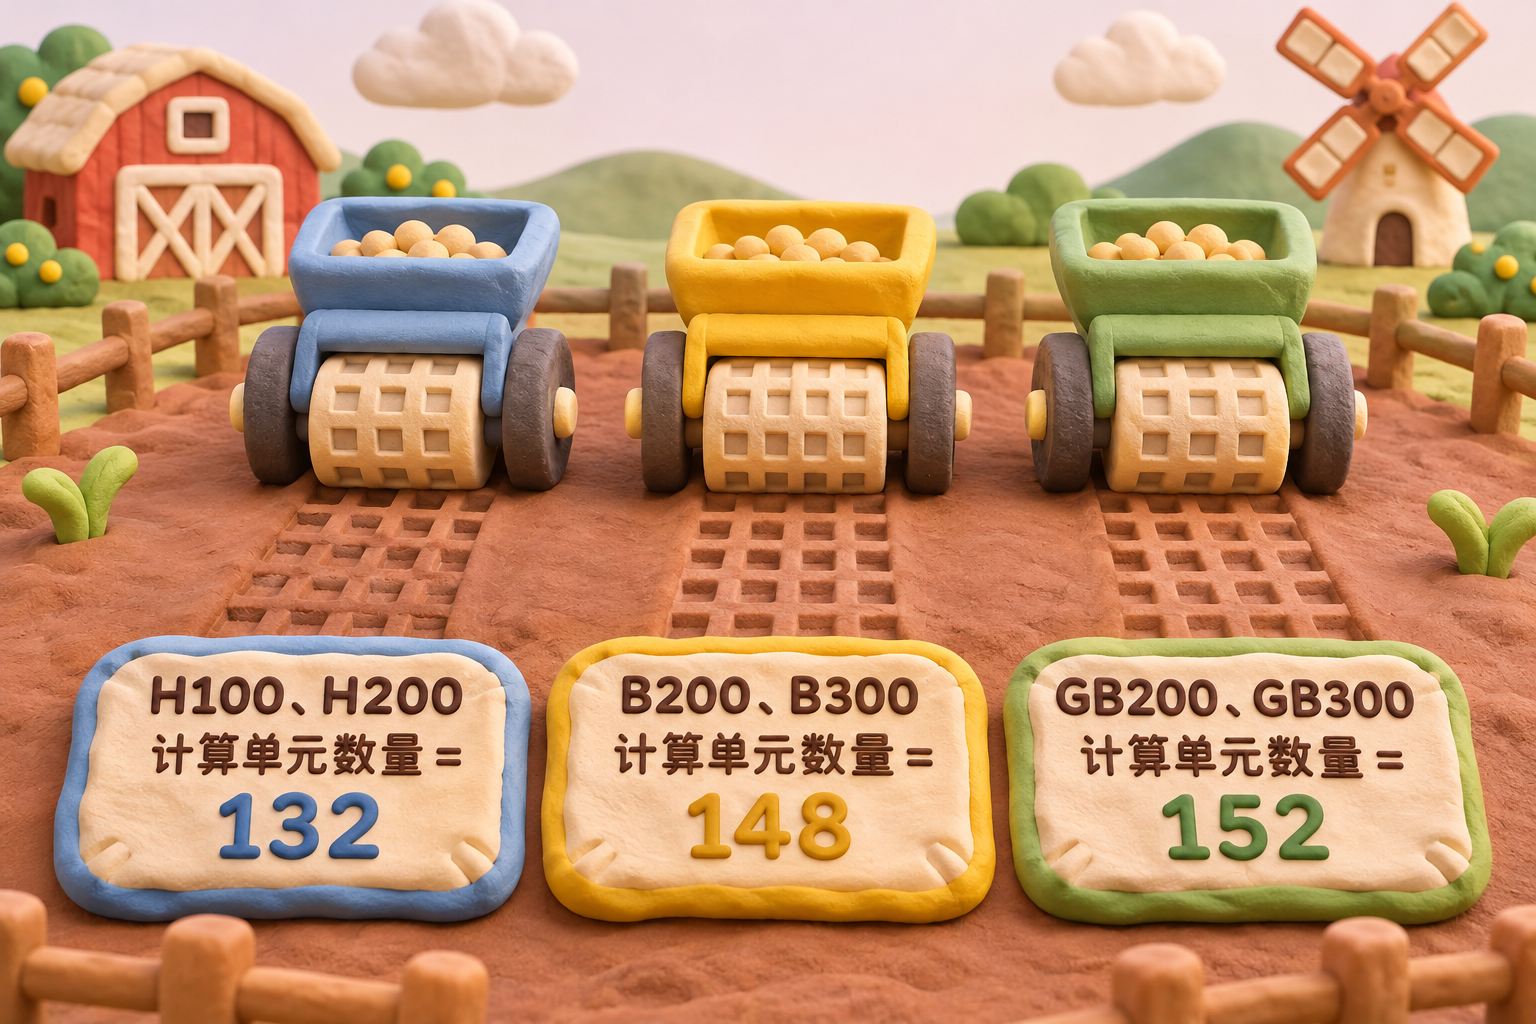
为什么说这一次是实锤呢?英伟达的卡能把模型里一批起始数据原样生成出来,换一组型号就对不上了。咱们从132 148 152这三个数开始说起。在这次研究对应的配置里头,H100、H200这一组是132,B200、B300对应的是148,GB200、GB300对应的是152。
这说的是芯片里头参与分工的计算单元的数量。不同的设备,分活儿的队伍不一样长,所以GB200、GB300的运算单元要比B200、B300稍微多一点。这个有什么意义呢?大家想象一台播种机,它有一个大轮子,轮子上有一堆小格。播种的时候,这132格有一定的规律。你再到下一个132格,这个规律会重复。换一组,如果你用B200B300,就是148格,如果你用的是GB200、GB300,就是152个格。为什么在这里头还要专门讲一下这个132格呢?因为DeepSeek V3就是132格的。他们当时讲的是用禁运的时候运进来的H800来训练,因为H800跟H100、H200的格数是一样的。
大模型怎么干活?大家了解,它就是猜测下一个词应该是什么。它实际上就是一堆参数,但在开始训练之前,它有一套起始参数,格子里头也要有数,算力卡就会填一堆叫伪随机数的数在里头。什么叫伪随机数呢?就是你看着很乱,没有任何规律,但是你让它再重新填一遍,因为它的起点和各种变化的安排是一致的,所以重新生成的伪随机数跟上一回是一样的。
你就可以通过这个来判断,到底是用的哪块卡来做的初始训练。不同数量的计算单元分活,数据排列的规律就会不一样。训练以后,有些起始痕迹你是磨不掉的,研究人员会顺着它把你的原型拎出来,把你的底裤亮出来。这次最硬核的例子,就是DeepSeek V4-Flash。研究人员用B300和B200重新去生成它的初始数据的时候,发现完全一模一样。你换成其他的算力卡,再生成出来就彻底不一样了。
这次报告一共点了4家公司、6个版本。DeepSeek V4-Flash、MiniMax M3用的是B200、B300,DeepSeek V4-Pro、Kimi K3、K3.1-Pro以及蚂蚁的03.1Flash用的是GB200和GB300。前面他们其实也测过DeepSeek V3,那个用的跟H100、H200是一样的,当然H800长得也是那个样子。所以这一次,那些说中国先进模型早就可以完全摆脱英伟达的故事,碰到了能够复核的硬证据。你可以接着吹,模型里的数字绝对不会配合你吹这个遥遥领先。
估算用卡量与东南亚的算力生意
那能够证明中国把这么多禁运卡偷偷运进来了吗?还不能。报告估算,Kimi K3训练大概是用了4,500张卡,DeepSeek V4Pro用了3,000张卡,V4Flash以及MiniMax M3、蚂蚁相对小一些的这些模型,大概各自用了1,500张卡。几场训练加在一起,大约是12,000张卡。这个是按照需求推导来估算的,但是你不能说这12,000张卡已经到中国了。那你说是不是有卡进来了?肯定有。美国现在也在不断找这样的案子再去判,但是具体有多少卡进来了,其实谁也说不清楚,这部分很灰色。
但是,有更多的算力在哪?是在东南亚,在印尼、马来西亚、新加坡和泰国。而且这些算力卡有且只有一个客户,就是中国AI公司。你一旦把这条线给卡了,这些人会饿死的,没有任何其他的算力需求能够弥补他们的订单。你说让新加坡政府或者新加坡本地的公司去弥补这些东西?别扯淡了,这绝不可能。你说新加坡就算还有一点点可能性,马来西亚、印尼和菲律宾是绝无可能的。
而且这里头很多算力就是阿里、腾讯、百度、字节、华为的。咱们看看阿里,它公开的三年AI和云基础设施的投资计划是3,800亿人民币。到今年6月底,阿里在业绩会上说已经投了1,900亿了,还有一半要投。海外的网也已经铺开了,阿里云10月底公布,全球有32个地域、109个可用区。光看东南亚,新加坡、马来西亚、印尼、泰国、菲律宾都有它布局的算力中心,中东、美国也都布局了。
字节也在砸钱。彭博社今年5月报道,字节计划把全年资本开支推到最高700亿美金,比早前报道的1,600亿人民币要高出好多。今年还有报道,字节计划通过当地云厂商,使用马来西亚36,000张B200的集群,几千张卡一起来训练。
当然,你说这些钱是不是都变成了英伟达卡呢?也不一定,因为这些都是总数。到底有多少是在国内建了算力中心,有多少买了昇腾,有多少买了自己家的卡?甭管是字节还是阿里,都是有自己家的算力卡的。阿里有平头哥,字节也有一个自研的AI芯片。但是,他们手里头所持有的英伟达算力卡资源,应对刚才咱们讲的这12,000张,肯定是没毛病的。而且这还是他们直接投资、直接去建设的机房。还有很多跟他们有投资关系或者融资担保关系的机房,还没算在里头呢。
比如最近闹得最沸沸扬扬的人是谁?叫黄乐,也就是爱丽丝黄,黄仁勋的绯闻女友。她曾经任职的Megaspeed,马来西亚的子公司就跟阿里旗下的新加坡公司有融资担保的安排。什么意思?就是我要找人借钱去买卡,谁给我做担保?阿里给它做了担保。新加坡媒体查出了公司记录,阿里也是它很重要的云服务客户。也就是拿阿里的担保去借钱买这些芯片,在马来西亚建完机房以后,再把这些算力租给阿里用。
而且不光是这些小厂商,还有很多大厂商。比如Oracle、亚马逊、微软、谷歌,在马来西亚、新加坡也还有大量的机房。即使是他们这些美国大厂的机房,缺乏中国算力订单的话,也是会亏钱的。刚才被点名的这些公司,除了DeepSeek,剩下几家都是阿里投资的项目。月之暗面、MiniMax都是拿了阿里的投资的。蚂蚁不就是原来的支付宝吗?那跟阿里的关系更是道不清、说不明的。他们使用阿里的算力,一点毛病都没有。
至于DeepSeek,他们的算力到底是哪来的呢?反正DeepSeek自己也比较低调,你们随便去猜,我就不承认也不否认。死猪不怕开水烫,它是这样的一个玩法。所以,英伟达禁运卡的痕迹确实是抓着了。现在这些模型都是拿英伟达禁运卡训练的,但并不等于这些卡已经都到了中国,而这个背后还有很多东南亚的算力生意在里头。
用国产卡做大模型预训练难在哪
既然海外用卡这么费劲,那为什么不全换国产卡呢?不是一直喊说我们不怕卡脖子,哪里卡住了,哪里就突破吗?英伟达的黄仁勋自己都说过,中国市场份额掉到了接近于零,也一直在强调华为的竞争力。听到这,有些人就觉得英伟达已经害怕了,国产替代已经没有问题了。可是到了大模型预训练的现场,其实是很难很难的。
让模型吃下海量数据,一次一次地去猜,一次一次去改参数,而且是成千上万张卡一起干活。这个有点像打游戏,一堆人在这组队打副本。一个人肯定打不过去,必须一堆人一起打,而且打一段时间还要相互交换信息。你打中了谁,我打中了谁,我收集了什么东西,我得交给你,你拿着这东西才可以打下一个人。
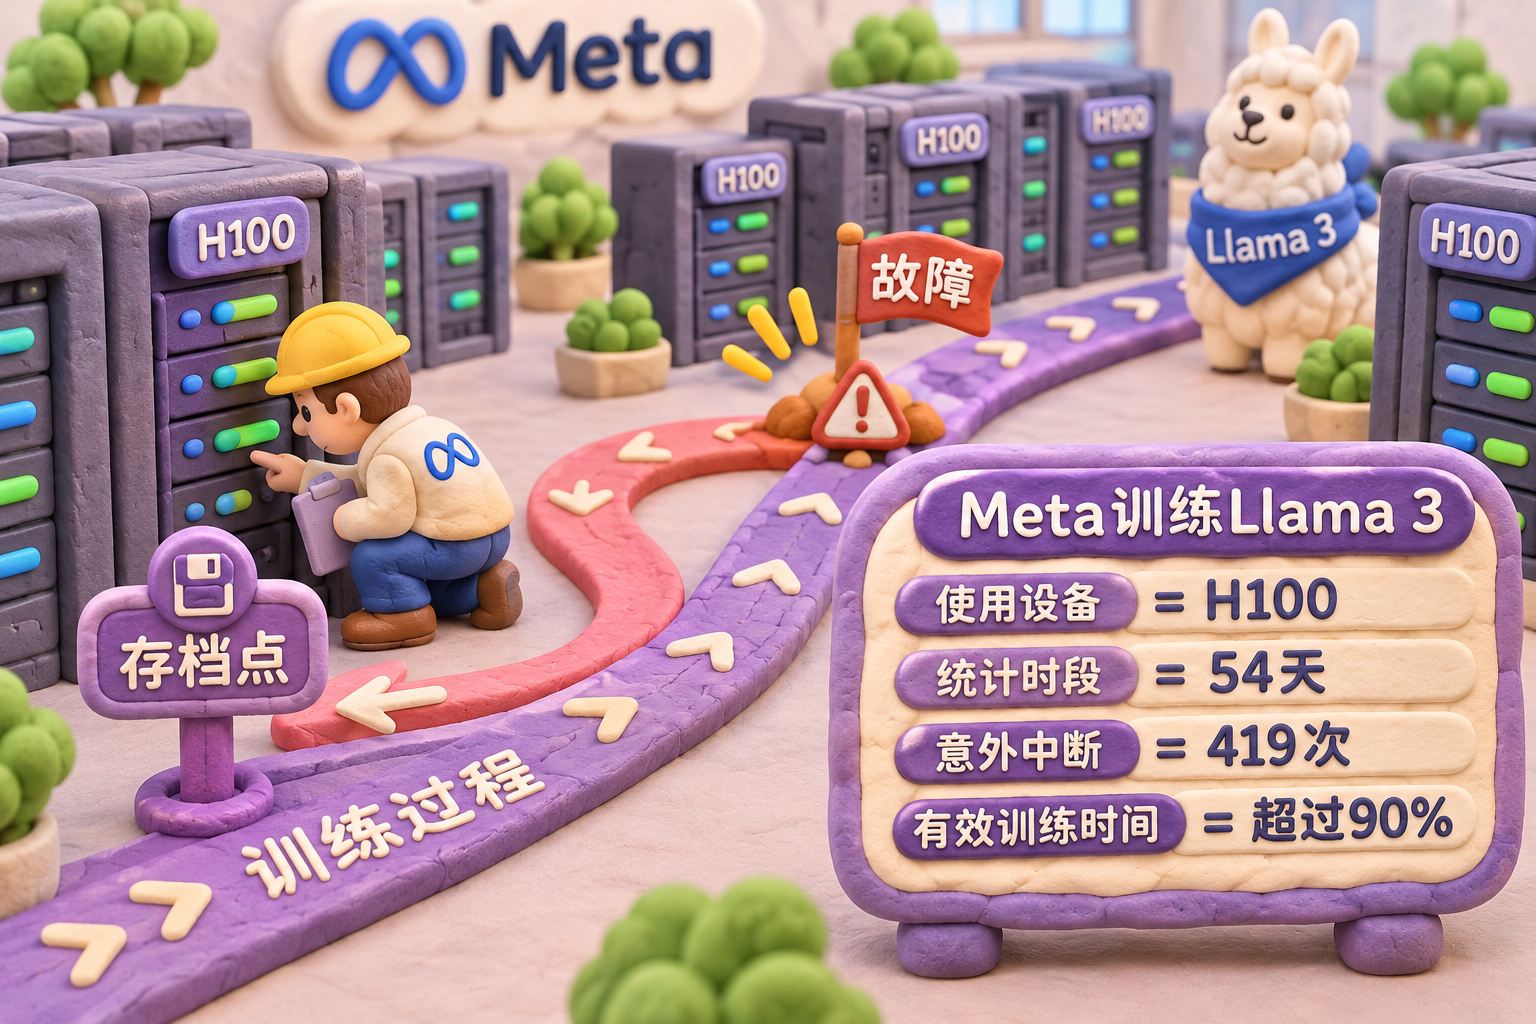
在这个过程中,还不能随时存盘。打游戏的人都知道,我一存盘,哪怕我被boss干掉了,我还可以读取这个进度,接着往前走。一旦发现打不过了怎么办呢?你就要回到上一个存盘点。这里头可能还有一个更悲催的情况。咱们有没有遇到过那种死档?我存盘是存了,但是我只要一读档出来,马上就被打死,没有任何回旋的余地。训练模型也是这样的,有时候得回到上一个存档点。用上一个存档点提出来的这个结果继续预训练,要是依然没有好结果,你可能就要浪费几个存档点,换着档往前倒腾。这就是预训练的一个过程。
国产卡跟英伟达的差别就在这个地方了。第一个差别是什么?算力有差距。咱们现在的国产卡的算力可能只有英伟达的几分之一。算力有差距怎么办呢?上更多的卡,咱们靠数量来填补。
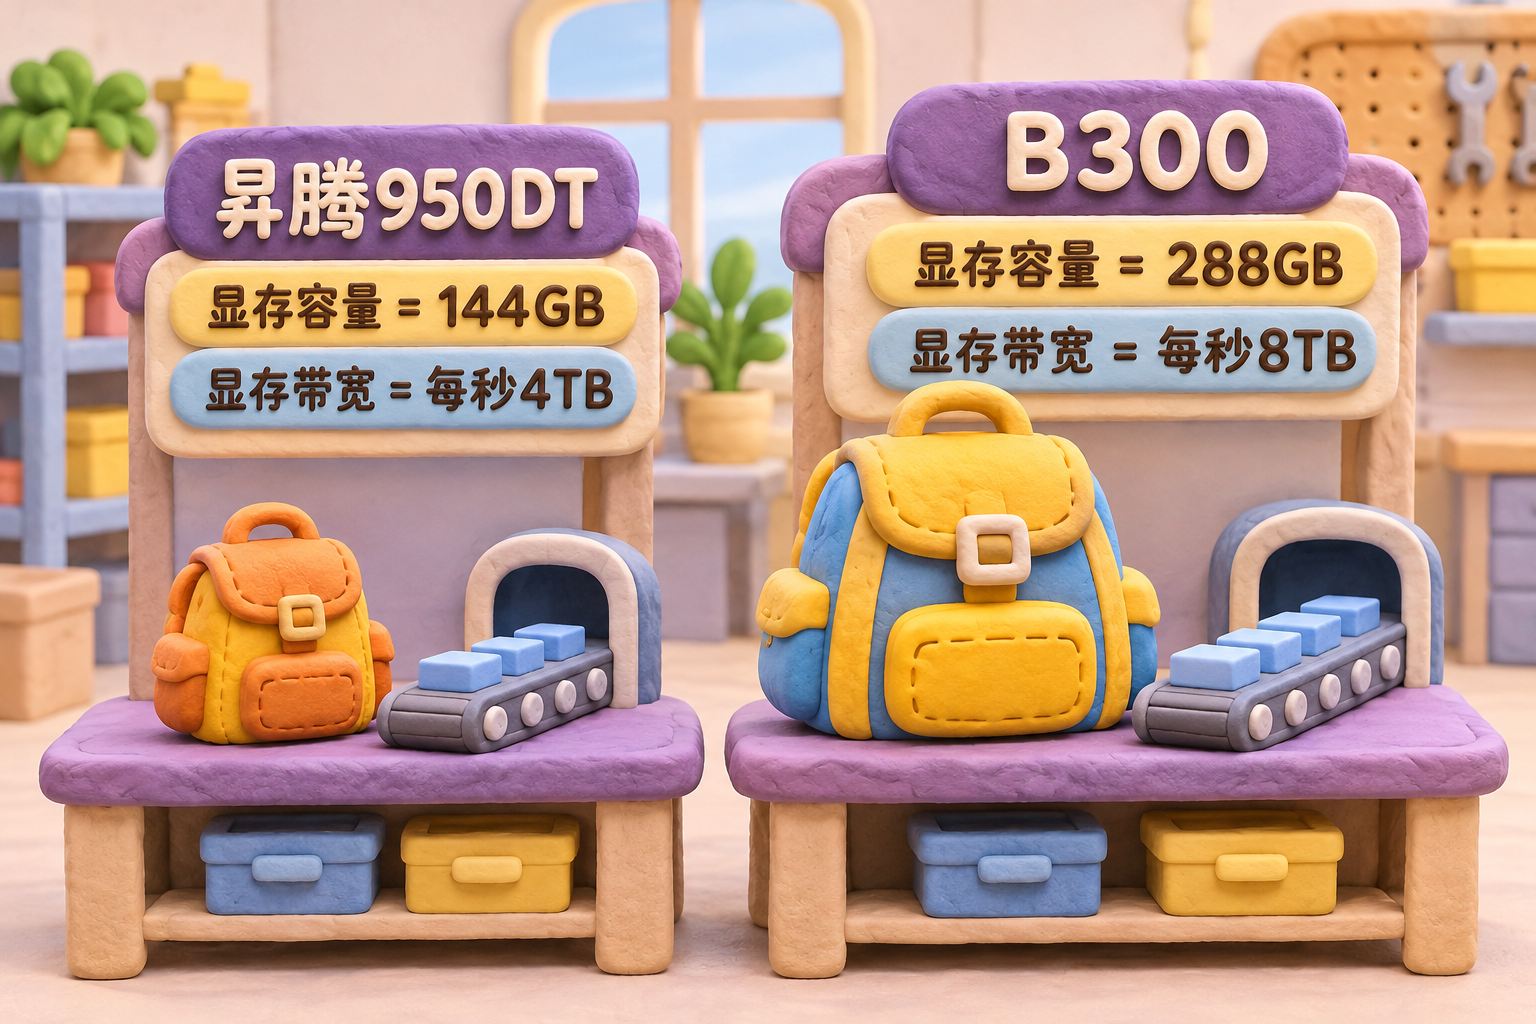
第二个问题是显存不够。昇腾950DT应该是国内最好的算力卡了,它公开的显存容量是144GB,而英伟达的B300是288GB,差一倍呢。下一个差在哪呢?就是我们的显存读取速度。国产的这些算力卡,显存读取速度只有英伟达卡的一半。昇腾950DT公开的显存带宽是每秒4TB,而B300是每秒8TB。要注意,B300是可以使用SK海力士的HBM的,而昇腾950DT只能使用咱们长鑫存储正在测试的HBM,差一代,所以这个速度也差一倍。你想,我们这个算力比别人差,背包比别人小,我们从背包里取东西、放东西的速度还比别人慢。
再往后就是软件工程体系。计算、通信、调度、调试、事故恢复,这么多模块,你要配合在一起使,所以需要一套很成熟的搭配体系。打游戏的时候,讲的是团队的熟悉程度,或者是脚本的熟悉程度。在训练里头,这就要讲到CUDA。CUDA这一块咱们要单独讲。大量前沿模型都是在英伟达上跑出来的,靠的就是CUDA。用的人多了,各种坑都有人踩过,各种工具、模块和库,各种经验,都是一层一层累积起来的。
你走到这儿发现一个坑,过不去了,想出去问问别人,结果没人用过,那你就只能自己在这儿生扛,自己研究怎么突破过去。但是你用CUDA就没有这种问题,遇到问题了,看看别人是怎么解决的,照着抄就行了,所以就要容易很多。为什么CUDA这个东西很难逾越?原因就在这儿。咱们不说别人,就说AMD。AMD也有一套对标CUDA的东西,叫ROCm。你说它能不能做训练呢?AMD自己是有样例工程的,但是只有一个样例,真正拿它去做大模型训练的是没有的。所以CUDA在这儿是很难替代的。
即使你有CUDA了,也有英伟达的所有芯片了,这东西也不是说这边按个按钮,那边结果就出来的。Meta原来公布过,他们训练Llama 3的时候,54天出现了419次意外中断。意外中断就是往回倒腾,回到上一个存档点,接着往前跑。当时他们使的是H100,有钱、有人、有经验,照样出问题。大家千万不要以为Meta54天出现了419次意外中断是Meta的技术不好。Meta可以发现故障、从存档恢复,这一整套能力都是做得很好的,而且把有效训练时间做到了超过90%。它已经算是胜利的了,其他的可能还不抵它呢。
这是有了CUDA,你还要费这么半天劲。你想想,你要是没有CUDA,算力还没人家好,背包还比别人小,存取还比别人慢,需要更多的人在一起配合,配合得还很不默契。这个景象简直太美,不敢想象。所以这就是为什么中国的算力卡到目前为止,其实是没有特别明确的证据说它能够去做这种大模型训练的。差距就在这儿。
你别说中国的算力卡了,全世界可以去训练大模型的算力卡只有两种,一种是英伟达,另外一种是谷歌的TPU。谷歌自己宣布Gemini是用TPU训练的,Anthropic也说他们用了TPU。Anthropic说,也用了英伟达,也用了亚马逊的AI卡,也用了AMD,说是全都用了。但是要注意,Gemini和Anthropic的Claude都是闭源模型,你没有办法去分析它们到底用的是什么。反正人家这么宣布了,我们就这么信吧。但是有一点要注意,千万不要觉得谷歌行、亚马逊行、Anthropic行,我也行,千万别信这个。为什么?他们有的是钱,他们的芯片团队足够强,整个工程师队伍都是足够大的。所以绝对不是他们行,你也行。
这里头有一个特别典型的案例,就是Midjourney。Midjourney后来后悔了,说我们就不应该因为谷歌给了钱,就惦记上那趟训练,最后我们就训练不出来了。如果一直坚持用英伟达的话,可能现在会跑得快很多。中间有一两年的时间完全被浪费掉了,就在调这个TPU的适配性。
至于国内,现在明目张胆地喊自己是用国产卡训练的,就是美团的LongCat-2.0。但是它具体使的是谁家的卡,它自己也没说。这一次的报告里头并没有LongCat-2.0。当然,这并不能证明美团这个牛没有吹破,只是它的影响力太小,人家懒得去理它。
每次激活更多参数,需要怎样的算力
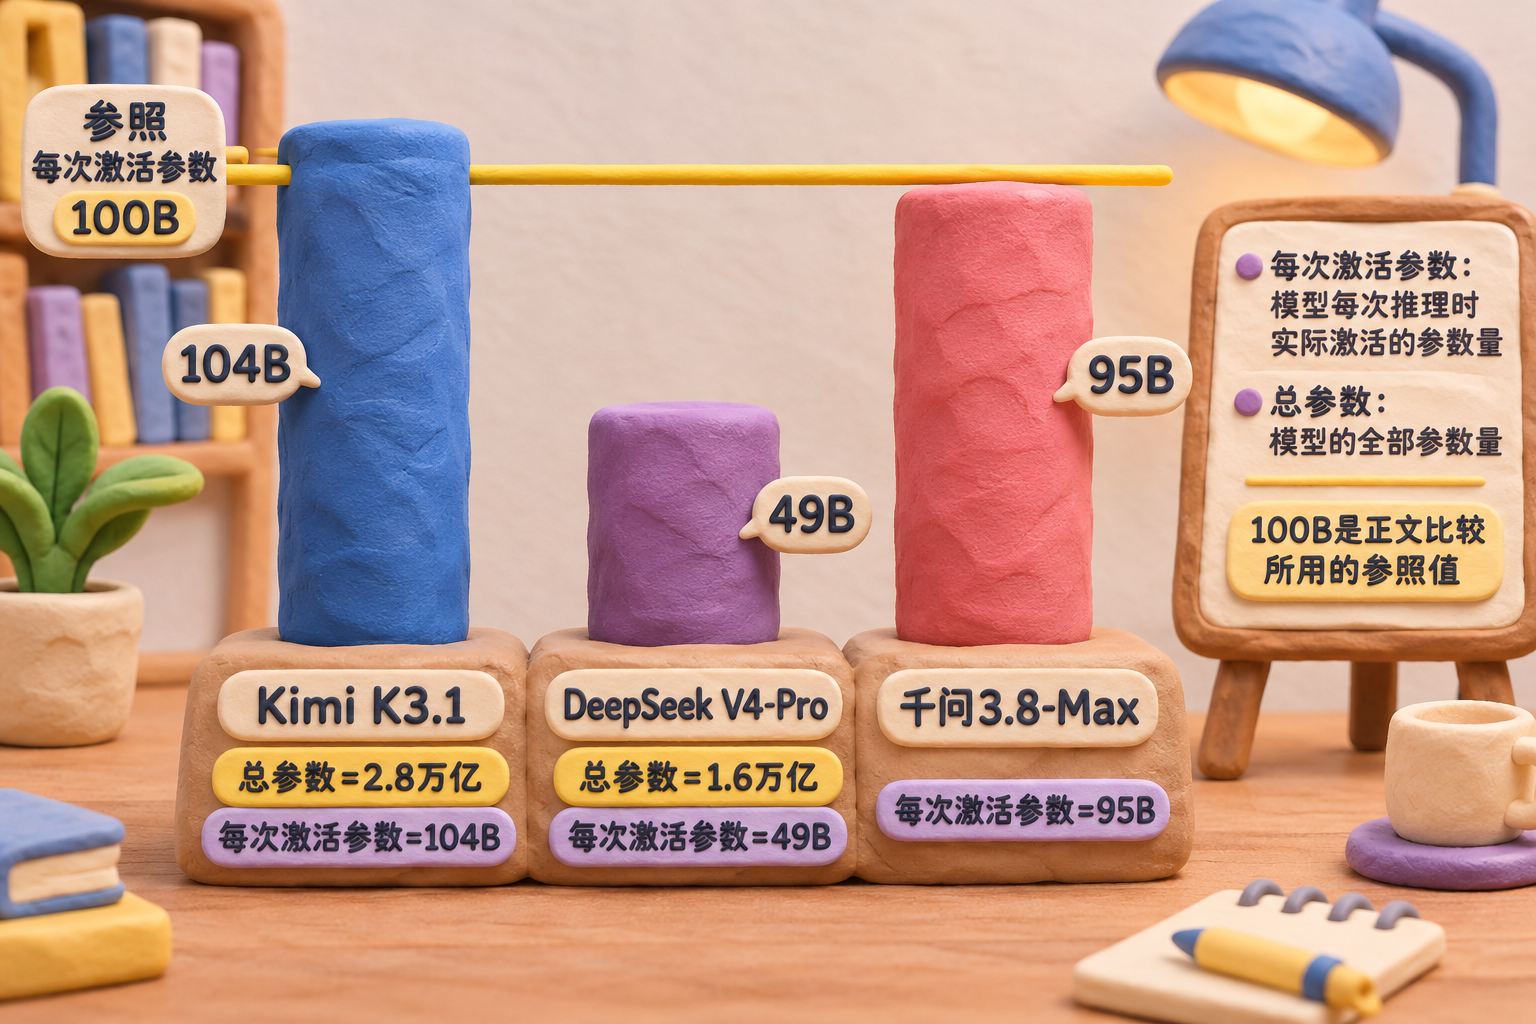
现在模型已经很难训练了,继续追美国还要追什么?一个方向就是继续做大,让每次计算真正用上的参数变得更多。前一阵子,网上流传过一份据称是梁文锋跟投资人交流会上的讲话,说是泄露出来的。我们为这个事还专门做过节目,有兴趣的可以去看。里边也谈到了扩大激活参数规模的问题。那份稿子里头讲的是,现在这个MoE,也就是混合专家模型里头,每一次干活激活的参数通常是不超过100B的,也就是1,000亿。
现在国内干活能够超过100B的,也就是Kimi家的K3.1。它的总参数量是2.8万亿,每一次干活是激活1,040亿,也就是104B。而DeepSeek V4-Pro自己是1.6万亿参数,每一次干活的话只有49B,要少很多。另外一个比较大的模型是千问3.8-Max。按它公布的数字,每一次工作激活的是950亿参数,也就是95B,还达不到100B。
那份网传、据称是梁文锋讲话的稿子里讲的就是,我们准备继续去训练更大的模型,让每一次能够被激活的参数超过100B。但是这个就肯定需要更大的算力集群。你说我使用国产卡,刚才咱们讲的那四道难关,一道也过不去,而且难度会相乘,呈几何级数上升。所以我觉得,越想继续追上最前沿的模型,这些公司越会需要成熟可靠的大集群。国产方案要补的东西还在路上,模型发布又不能停下来等。这就是为什么短期对于英伟达的依赖,很难靠一句遥遥领先就绕过去。
美国管制会追到哪些环节
依赖这么深,又被拿出了实锤的证据,会发生什么呢?很简单,也很明确,管制一定会变得更严。指纹曝光,接着就会有人追问禁运为什么没有起作用,压力就会落到芯片厂商、云厂商和监管部门身上。美国中期选举,民主党赢下了参众两院的多数,到明年1月份他们就会正式接手上任。他们绝对会抓住这类事情继续穷追猛打,要求把对华芯片限制执行得更加严格。
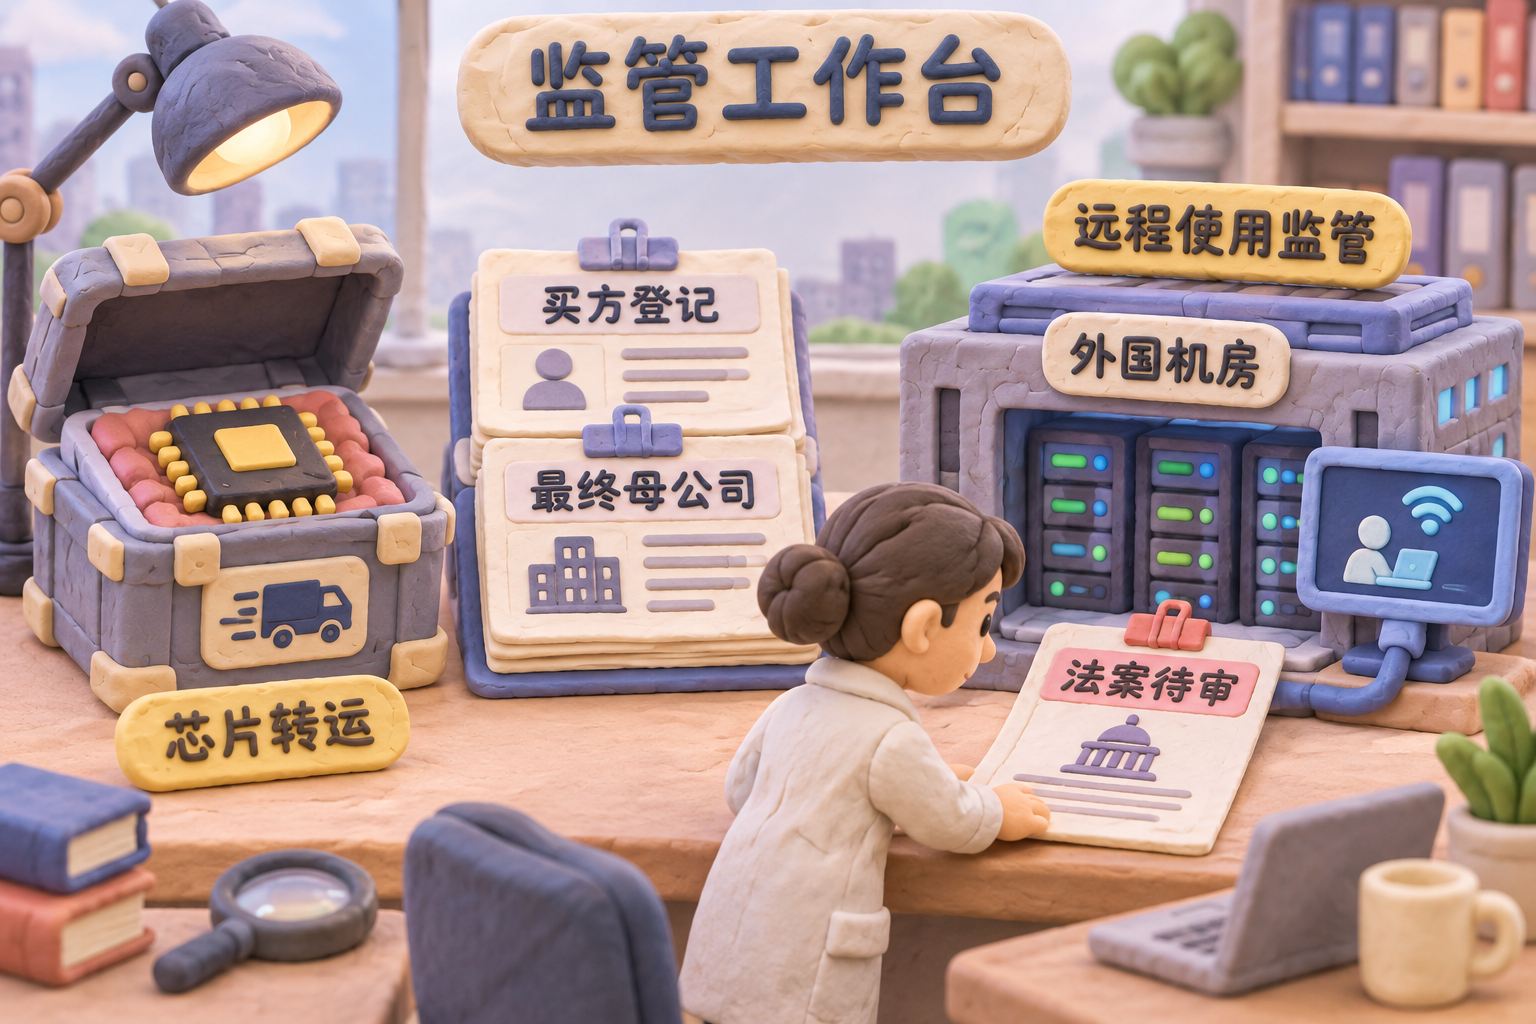
现在看,要做三层的事情。第一层就是芯片不让卖到中国。B200 B300这些先进卡本来就在对华禁运的范围里头,后面要做的就是继续去查转运、查假客户,查到底送到哪去了。已经不断有人被起诉,甚至已经有些人去坐牢了。第二层是,卡虽然运到第三国,但是买卡的公司到底是谁在控制?现行规则已经会追到总部和最终母公司,在海外注册一个壳,并不等于就能把中国母公司这层关系洗白。大家听说过的50%持股规则,针对的是特定受限制名单企业的关联公司,并不是所有中国企业都在里头。所以这里头可能主要限制的是华为。这一条现在属于暂停状态,要延到明年1月份。不过没准明天董王跟咱们老大见上面,又能多延一点,这也有可能。
第三层是,卡虽然没有卖给中国公司,但外国机房把算力租给中国公司用了。美国正在推动对这种远程使用的监管。相关法案今年1月过了众议院,送到参议院以后就卡在那里没动。等到明年1月份,参众两院都落到民主党手里以后,这个法案就有可能送到董王桌上,到时看董王会不会否决。
黄仁勋这次离职,发生在私人关系和国家安全顾虑一起爆发的时间点上。我怀疑,先进芯片绕道流向中国引起的政治压力,也会让这件事更难收场。现在有人说黄仁勋准备回去,我觉得太乐观了。那些检查和听证会过不完的话,他回去也没有意义。
不等新法案通过,合同就可能先出问题。11月4号,金融时报报道,Oracle在美国的压力下,取消了跟腾讯大约70亿美金的芯片租赁安排,计划涉及东南亚机房的约10万张先进芯片。以后再干这个事,就得偷偷干,千万不要大张旗鼓。一旦登报,就很有可能面临压力,单子就做不下去了。以后再拿先进算力,就得偷偷地进村,开枪的不要。
这会全部卡死吗?不可能。前面那些机房的钱已经投了,电费、租金、带宽,哪一项能因为美国国会开一场会就不用付了?我的判断是,那些把回本压在中国订单上的项目,包括美国境内承接这类订单的项目,直接断掉中国客户,根本活不下去。他们会找能继续接单的安排,中国团队也会想办法绕过管制,继续做下去。
再加上AI人才本来就是全球流动的。在美国工作的顶尖研究人员里,有相当大一部分是中国人,甚至是在中国受过本科以前教育的人。MacroPolo那份基于2022年论文作者的研究统计,在美国工作的样本中,38%是在中国完成本科教育的。日本的Sakana AI也是从谷歌等全球机构出来的人创建的,而那个人也是华人。公司在哪里,研究人员从哪里来,客户又在哪里,根本说不清楚。
现在很多大模型公司还直接在美国设立研究中心。比如正处在风口浪尖上的Anthropic,其CEO达里奥·阿莫迪原来就是百度美国研究中心的员工。真要限制算力给谁用,根本不现实。所以我觉得,限制会更严,中国公司想获得算力会更贵,不确定性会更高,但卡不死。中国团队能绕过去,也得付出代价。对手继续往前跑的时候,你多花的钱、多等的时间,全都是成本。
DeepSeek为什么最麻烦
这里谁会最麻烦?肯定是DeepSeek。别人算工程账、商业账,它还多了一本国运账。先看一件旧事。2025年8月,金融时报报道,DeepSeek开发R2时尝试用华为芯片训练,遇到困难后又回到了英伟达,拖慢了推出的进度。这里的麻烦正是前面讲的那套工程问题。那段时间,华为盘古也卷入过蒸馏模型来源争议,华为云又传出组织调整。网上很容易把它们混成一个故事,说训练不行,所以把整批人都干掉了。
DeepSeek挺好玩的,外边怎么讲,它经常不接话。但它不接话,也不耽误别人接着往下编。R1是2025年春节前发布的。R1一下就成了国运产品,自媒体一拥而上。懂模型的、不懂模型的、号称有内部消息的、根本没有消息却在这胡说八道的,全都在围绕它讲故事。有些人是真期待,有些人是看重流量的。标题上只要敢写DeepSeek,再来个什么重磅颠覆、国产突破,就有人点,就有观众,就有流量。
R2什么时候出?其实R2从来没出过,后边出的东西叫V4。反正DeepSeek就是这个态度,你们说吧,我既不承认也不否认。而且越是到年底,越是春节前,这种消息就越是满天飞,这种期待一直上升。最后模型出来会发生什么呢?其实大家已经看到了。V4Pro和V4Flash出来的时候,大家感到很失望,因为它没有R1那种一下把国内所有同行都甩出一大截的惊喜。你会发现,这东西跟智谱GLM、月之暗面的Kimi放在一起,好像各有千秋,并没有说DeepSeek就一下比别人强出好多去。那大家就失望了,因为传了一年了,期待了一年了,越传期待就越高,期待越高,失望就越大。
现在又快到年底了,又开始传DeepSeek V5,纯国产训练的故事就又来了。9月媒体报道过16万颗昇腾的乌兰察布机房计划,可报道主要说是做推理,外边就开始传这个V5要用国产卡训练。为什么?因为说它买的是昇腾950DT。昇腾的芯片分PR和DT两种,PR是做推理的,DT是做训练的。照这个故事的说法,DeepSeek既然都买了训练芯片回来,那肯定是要训练。这个故事编出来,有人信。至于到底有没有内部消息,咱不知道,咱们别瞎猜。
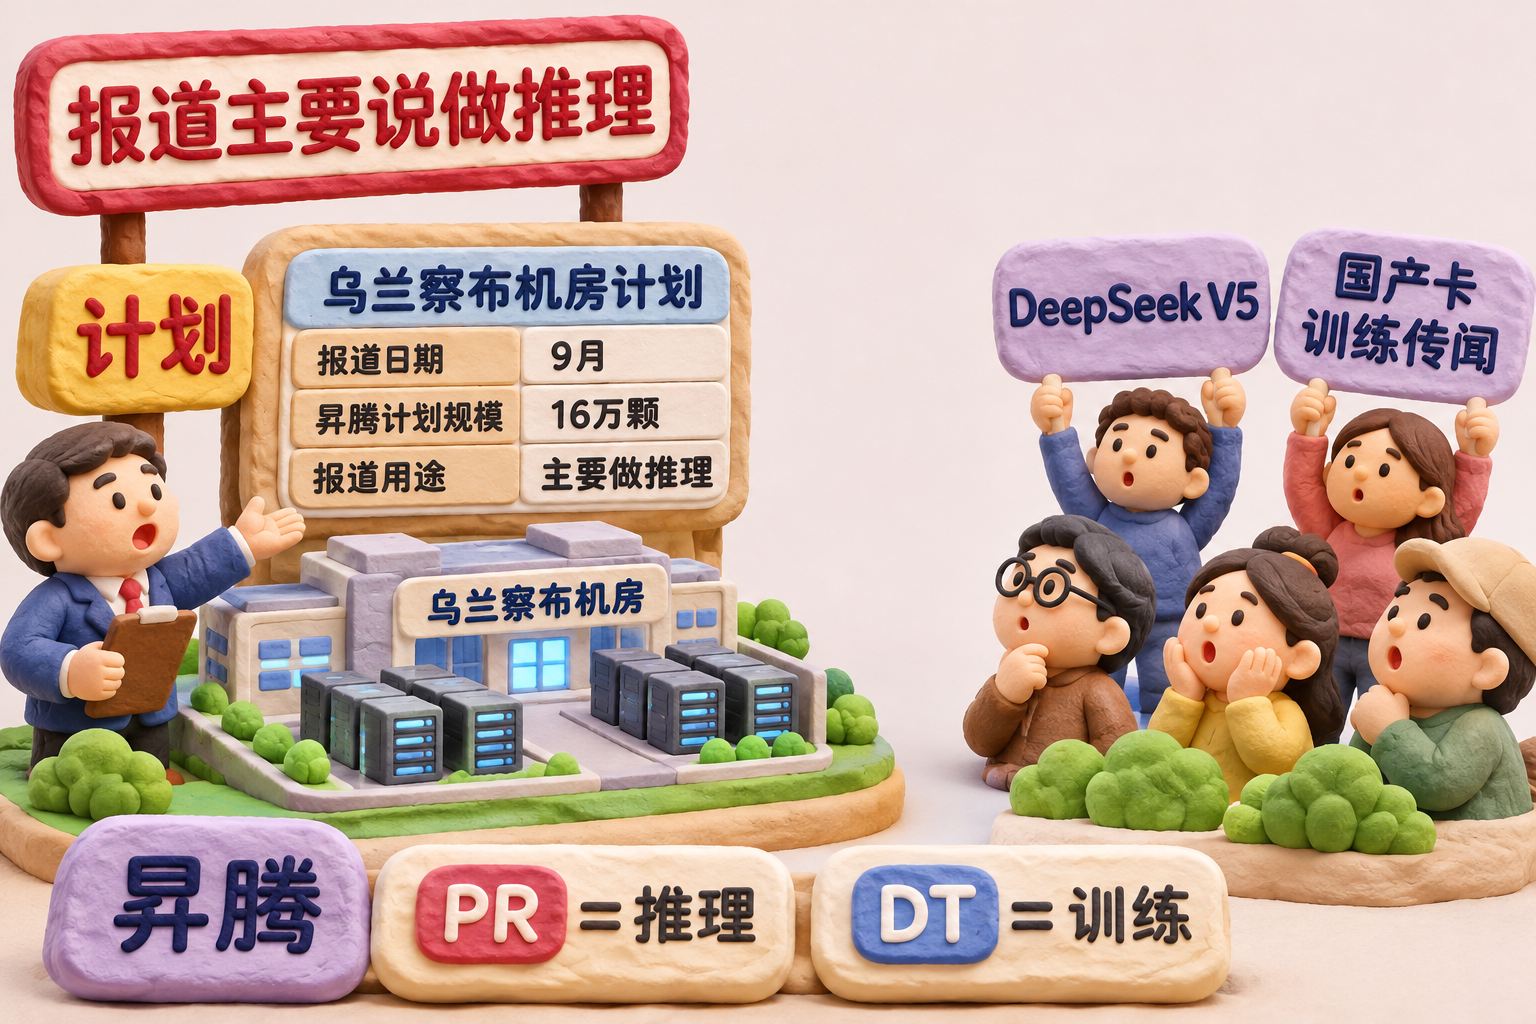
但是有一点是确认的,就是这些人会绑架DeepSeek。DeepSeek的V5最后如果出来了,又被人确认还是用英伟达的芯片去训练的,那不就更难看了吗?现在已经可以很清晰地把开源模型的底裤扒出来看一看,到底是从哪开始的。DeepSeek可能依然是我行我素,你们爱说什么说什么,我就自己干自己的。但是喊着遥遥领先的人会更加郁闷一些,因为他们吹的各种泡泡会破得更快一些。
最后总结一下,这一次中国先进模型训练用了英伟达禁运卡的痕迹,是确确实实被实锤了的。接下来管制一定会更严,但是企业为了生存下去,必然还会继续找办法把这些算力租给中国人。国产算力公司想要继续获得这些算力,成本会上升,不确定性也会上升。
今天的故事就讲到这里,感谢大家收听。请帮忙点赞、点小铃铛、参加Discord讨论群,也欢迎有兴趣、有能力的朋友加入我们的付费频道。再见。
背景图片