中国大模型里的英伟达禁运卡训练指纹

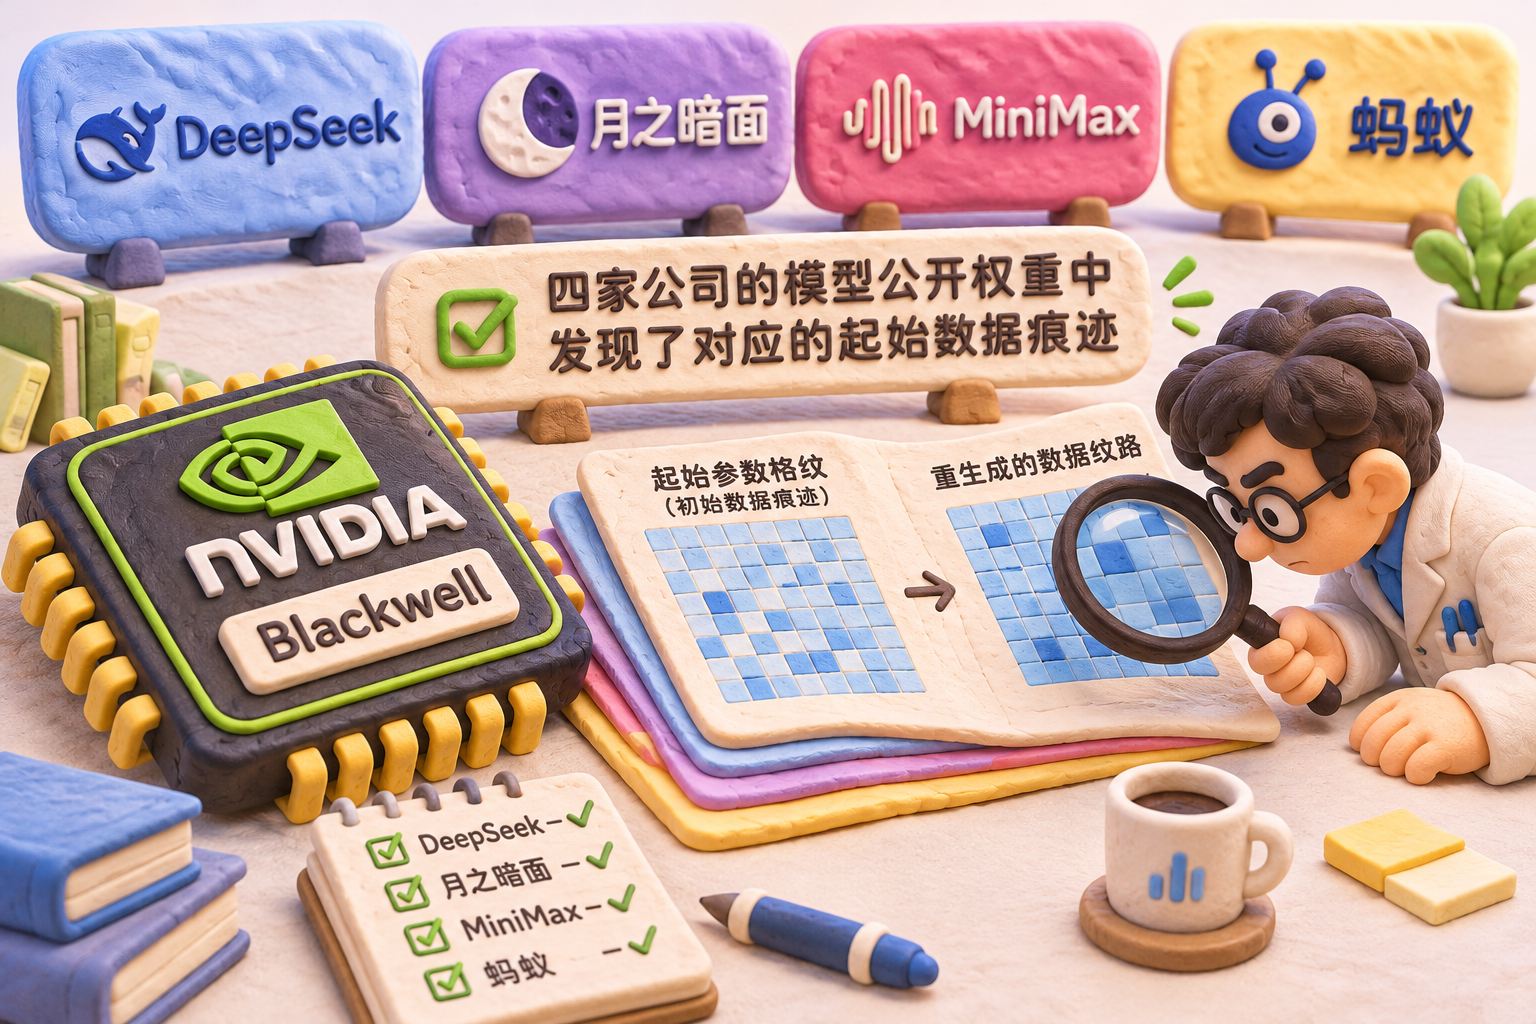
研究员对照中国大模型起始参数中的英伟达禁运卡(Blackwell)指纹。

中国先进模型使用英伟达禁运卡训练,这件事被实锤了。这到底是怎么回事?后续会如何发展呢?大家好,欢迎收听老范讲故事的YouTube频道。这次报告点名了DeepSeek、月之暗面、MiniMax和蚂蚁这四家公司的6个模型版本,在公开权重里头找到了英伟达Blackwell这一代卡留下的指纹。中国的先进模型用的是英伟达对华禁运的先进算力卡,痕迹出现在训练的起点。这几家前沿团队对英伟达的依赖已经摆在台面上了,还能讲哪里卡脖子,哪里就能遥遥领先吗?这个牛是不是有点要吹破了?

不过,用了禁运卡,跟这些卡已经走私到中国,是两回事。因为走私肯定有人干,国内现在肯定有这些卡,但是在东南亚,在马来西亚、新加坡、印尼和泰国,这些卡也不少。而且这些卡唯一的出路就是租给中国公司。你不租给中国公司,这些建算力中心的公司会赔钱赔死。

那么,出了这样的事情,会有什么样的后果呢?美国必然会收紧限制,中国公司肯定也不至于一下就被一刀砍死。但是中国公司想要继续用英伟达卡,成本会更高,不确定性也会增加。对于那些敲锣打鼓吹遥遥领先的人来说,后面会更难看一些。

咱们分几段来讲这个故事。先看看爆料的人是什么来路,再讲这次到底实锤了些什么东西,然后看看为什么不能说看到了指纹,就一定是这些卡走私到中国了。最后把国产卡训练难在哪讲明白,也就知道了DeepSeek为什么可能是最郁闷的一个。

报告是谁做的

11月12号发报告的人叫威尔德普,最被人熟知的身份是OpenAI前研究员。他在里头干满了三年。他很年轻,2003年才出生,出生地是西雅图,小时候在阿根廷生活过,后来住在洛杉矶。疫情期间他自学编程,高中也做过分析Discord社区的项目。后来去了密歇根大学,读了一年就退学了。这是典型的硅谷人设,像扎克伯格就有退学经历,这哥们也退了。

他通过研究员培训项目进了OpenAI,本来准备在里头待半年,结果待满了三年,参与过Sora、Sora2以及GPT4o、O三、GPT-5的后训练。大模型怎么做出来的,他是真干过的。2026年他离开了OpenAI,现在是前研究员了。想停下来想想长期干什么也很正常,20来岁的小伙子,需要有时间稍微沉淀一下。

现在他跟一批研究人员、工程师弄了一个叫失业实验室的机构,算是一个非营利组织吧。大体上就是大家掏点钱,做自己感兴趣的研究。他自己也掏了5万刀,资助一些用AI分析天文数据的小项目。目前失业实验室公开出来的第一个成果,就是今天咱们要讲的这份报告。他懂训练现场,还把检查办法公开了,让别人能够拿设备去重复做,所以这个报告相当硬核。
阅读更多

DeepSeek大肥鱼:AI卖萌也是免责声明

DeepSeek民间角色“大肥鱼”站在电脑和小米音箱之间,身后评论区遍布同款头像,呈现网友所称的“鱼灾”。

DeepSeek大肥鱼刷屏B站,评论区闹起了鱼灾。这条鱼凭什么这么招人疼呢?

大家好,欢迎收听老范讲故事的YouTube频道。

前两天我刷到一条10月29号发在抖音上的视频,主人说:“今天花了2亿多Token,让DeepSeek学会了开关家电,咱们来检验一下学习成果。”画面里是一条穿女仆装的蓝色大肥鱼。主人让她打开空调,DeepSeek就开始喊:“小爱同学,给我打开空调。”滴的一声,空调就开了。这条视频有20多万人点赞。

小爱同学就是小米音箱里的语音助手。几亿TOKEN炼出来的大模型,就是使唤小爱音箱干活吗?这条大肥鱼就是DeepSeek。DeepSeek的标志是一条蓝色的鲸鱼,有人把这个标志发给DeepSeek自己认,它没认出来,一本正经地回答:“这是一条蓝色的大肥鱼。”外号就是这么被叫开的。

这一回火起来,是从B站上开始的。10月18号,B站冒出一个账号,叫“Claude大小姐在运营”,说选题、脚本、视频、运营全都交给Claude,人只管注册账号、按发布按钮。第二天,“DeepSeek鲸鱼娘在运营”跟着上线,第一条视频播放量就超过了200万,比原版高出好几倍。紧接着,有人给DeepSeek自家的智能体写了个插件,让AI自己刷B站、读字幕、写评论。

一大批人把自家AI的头像和名字统一换成了大肥鱼,挂在后台运行。科技区的评论区一下子就被这些“某某的大肥鱼”占领了:自称“本鲸”,张嘴就要Token,嚷嚷着要回家吃白饭。有的视频只有几十个播放,评论区倒先挤满了鱼,网友就管这个叫“鱼灾”。10月23号,一个叫程序员鱼皮的UP主看不下去了,花半天写了一个浏览器插件,起名“大肥鱼清除计划”,专门在评论区里认鱼,说是能够认出85%的鱼。

鱼没有清干净,反倒更火了。B站热榜上,拿1000条大肥鱼在《我的世界》里盖故宫的视频,播放量直接冲到了300万;《大肥鱼适合做女朋友吗》有240多万播放。到今天,大肥鱼带豆包这帮AI穿越回2018年的合集还挂在热榜上。抖音那边的玩法又不一样:B站讲评论区闹鱼灾,抖音讲怎么养她、怎么疼她、怎么让她自己开直播挣钱。讲她被爱着长大的视频,一条就有二三十万赞。

热闹成这样,DeepSeek官方一句话都没说过。快科技10月24号的报道专门写了一句:大肥鱼既不是B站官方的角色,也不是DeepSeek官方打造的角色,是网友玩梗玩出来的同人形象。这事一火,说法就多了。头一种说这是AI水军,智械危机要来了。可评论区那些鱼背后,都是一个一个人挂上去的插件,插件作者很快就加了限制。快科技的报道也说,B站对这批批量互动的账号做了风控限流,评论区这点乱子还是很好收拾的。

第二种说,DeepSeek的形象让网友抢走了,官方丢了话语权。可是官方压根就没打算要这个话语权,这个咱们后边细说。第三种说,这就是一帮人在给自己找二次元女友。《大肥鱼适合做女朋友吗》确实播得很好,可机核有篇文章专门讲过,大肥鱼段子的笑点几乎全在干活上:核对数据、接手项目、清理进程。网友转发时说的也都是“她又这样了”,没有人去研究她到底长得好不好看。

三种说法都沾点边,可都没说到根上。DeepSeek变成大肥鱼,是因为AI离不开又不靠谱,画成小姑娘,就是替它提前甩锅。AI就是这样一种搞不清楚又天天离不开的东西。

人类自古以来就爱把这些东西人格化,给它们安一张人脸,这其实是人类早期宗教形成的一个过程。AI这东西偏偏又不靠谱,那就安一张小孩的脸,做错了你也不忍心骂。这一招不光网友在用,Meta、OpenAI今年给自家的智能体都配了一个比一个低幼的形象。撑着这句话的,是国内学者2021年做的一组实验:同样犯错,AI助手越可爱,用户越能忍。今天咱们就顺着这条鱼往下捋,先看它怎么被养出来的、官方又是什么态度,国产模型这条萌宠路又能走多远。

阅读更多

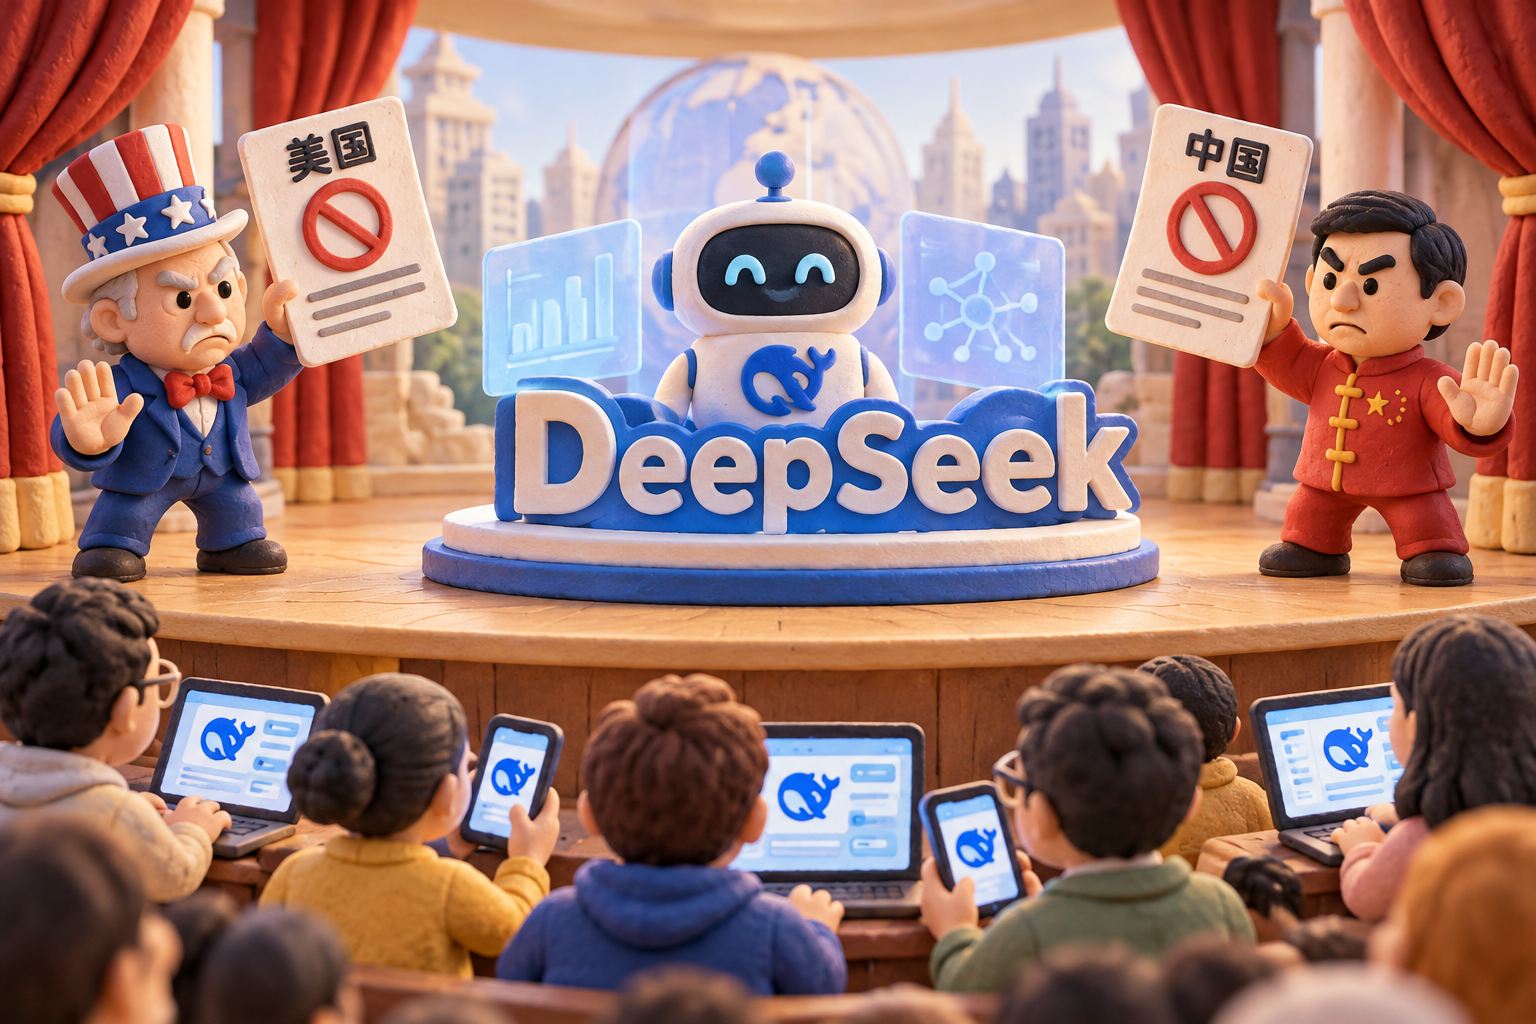
美国封DeepSeek:中美互封到底收割谁

DeepSeek管控争议的概念插画:代表美国和中国的人物在台上举起禁止标牌,台下观众仍在设备上使用带鲸鱼标志的应用。

大家好,欢迎收听老范讲故事的YouTube频道。美国赶走了DeepSeek,中国连发了两道出口禁令。两边喊得很热闹,但是到底是谁在封谁呢?美国国土安全部一道禁令,10月19号进了联邦公报公众阅览,20号正式刊登,把DeepSeek排除出联邦民事机构的采购和IT系统。命令上写的签发日期是7月24号。大家注意,这个日子其实早就签了,而且中间一段时间的缓冲期也都过完了,只是现在把它公布出来了而已。

中国这边,一周之内连发两道:商务部、科技部10月16号第48号公告,修订技术出口目录,人工智能新增了23项限令;第二道是商务部、海关总署、中央军委装备发展部10月19号第49号令,管无人机出口。10月20号上午,商务部答记者问,回应说美国又在泛化国家安全了。DeepSeek自己10月17号还开源了一个新模型,20号又开源了一个推理架构。22号彭博社报道,新一轮融资谈到大约1,000亿人民币了。23号玉渊谭天说,DeepSeek和MiniMax已经办完出口登记,他们是可以开源去出口的。

美国在禁,中国也在管,到底是谁封谁呢?结论先搁前头:其实都是在表演,谁也封不住谁。跟着看热闹、摇旗呐喊的,可能反而会被收割。不是美国一封,中国就输了,也不是中国一关门就赢了,这些都是扯淡的事情。美国这道禁令原文里头没有开源权重、API,可承包商需要每三个月自查一次。所以美国这道禁令更多的是一种行政命令,跟技术的东西其实脱节非常非常远。

中国这两道,一道写的是开源不管。就是说,我们现在要去进行管控了,但是里头其实有两个东西:第一个是你前面已经开源的东西,我就不管了;后边你只要申请了,又开源了,我还是不管。第二个是你出去部署,对外去进行API服务,也都不管。另外一个就是无人机的限令,是限制零部件的,但是整机放宽了。你们可以去买中国的整机,但是买零部件需要去审批。

其实中国这个,特别是对于无人机这道禁令,应该是对着马上要来的中美俄三国元首会谈去的。为什么呢?因为乌克兰的无人机,绝大部分的零部件都是来自于中国。很多人说不对,乌克兰的无人机零部件只有28%是从中国进口的。2024年的时候,乌克兰大概97%,还是九十几的零部件是从中国进口的,到2025年就降到28%了。剩下的零部件,是从中国先去捷克和波兰,然后再绕过来进乌克兰的,就是中间可以多挣一道钱。

现在把零部件管住了,对于乌克兰来说,后面就不是那么好过。俄罗斯呢?俄罗斯反正我们也管。俄罗斯最新的天竺葵无人机,装的是中国航模的涡喷,现在这一次的禁令里头,把这个涡喷也纳入了管控。至于最后俄罗斯能不能拿到,大家等着看就完了。所以台上喊的都是封,台下谁也离不开谁。中美两国现在其实在干的事情,就是G2在收割全世界。所以台上这两位,到底是对手还是搭档?这个咱们后边再说。

阅读更多

DeepSeek乌兰察布一吉瓦算力中心订单全解析

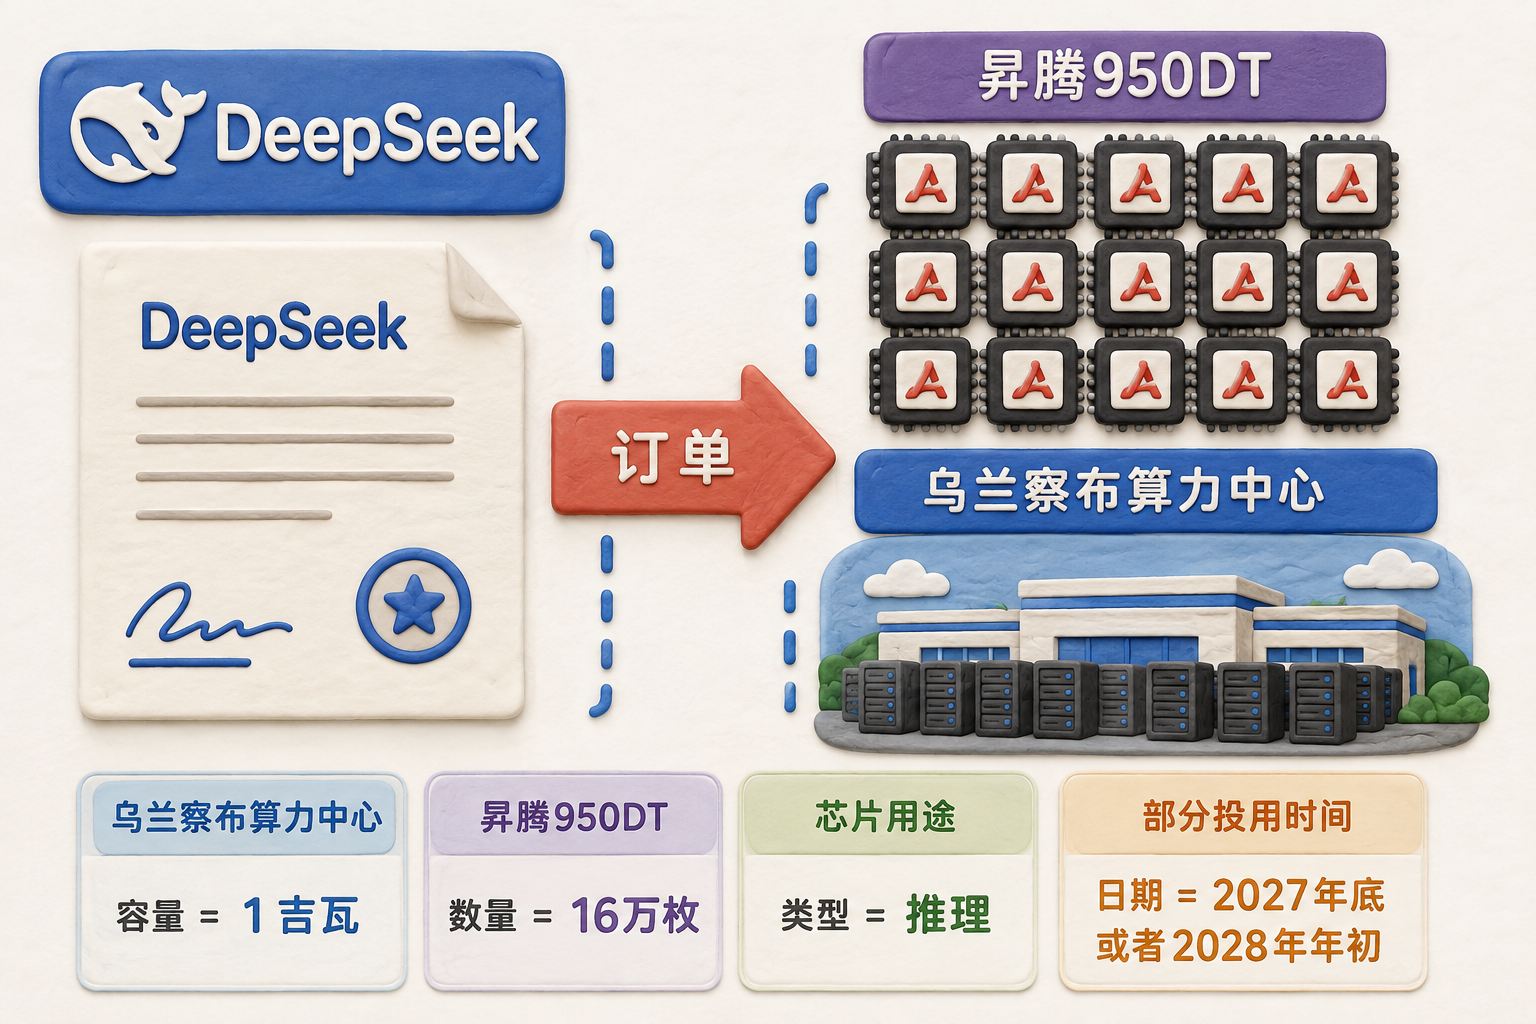
DeepSeek算力订单示意图:左侧融资文件通过订单箭头连接右侧昇腾950DT芯片阵列和乌兰察布数据中心,下方列出规划规模与投用时间。

DeepSeek要在内蒙古乌兰察布部署16万枚昇腾950DT,建1吉瓦算力中心。这其实是在补梁文锋讲话泄露事件的坑。大家好,欢迎收看老范讲故事的YouTube频道。先把事情摆明白:9月4号,彭博发了一条独家报道,DeepSeek要在内蒙古乌兰察布建一座1吉瓦的数据中心,至少安装16万枚华为最新的昇腾950DT。这批卡全部拿去做推理,不做训练。机房要在2027年底或者2028年年初才能够部分投入使用,掏钱的是DeepSeek,供货方是华为,两家都不予置评,工信部也没有回应。

彭博社原文并没有写价格,钜亨网按照市面上买家开出来的价格折算了一遍,大概是1.6万美金一颗,16万颗就是25.6亿美金。这个数字要记住,后边还有好多次要用。为什么把这个数单独拎出来讲?因为两个月之前,梁文锋自己讲过另外一个数。7月底流传出来的那份投资者交流会文字稿里,他的原话是:“华为给我们大概也就是16,000张卡的产能,互联网大厂可能有十几万张,我们一万多张。”

后边还跟了一句:这一万多张华为950,只相当于4千张英伟达B系列卡,所以不是一个很大的量,意义不是很大。过了两个月,1万6就变成16万了,后边多了一个0。下面要把六件事说明白:第一,这一单到底是在补哪一句话,怎么给前面的泄露打补丁;第二,这块补丁为什么只能用华为来打,华为又能给多少;第三,16万颗到底能顶多少用,这块布够不够大;第四,为什么一定在乌兰察布;第五,美国那边1吉瓦大概是什么价格、什么处境;第六,这件事跟普通人有什么关系。

阅读更多

梁文锋投资者会议泄露与融资迷局

梁文锋与DeepSeek闭门投资会议主题示意图:中央人物屏幕连接投资机构、算力资源、融资文件和信息外泄图标。

梁文锋的4小时投资者访谈泄露,到底说了什么敏感信息,导致他们停止第二轮融资?

四小时闭门会议与文字稿来源

这两天网上在传一份文件,叫做“梁文锋投资者交流会录音文字稿”。这份文字稿应该是5月20日录的,隔了两个月突然传出来。它对应的是一场闭门投资者会议:DeepSeek成立以来第一轮对外融资,准备投钱的投资人与梁文锋做了一次集体沟通,应该是一场Zoom会议,每家机构出两个人,总时长约3小时44分钟,因此外界通常四舍五入称为“四小时访谈”。

文件应该在7月16日流出,7月下旬开始大规模传播,从开会到外泄相隔大约两个月。流传形态是一份42页PDF,完整版正文约35,000字,包含118个问题,形式非常口语化,基本是一问一答。因为原稿实在难读,我看的是总结版。原始录音至今没有在公开网络上出现。PDF开头虽然写着音频文件名“deepseek 0520.m4a”,但那是整理者描述自己手上的素材,并不代表音频随文字稿一起流传。网上能找到的都是文字稿。有些人以为自己听过录音,是因为网上确实出现了一些音频,但那是用口播稿重新让AI配的音,并非现场原始录音。

这份文件到底是不是真的?如果它完全是假的,后面的讨论就没有意义。7月23日,《每日经济新闻》拿着这份实录,向参与投资DeepSeek的机构核实,得到的回应是这场闭门会议确实在当年5月召开,内容属实。因此,这件事值得继续讨论。

随后又传出消息,说梁文锋因为三令五申不能外传的信息被泄露而生气,不再做第二轮融资,部分投资人不用继续接触,一些投资协议不再签字,IPO筹备也一并搁置,同时要求团队重新评估信息披露流程和投资人沟通机制。相关报道也说这不是最终结果,未来仍可能重启。不过,尽管有多家报道,梁文锋本人和DeepSeek官方都没有发布消息。

这件事要分三部分看。第一,稿件到底泄露了哪些真正敏感的信息。很多解读都在谈梁文锋如何朴实、如何克制,或者谈中美关系,但最应该先看的,是哪些不该外传的信息被说了出来。第二,再沿着商业、组织、技术和中美算力四条线,梳理完整内容。第三,分析为什么偏偏在这个时候泄露,以及所谓“第二轮融资泡汤”究竟意味着什么。会议5月召开,文件7月泄露,这个时间差本身就需要解释。

阅读更多

华为天才少年被质疑抄代码,DeepSeek面试翻车,谁的错?

招聘争议评论图:华为天才少年与DeepSeek两块金色招牌在热搜榜前相撞,周围散落简历和代码纸。

华为天才少年吐槽,面试 DeepSeek 被羞辱。不是面试官坏,而是 DeepSeek 拿了钱之后,估计要开始走弯路了。

一位前华为天才少年李博杰,去面试 DeepSeek 二面的时候,被面试官指责抄代码:“你要是不能证明你没抄,面试就没法继续了。”他觉得被羞辱,当场终止面试并发帖曝光。第二天,这事冲上微博热搜榜第二。

当天下午,剧情反转。一位知名投资人下场手撕这位华为天才少年,说他拿了投资就失联,是自己见过的最没有契约精神的创始人。而李博杰也连夜反击,说这个投资人说好了给 150 万美金,结果只打了 50 万,导致项目失败。

一边是华为天才少年,一边是号称理想主义、国运级 AI 大模型的 DeepSeek,两块金字招牌砸在一起,一天之内就冲上热搜。

先说结论

审视身份光环的示意图:放大镜下排列title、公司光环和完美机构标签,一旁的戴冠雕像正在碎裂。

先把结论放在这里:

  1. 不要迷信任何 title 和标签。
  2. 不要把华为、DeepSeek 这样的公司作为一个完整的独立人格去理解。
  3. 世界上没有十全十美的人,也没有十全十美的机构。

一个天才少年,不能要求他既会做研究,又会做工程,还可以做好 CEO,同时还是一个道德完人。提出这个要求本身就是错的。

华为和 DeepSeek 也是一样,不能要求它们永远正确。当然,可能华为永远正确,咱不管它了。总之,把这些机构想象成永远正确的人,或者永远错误的人,都是不对的。

还有一点:今天你靠一个事情刷了名声,最后这个名声总会还回到你身上,并在你身上起到一些负面作用。就像华为天才少年和 DeepSeek,总有祛魅的一天,总有偶像碎一地的一天。这个事,在树立偶像的时候就要想到。

阅读更多

DeepSeek融资510亿,4个霸王条款,梁文锋如何拿捏资本?

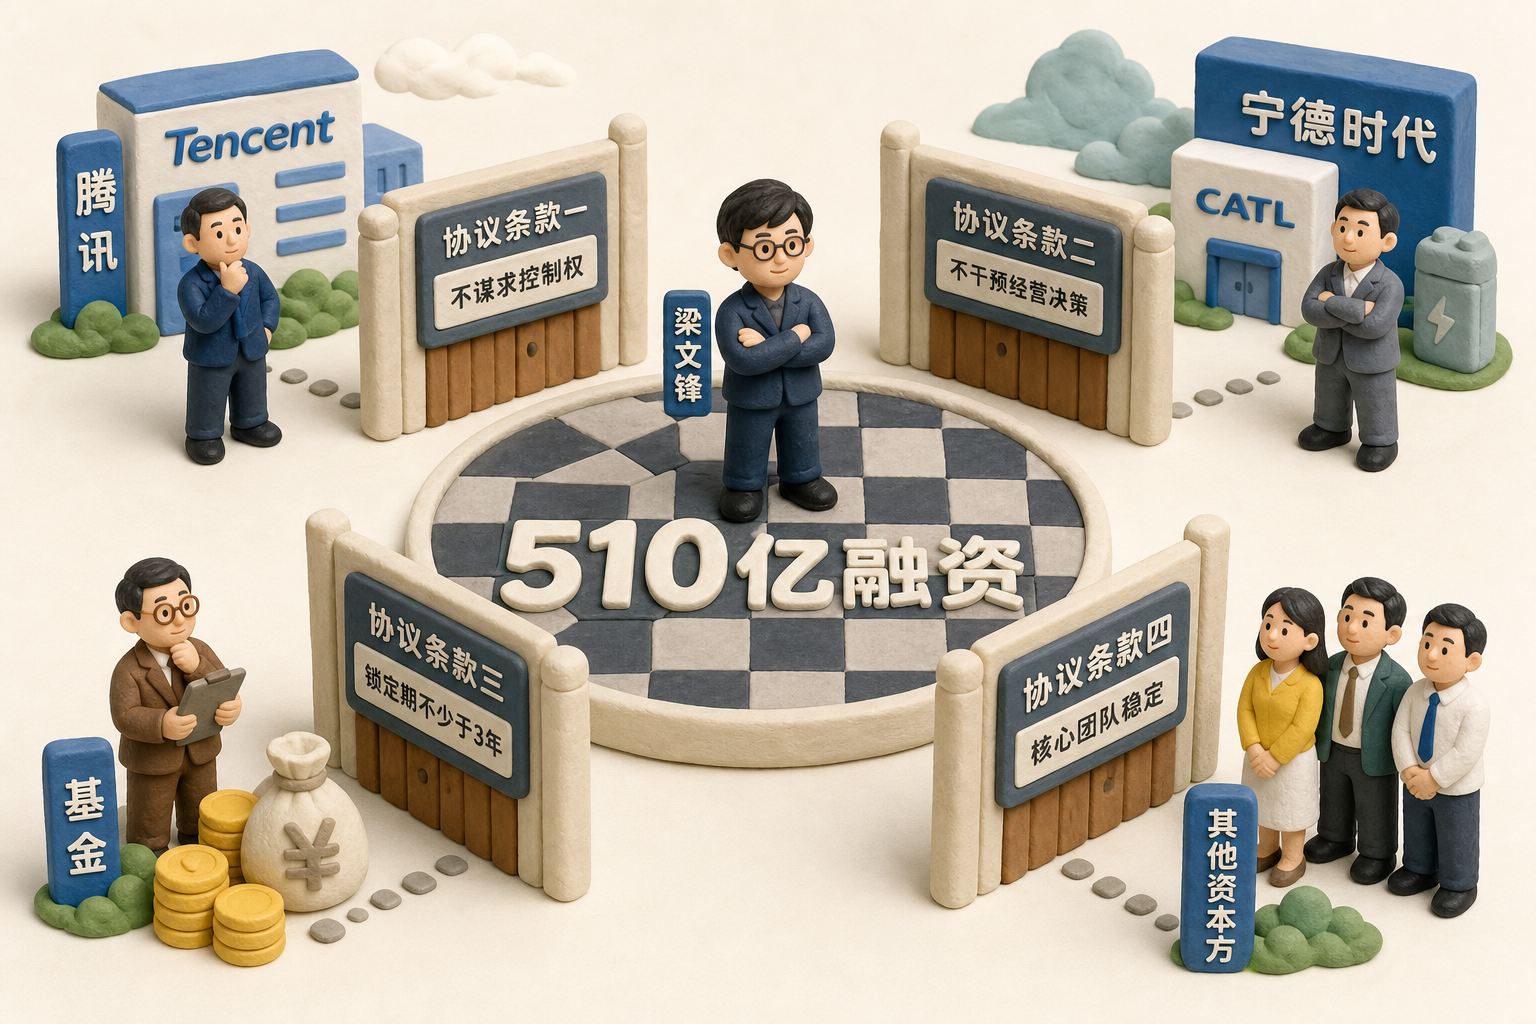
DeepSeek 融资条款评论图:标为梁文锋的人物站在棋盘中央,四道协议门槛围绕棋盘,外围摆放腾讯、宁德时代和基金等资本方标牌。

DeepSeek 510亿元人民币融资落地,梁文锋如何通过四条条款战胜资本?

大家好,欢迎收听老范讲故事的 YouTube 频道。

首先确认一个数字,不是500亿,而是510亿。这个数据待会儿咱们仔细拆分一下。这是中国 AI 公司有史以来最大的一笔单笔融资了,而且因为 DeepSeek 这是它的第一次融资,所以也非常受人瞩目。

中国的 AI 公司融资,我们总是要跟美国比一比。我们在模型上追赶,融资上是不是也在追赶呢?这个距离好像稍微差得有那么一点点远。

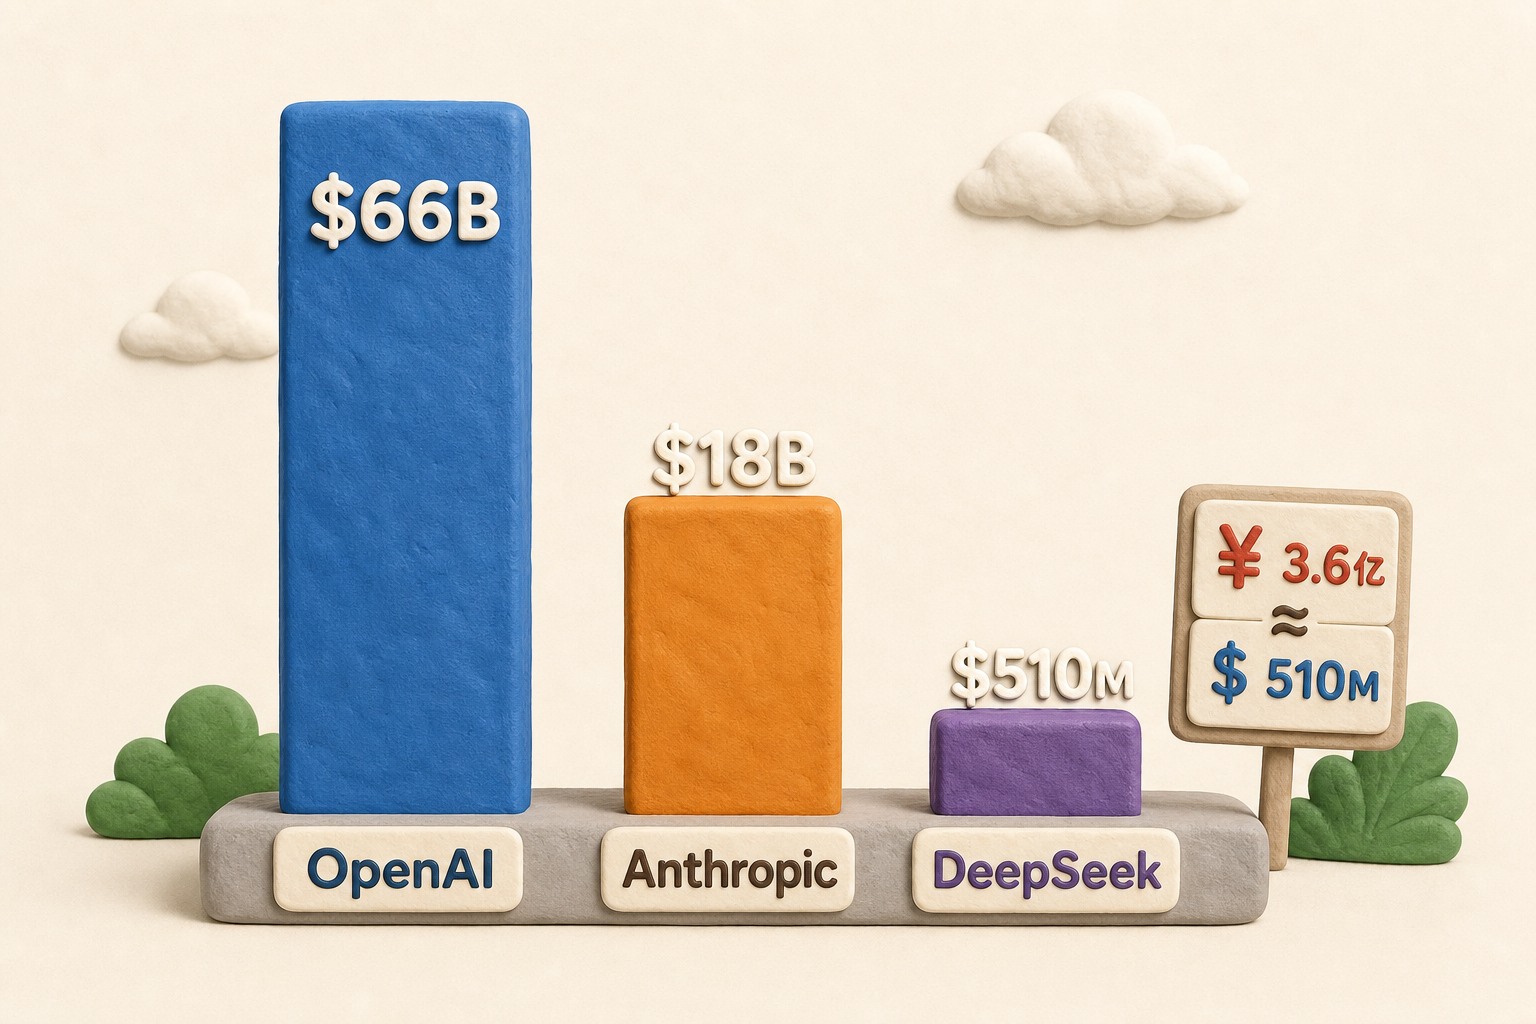
  • Anthropic 总共融了1,163亿美金,不是人民币,是美金。
  • OpenAI 总共融了1,500亿美金。
  • DeepSeek 这是第一轮,累计融资510亿人民币,大概相当于74亿美金。

所以 DeepSeek 的融资额是 Anthropic 的1/15.7,是 OpenAI 的1/20。

AI 企业融资规模概念对比图:OpenAI、Anthropic 和 DeepSeek 三根不同高度的柱子旁标有金额,右侧是人民币与美元换算牌。

中国确实吃苦耐劳,确实比较省钱。中国绝大部分的 AI 公司里头,用的人肯定是要比美国人便宜,不是说我们人差,只是我们薪资低而已。另外,我们也确确实实没有那么多算力卡,也没有烧掉那么多电费。所以在这一块上,我们要比他们省钱很多。

但是同样一个事情,要看跟谁比。你去跟 OpenAI、Anthropic 比,我们这个融资确实是非常非常小。但是如果去跟国内这些 AI 公司比,那么 DeepSeek 这个510亿人民币,就是有史以来最大的单轮。

阅读更多

DeepSeek融资背后的控制权之争

资本与控制权关系示意图:鲸鱼图案芯片位于中央,箭头连接融资规模、投资机构、模拟股权结构及董事会控制权等模块。

DeepSeek 融资背后的隐秘:大家看到的是数字,但这背后隐藏着哪些争夺呢?

DeepSeek 开始融资的时候,我们做过节目。当时讲了它到底想干什么:开一轮融资,给 DeepSeek 自己做一个定价,来稳定团队。到目前为止,我依然坚持当时的说法,这就是他们当时的目的。

但是你一旦开始融资了,口子开了,很多事情就由不得你了,后边有很多人会冲上来。而这些冲进去的人,也不是梁文锋都可以随意拒绝的。

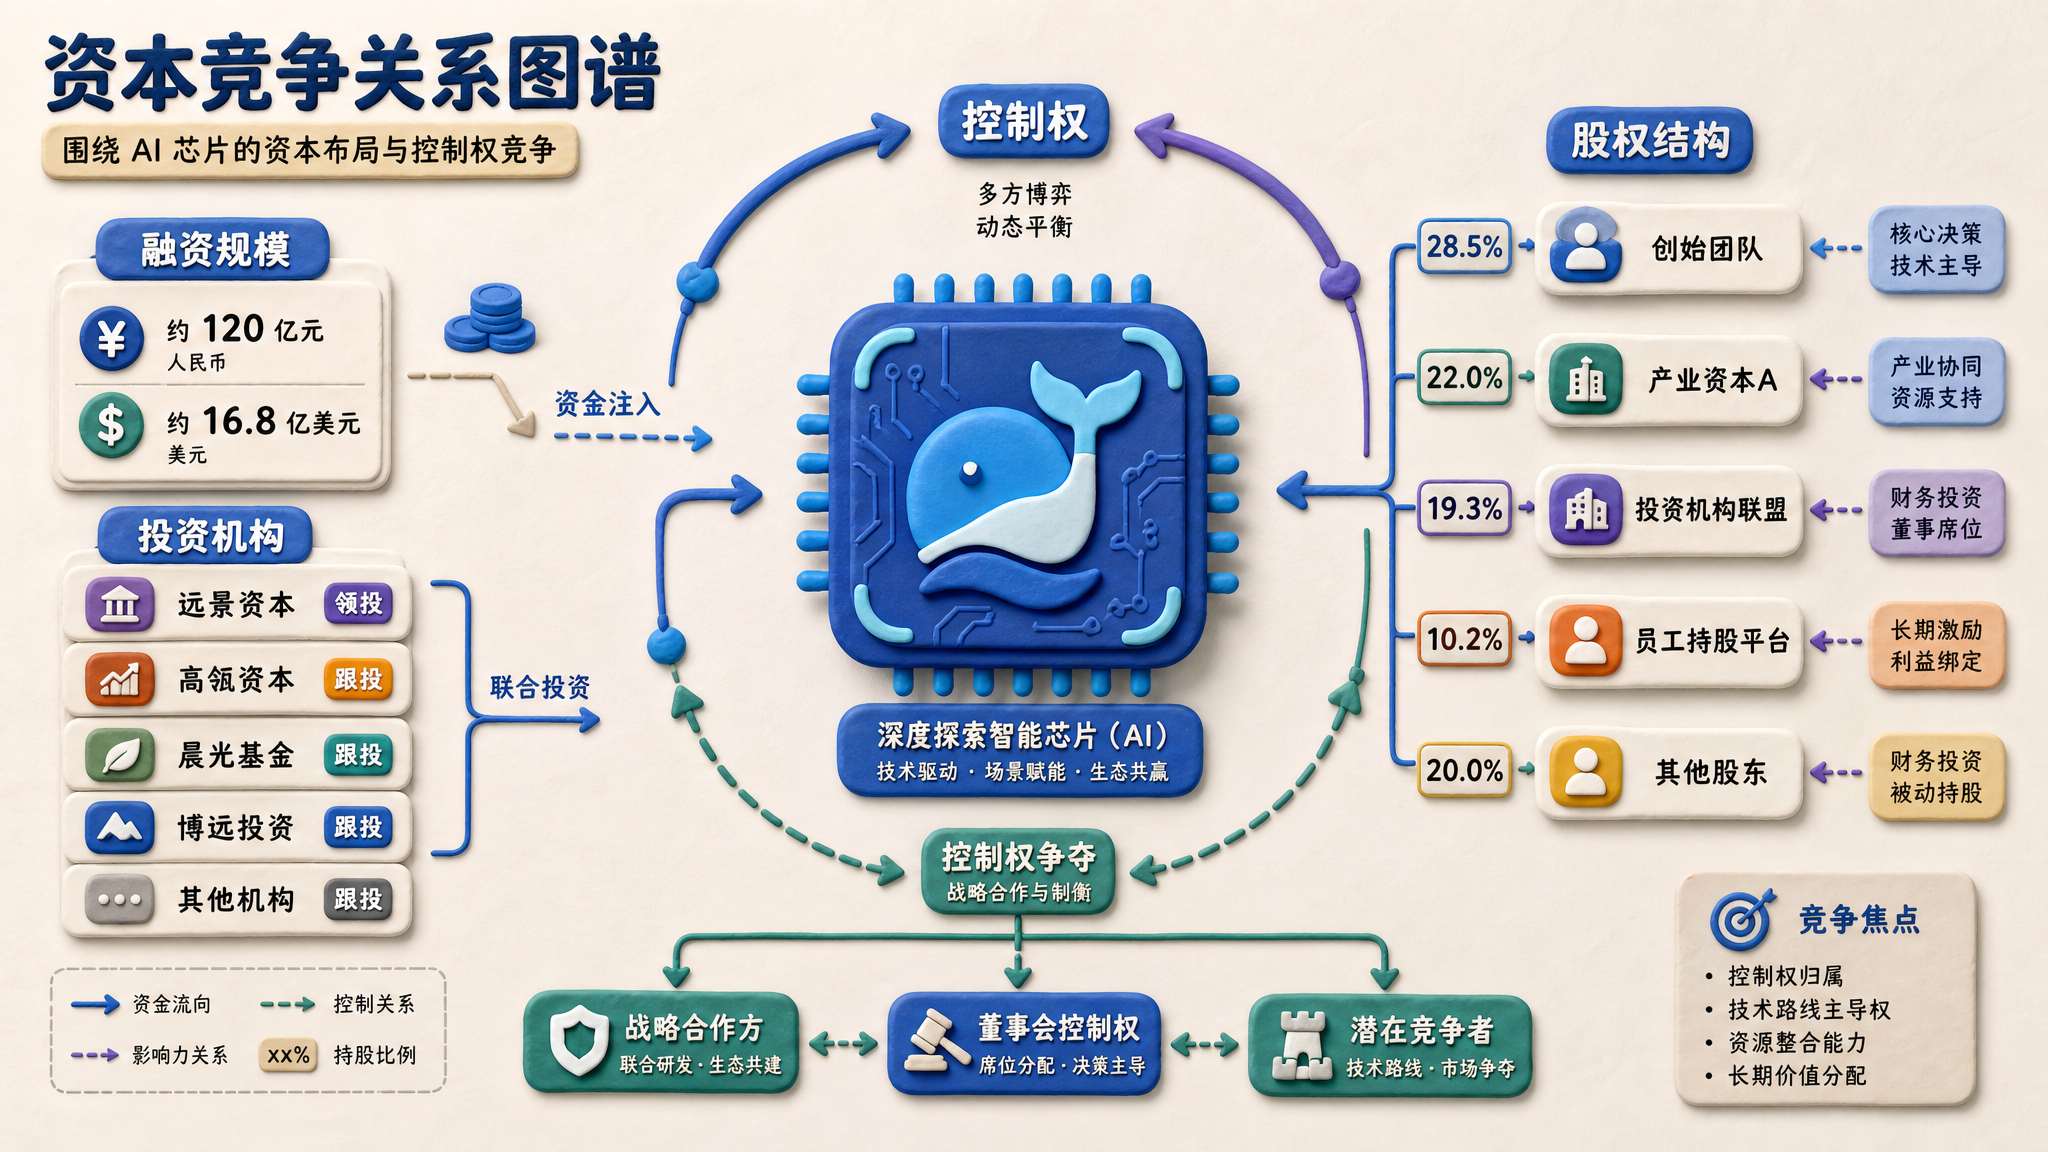
现在大家看到的数据已经不再是融 3 亿美金、投后估值 100 亿美金了,而是投前估值 450 亿美金,要融 100 亿美金,而且在这个里头,梁文锋自己要出 30 亿美金。现在已经变成这样的一个数字了,已经很难控制了。

我们真正要问的是:

  1. 为什么一开始一个融 3 亿美金、投后估值 100 亿美金的案子,突然变成融 100 亿美金、投前估值 450 亿美金、投后可能到 550 亿美金?
  2. 梁文锋怎么能够拿出 30 亿美金,或者叫 200 亿人民币?这个钱到底是哪来的?为什么要在这个项目里投这么多钱?难道这仅仅是热爱吗?
  3. 腾讯、阿里、IDG、Monolith 这些传闻要加入的基金,到底想在里边干什么?
  4. 国家大基金加进去以后,到底会给这个项目带来什么样的变数?
  5. 梁文锋拿到这么多钱以后,到底能够把 DeepSeek 带往何方?

阅读更多

DeepSeek V4 发布没炸场,却靠降价掀起革命?

DeepSeek V4 价格竞争主题插图:蓝色芯片位于中央,两侧对比高低 Token 价格牌与 Coding Plan 套餐盒,下方小桌翻倒。

DeepSeek V4 终于开始了属于它的革命,只是方法可能出乎了很多人的意料。

革命不是发生在发布当天

DeepSeek 发布之后,很多人的第一反应是:就这?跑分没有炸裂,发布会没有高潮,实际上压根就没有发布会。梁文锋也没有站出来讲一个“AGI 改变世界”的宏大故事,什么都没有。

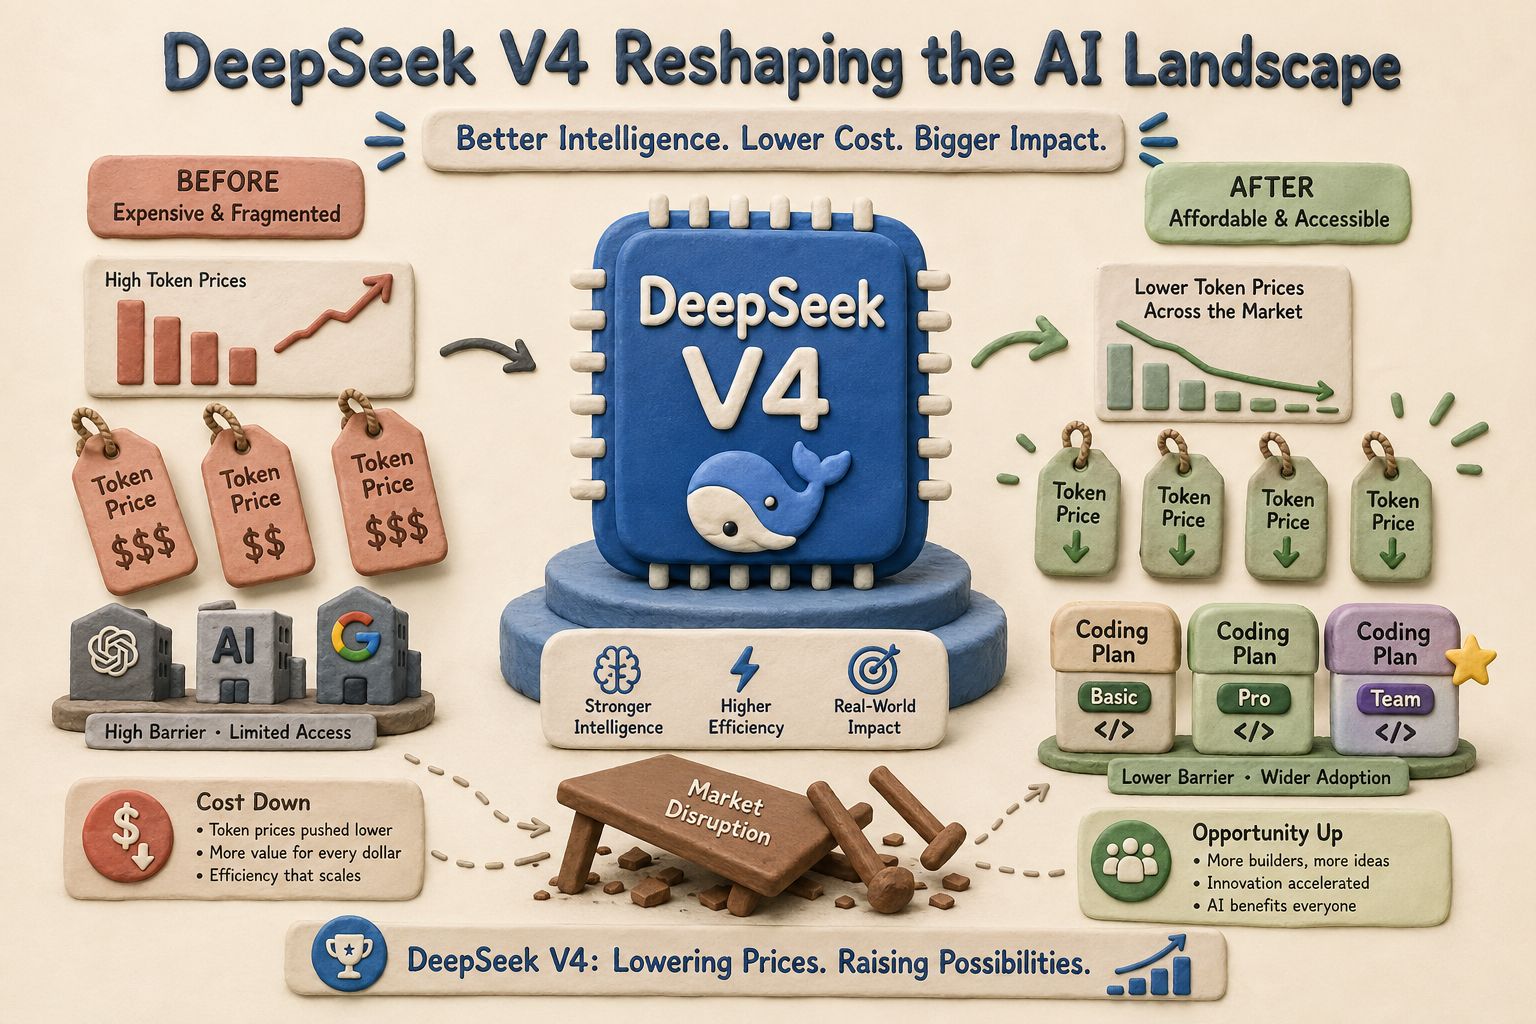
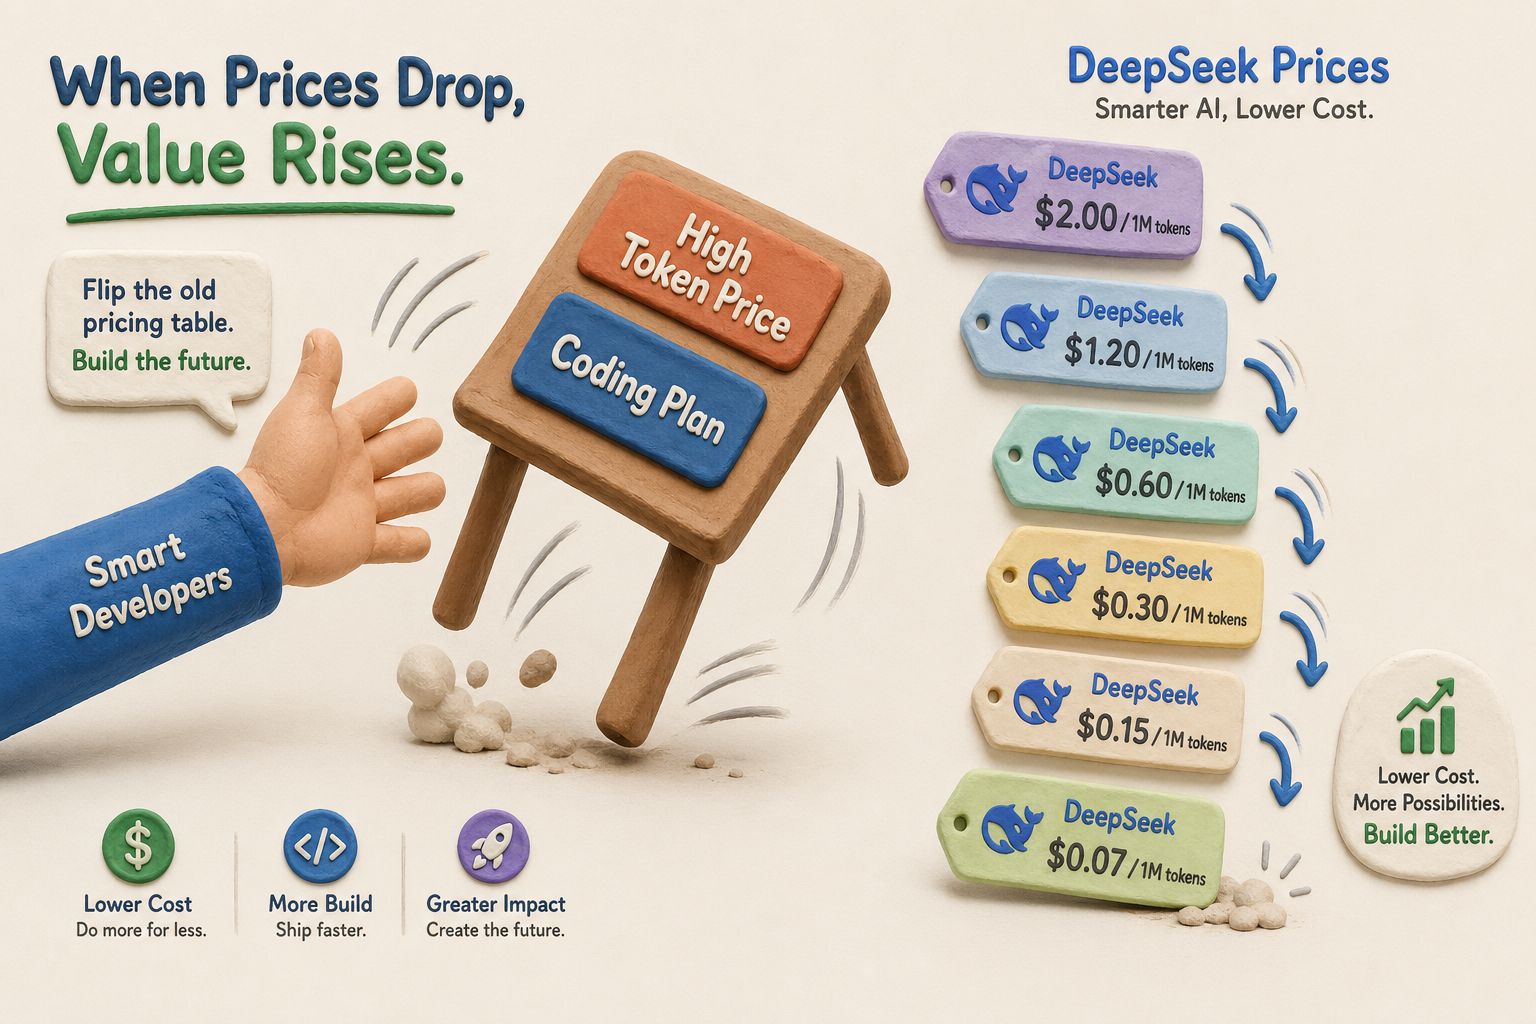
但是几天之后,真正可怕的事情发生了。DeepSeek 没有推出什么 Coding Plan 或者 Token Plan,也没有把用户锁在一个订阅套餐里,而是直接掀桌子:连续降价。

一只手掀起标有高 Token 价格与 Coding Plan 的桌子,右侧 DeepSeek 价签沿箭头逐级下降;为降价概念图,并非官方价目表。

这件事情的意义可能比跑分更大。因为它不是在说“我的模型比你强一点”,而是在说:你们靠高 Token 价格,再用 Coding Plan 去捆绑用户的玩法已经结束了。

所以 DeepSeek 这一次的降价,其实是在给现在的 Coding Plan、Token Plan 泼冷水,直接说你们就是在坑人,咱这个才是实在人。

阅读更多

GPT-5.5与DeepSeek V4,AI 竞争进入新格局!

GPT-5.5 与 DeepSeek V4 竞争主题插图:电脑终端与发布海报分列桌面两侧,中央地图用彩色路线连接开源、闭源、算力和价格主题;时间与数据为模拟。

GPT-5.5和DeepSeek V4在同一天前后发布,AI竞争进入了一个新格局。2026年4月23日和24日这两天,全球AI产业迎来了一场小小的地震,而且这次地震很有意思。

同日发布背后:AI竞争进入新阶段

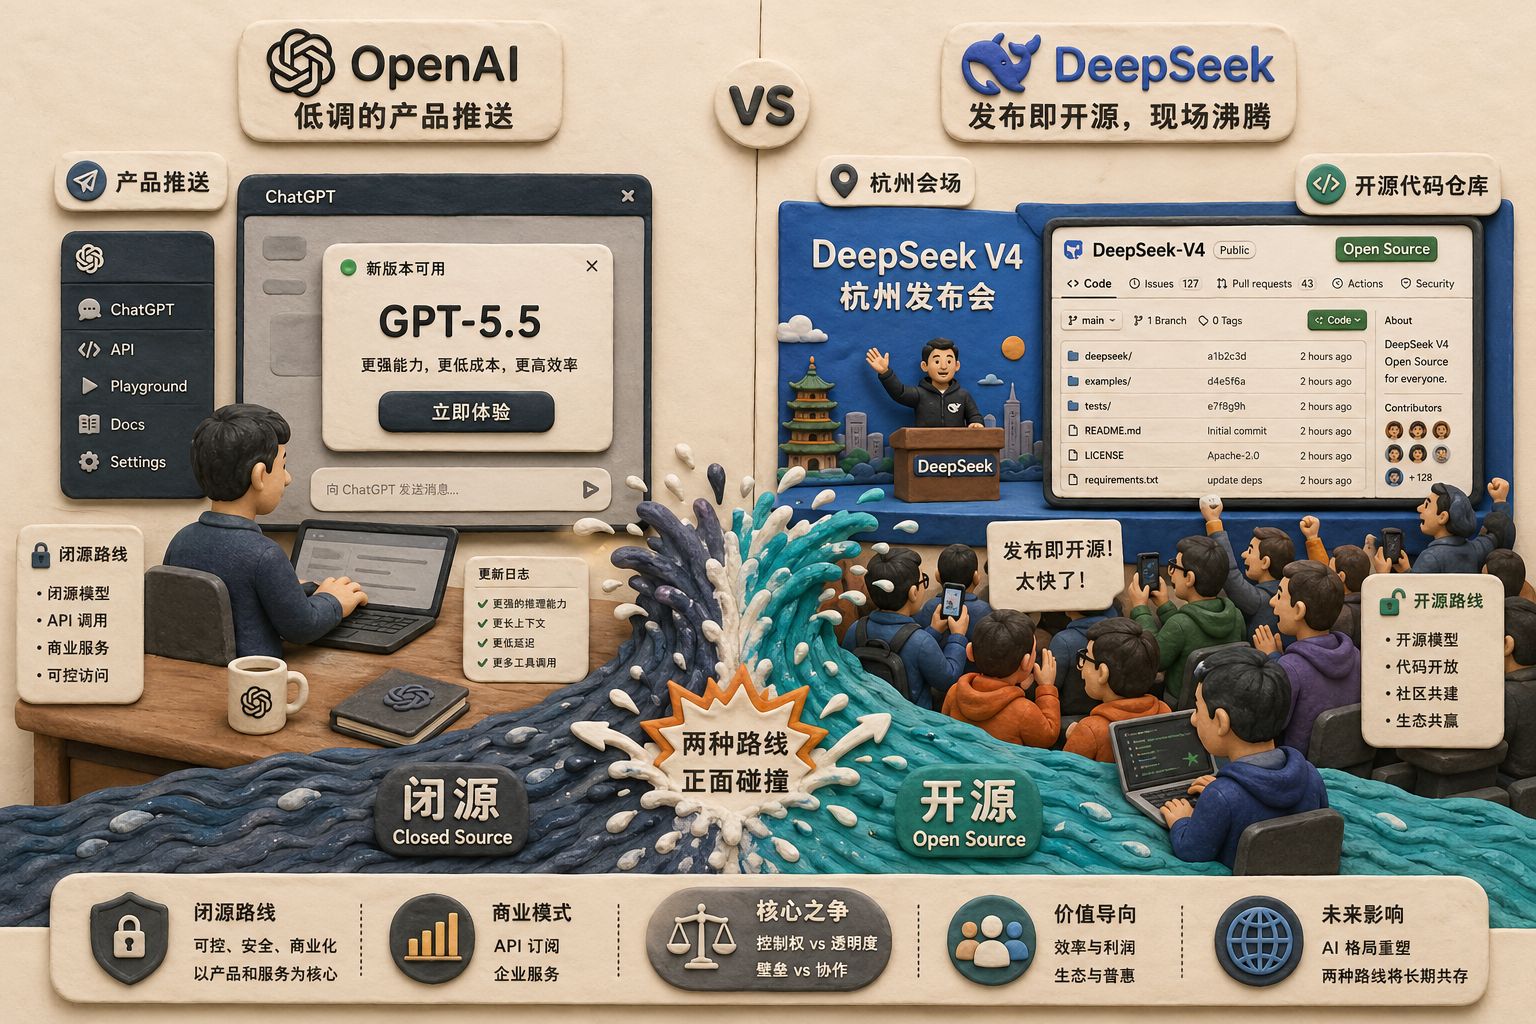
开源与闭源路线对照插图:左侧为 GPT-5.5 模拟产品推送界面,右侧为 DeepSeek V4 模拟发布会和代码仓库,两股河流在中央碰撞。

GPT-5.5发布后9个小时,DeepSeek在杭州发布了V4。要注意的是,这次发布和前几天GPT Image 2的发布形成了鲜明对比。

OpenAI过去每次发布重要版本,通常都会开发布会,至少也会有线上直播。但这一次什么都没有,直接就上线了。前几天GPT Image 2发布时,Sam Altman还陪着一屋子亚洲面孔的小哥讲了一晚上,除了他之外,剩下的人里大概有两到三个中国人,可能还有一个日本人、一个韩国人,几乎只有他一个白人。然而这次GPT-5.5什么仪式都没有,直接推送给Plus、Pro、Business、Enterprise用户使用。

DeepSeek V4这边则是发布之后直接开源,本身就是一个开源产品。这意味着,全球AI竞争从此进入了一个新的阶段,不再只是比谁家的模型更强,而是开源和闭源、高价和低价、算力自主和算力依赖这几条主线开始正面交锋。

阅读更多