这两天,判定模型Jev又刷屏了:极度便宜,极度高效。我们是不是又要见证历史了?
大家好,欢迎收听老范讲故事的YouTube频道。
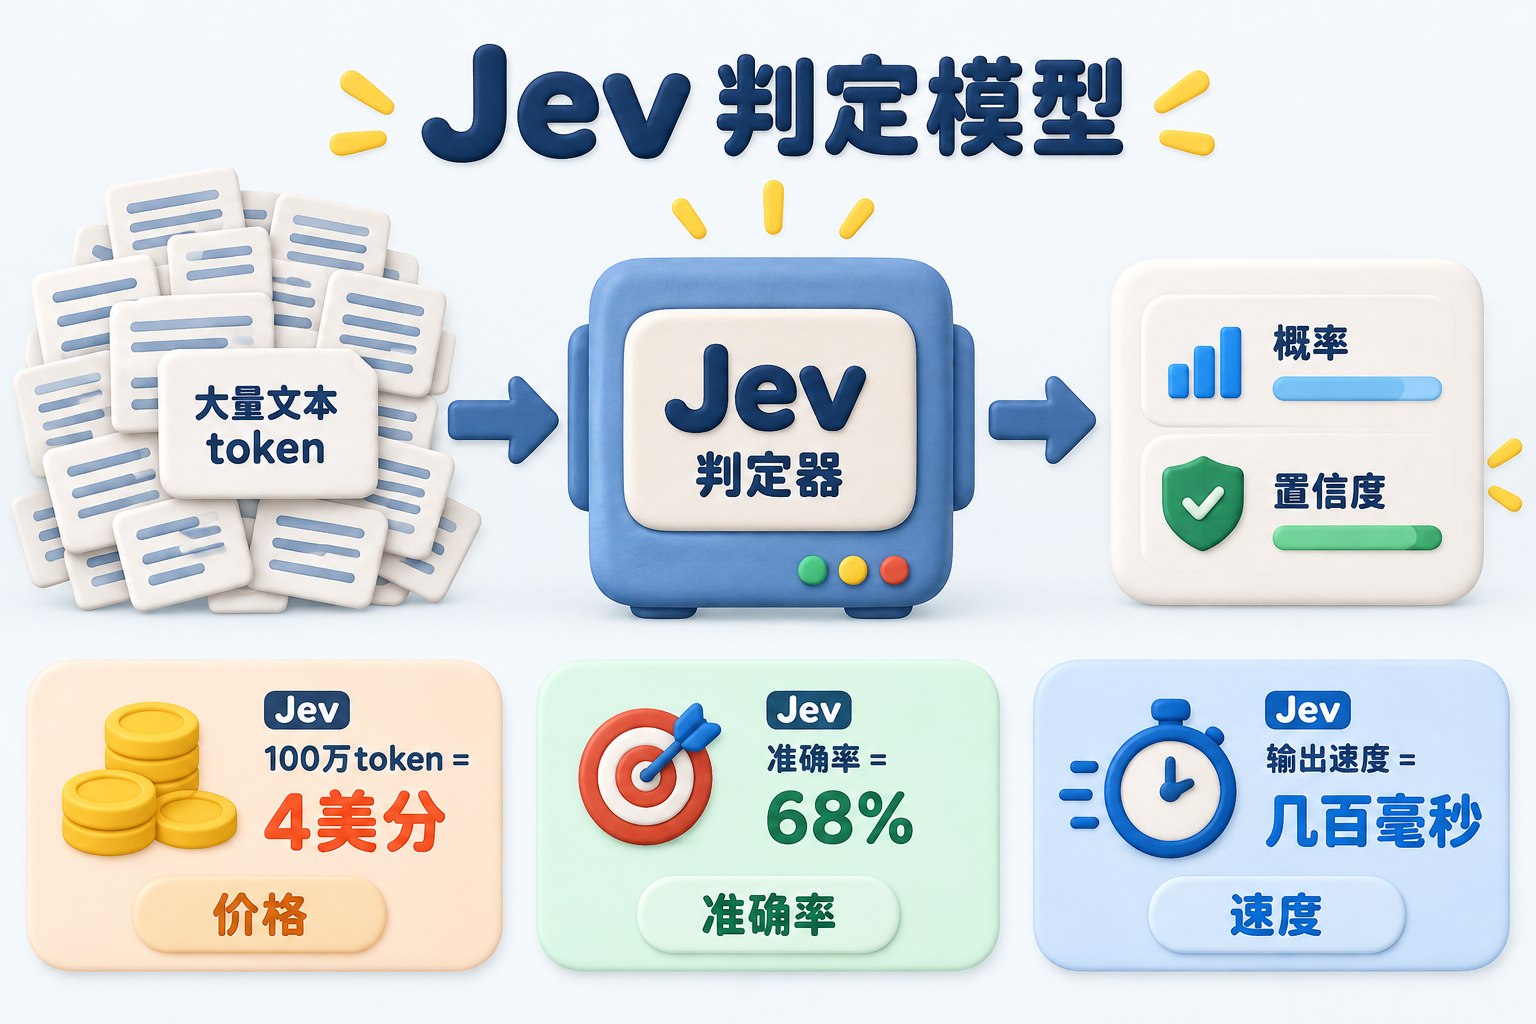
首先提醒大家一句,Jev确实非常便宜,100万token才4美分,而且效率极高,输入信息以后,几百毫秒就出结果。但是,它的准确率也就是68%,一定要小心,它有可能给我们带来巨大的灾难。
Jev这种模型跟传统的大语言模型LLM有一个最本质的区别:它不是生成内容的,只负责下判断,相当于是个判官。但是,这个判官的准确率就是68%。先把结论放在这里:这东西真好用,我自己已经放进流水线了;但是,它不是更聪明的大脑,而是把“下判断”这个岗位从大模型本身上拆下来单独卖,价格打到地板上。
它值钱的地方不是准,它并不比现在的大模型准,后边我们会说数据。它真正强的地方是便宜,便宜到以后什么事情都可以让它先判断一道。这个事我一开始还没注意,Discord上有人问我:“老范,现在Jev模型这么火,你不说两句吗?”当时我说没注意。我的很多选题都来自Discord群,大家看到什么有意思的事情,可以到这里问我;我觉得可以聊两句,就会研究一下,做成节目跟大家分享。刚刚老范透露了如何在节目里点单的流程,大家请记在小本本上。
今天分几段来讲。第一,Jev模型不能干什么,我们先把不能干的事说明白。第二,介绍一下这东西到底是什么、谁做的、名字从哪来,这部分尽量讲故事,具体细节不跟大家分享,因为人家也没公开。第三,我们的AI账单里到底应该用它替换哪一部分。第四,这东西到底怎么用。第五,它到底会如何改变AI产业,英伟达股票会涨还是会跌。最后,我们讲一下这个东西为什么很危险。
先泼三盆冷水:这些事不能交给Jev
先泼三盆冷水。Jev之所以突然爆火,一个很主要的原因,是很多币圈的人发现这玩意可以下判断,可以判断币要涨还是要跌,于是把它推火了。币圈的人一直非常热情,至于他们搞得懂搞不懂并不重要,但他们的热情很强,所以一下就推起来了。首先要讲清楚第一件事:这个东西不能用于炒币、炒股和量化交易。
人家发布产品的时候就说了,这个系统不擅长做算数,你要判断涨跌,别来找它,这玩意判断不准,gram。现在这些炒币的人已经灰溜溜地离开了,因为他们发现用这个东西判断炒币,效果很一般。第二,自动驾驶和人形机器人也不是这种模型擅长的事情。刚才说它快,几百毫秒就可以出结果,但快得看跟谁比。跟GPT、Claude比,它确实很快;跟自动驾驶比,这玩意就不行了。
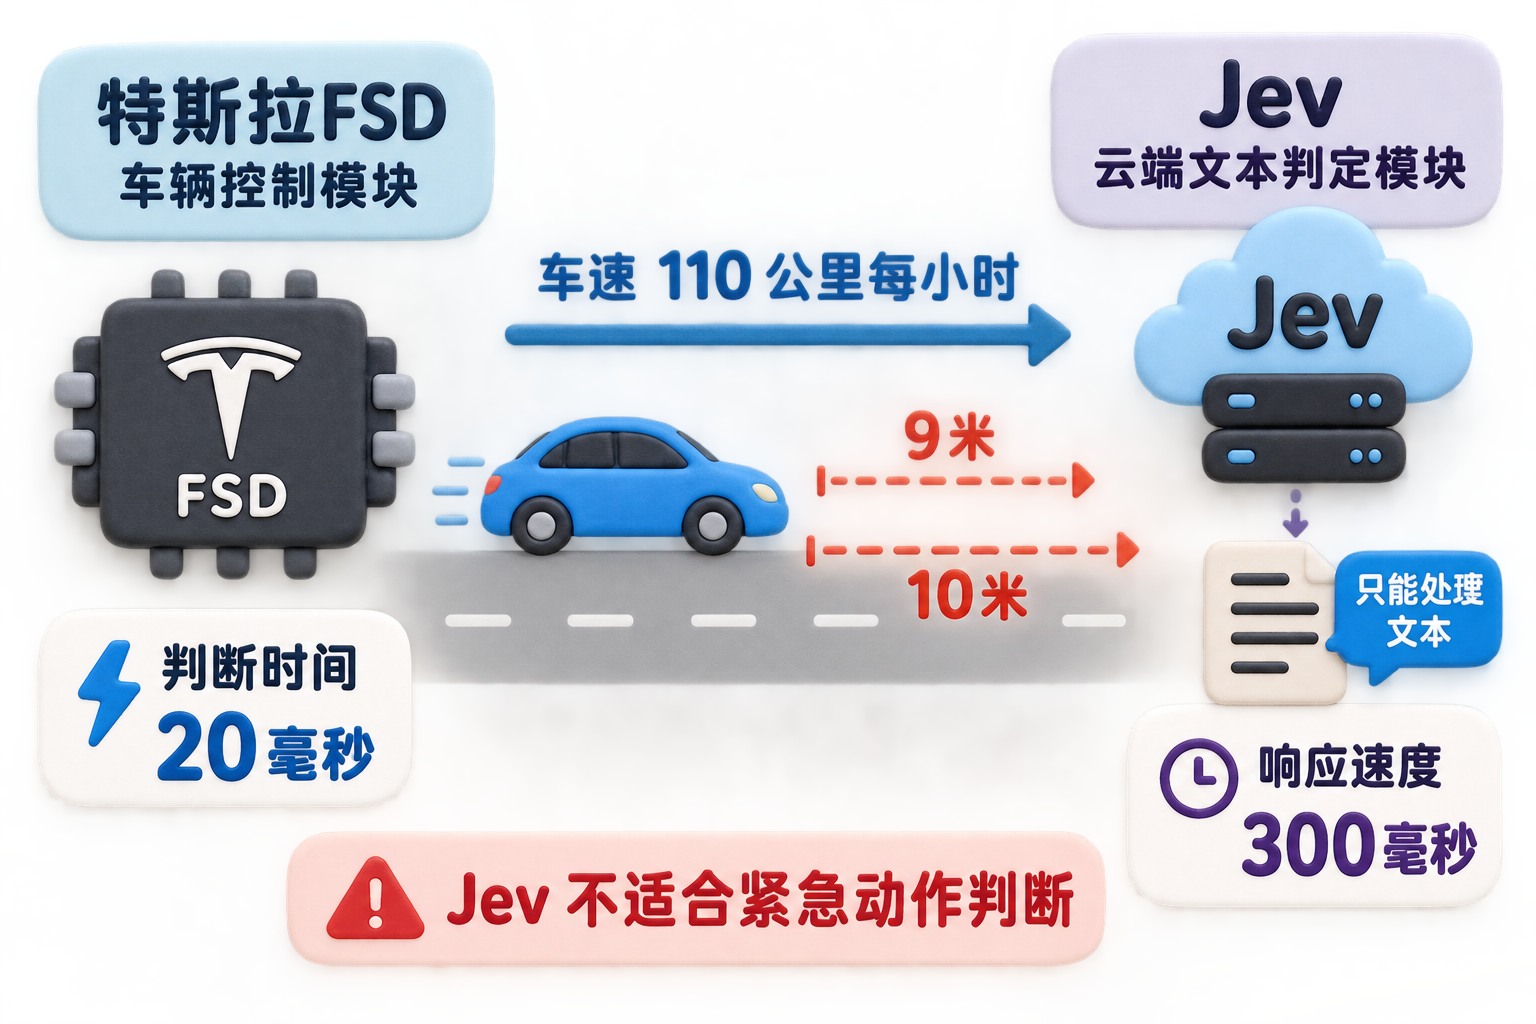
像特斯拉FSD,做判断只能有20毫秒,因为如果车开到110公里每小时,Jev这种300毫秒的响应速度,车已经开出去9米、10米了,该撞什么早撞上去了,所以这个事也不行。而且这个系统在云端,没有开源,万一网络不通,也是不行的。还有一点,Jev只能处理文本,不能处理图片、视频和声音,所以让它做自动驾驶、做机器人,搞不定。当然,自动驾驶和机器人里一些不那么着急的大逻辑判断,它可以干;但是让它去做一些动作判断——它是干不了的。
第三,很多人认为这东西零幻觉,这也是不对的。它在很多时候会告诉你,这个事我拿不准,有可能是真,也有可能是假,但是后边会跟一个数,叫置信度。像我让它做的一些测试,置信度就只有49%,也就是它拿不准。所以千万不要认为这东西零幻觉,而且这个模型最后的判断准确率也就是68%,也不要认为它就是对的,千万不要抱有这种幻想。
TypeSafe AI、Jev与“快思考”
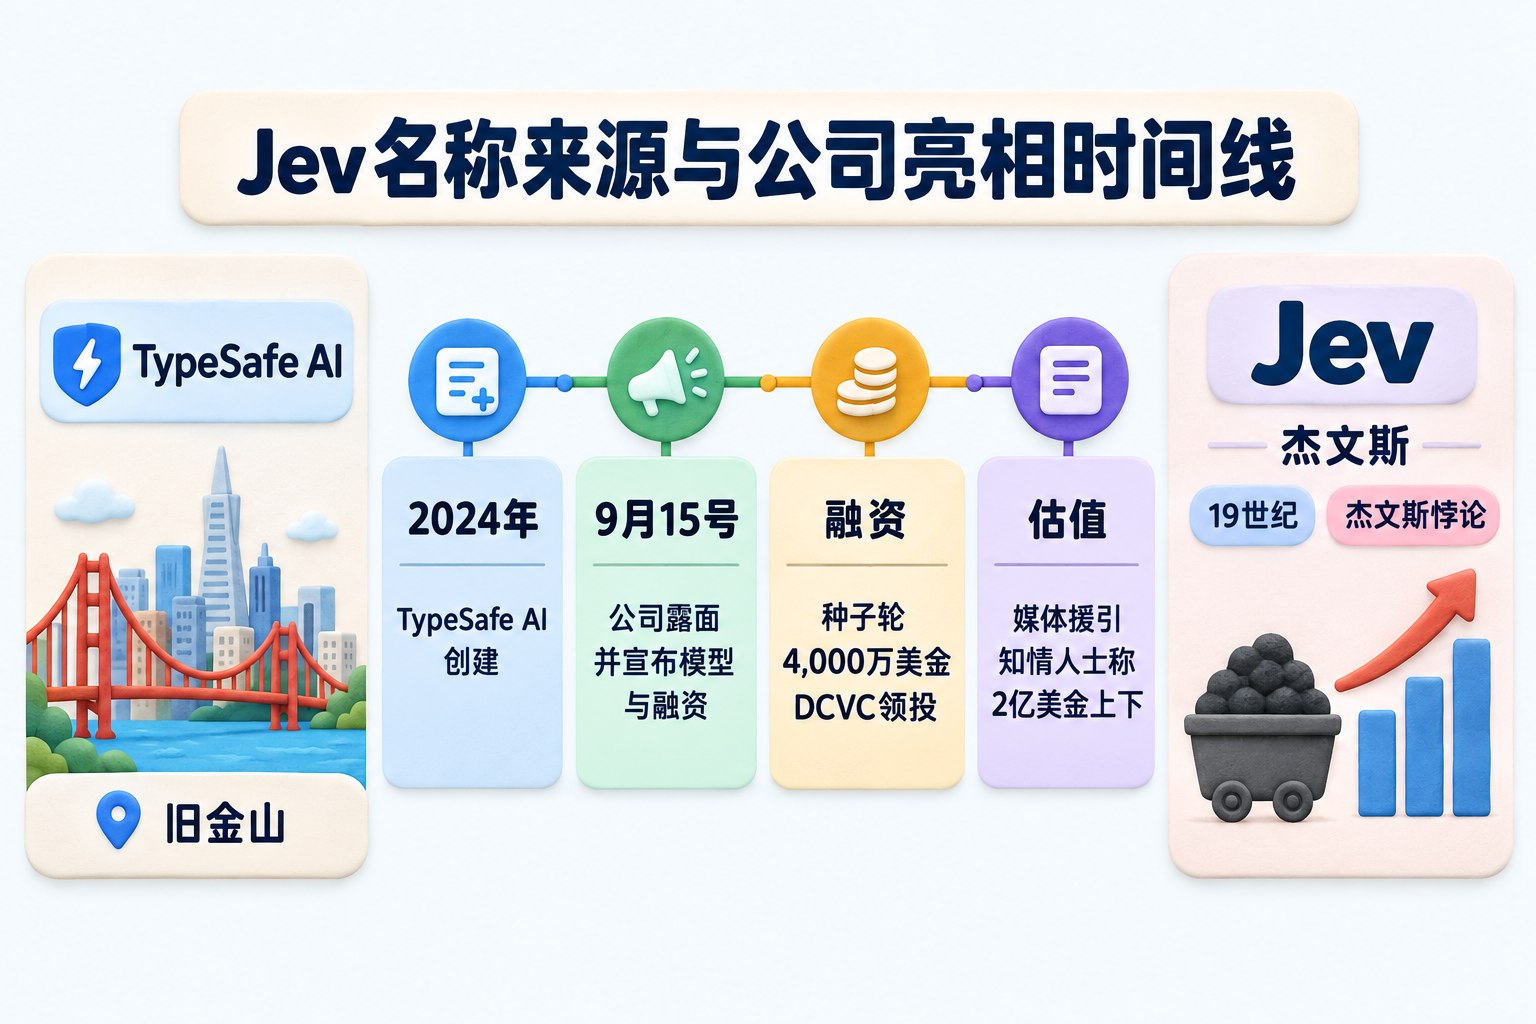
先把它不能干什么说明白,然后介绍一下这家公司。公司叫TypeSafe AI,在旧金山,2024年创建,闷头做了两年,到9月15号才露面。露面时宣布了两件事:第一,我的模型出来了,到底能干什么;第二,拿了种子轮融资,4,000万美金,由DCVC领投。媒体援引知情人士说,估值是2亿美金上下。
大家注意,它并没有真正披露这4,000万美金投进去以后估值是多少。如果4,000万投进去,估值是2亿美金,那就是占20%。这个有一定的代表意义,说明这家公司的议价权并没有那么强。有时候议价权很强的公司,基金的占股比例会非常低。
创始人叫阿尔梅达,原来是OpenAI后训练团队的。大家注意,他是后训练团队,不是预训练团队,这个后边还会讲。他是InstructGPT那篇论文的共同作者,ChatGPT背后那套人类反馈强化学习就是他们发明出来的。他现在的说法非常有意思:人类反馈强化学习优化的是人类的偏好,而不是任务的正确性;这个行业做出来的是更便宜的软件,而不是更聪明的软件。
说白了,就是模型被训练成听起来对,而不是真的对。他给自己参与发明的那套强化学习起了一个名字,叫“一条奇怪的岔路”。这对于后边判断这个模型到底能干什么非常重要。公司名字TypeSafe,意思是“类型安全”。程序员很容易理解,非程序员则需要稍微解释一句。
所谓类型安全,就是我们规定一个变量只能存整数,你就不能往里存小数,也不能存字符串。只要规定好了,它就是写死的,往里存其他东西就会报错。这就是一种编程特性。它声明好了,这里只有四个答案,绝对不是三个,也绝对不是五个,就是四个答案。
模型名字叫Jev,J-E-V,其实是杰文斯的缩写。杰文斯是19世纪英国的经济学家,他发现了一个很反直觉的事情:蒸汽机烧煤的效率提高了,煤的消耗不降反升,因为便宜了,用的地方就多了。这叫杰文斯悖论。最后讲Jev模型对整个行业的影响时,我们还会用到。官方博客的原文是:智能的成本每降一个数量级,用得上的场景就会多出几个数量级来。这家公司把赌注直接写进名字里了。
第三个有趣的地方叫“快思考、慢思考”,引自卡尼曼的《快思考,慢思考》。现在的大语言模型一般都是System 2,也就是系统二的慢思考,为的是得到更准确的结果。比如一步一步进行推理,对推理进行循环,把各种推理分叉,得到一堆结果以后再归并起来。这属于很典型的深思熟虑过程:把各种可能的结果都摆明白,看看是不是能得到一个最好的结果,这叫系统二。
而Jev属于System 1,也就是系统一:一次前向计算,所有候选一起算完,不吐字。这就像人有时候会做的直觉判断。我看到你就觉得讨厌,后边我就不停地找各种理由,越看你越讨厌。我们经常讲的“疑邻人为贼”,我看着他就贼眉鼠眼的,觉得他像小偷,后边就找各种各样的理由证明他是小偷。一开始的第一眼就是系统一,所以这个公司管他们的模型叫系统一模型,也就是这种快思考模型。
它只做三种题,收费也反着来
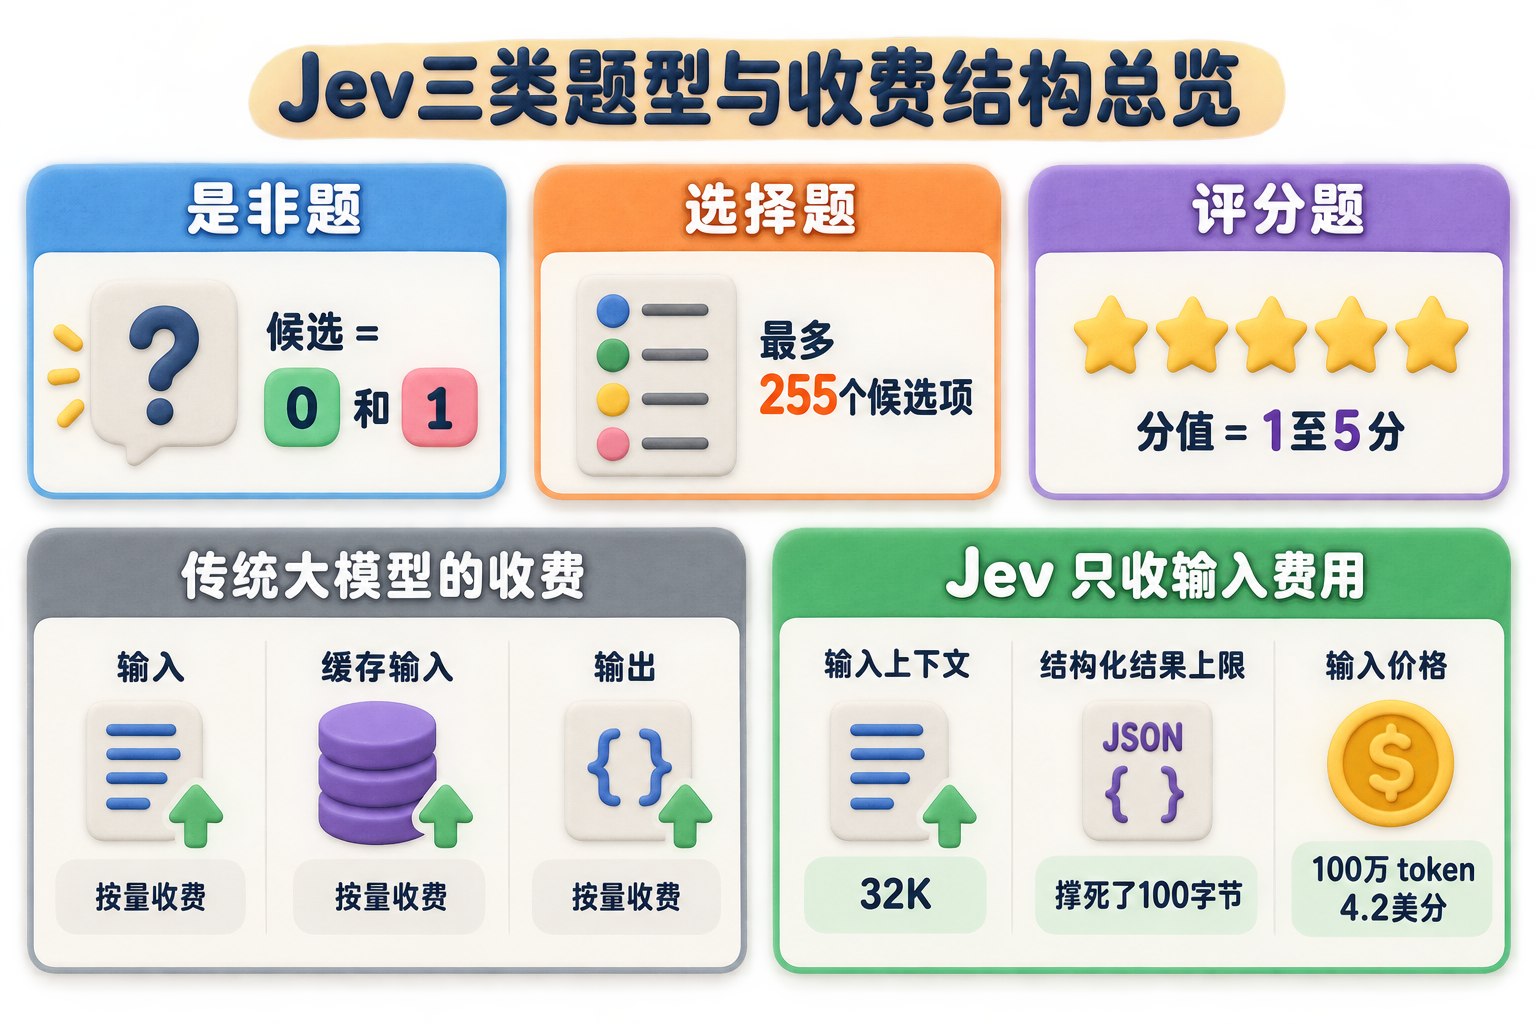
现在的Jev只能做三种题。第一种题叫是非题,你问它一句真的假的,它返回0和1的概率:是0的概率是多少,是1的概率是多少。第二种叫选择题,最多给它255个候选项,它从里头挑一个出来,然后给每个选项做一个概率,排一个序。第一次选项的概率是多少,第二个选项的概率是多少,这一次最高概率的是哪一个,你挑它就可以了。
第三种是评分题,给它一个量表,让它直接打分。比如给它100个数,让它去打1至5分,打完以后告诉你这个置信度是多少。它现在就能做这三种题,除了这三样,什么都不会。它不会写文章,不会写代码,也不解释为什么,所有图片、声音、视频一律都不行。
收费特别有意思,这个东西是反过来的。正常大模型都是三个收费价格:第一个叫输入价格,第二个叫有缓存输入价格,第三个是输出价格。通常第一个价格比如是一块钱,第二个价格可能是两毛钱,第三个价格可能是10块钱。一般就是输出最贵,其次是输入,最便宜的是缓存输入。
而Jev的收费只有输入价格,没有输出价格,也没有缓存的事。它的输入上下文就是32K,也没有什么100万token上下文这种事,没必要。为什么它输出反而不要钱?因为它输出就这么点东西,可能只有几十字节,或者撑死了100字节的一个JSON结构化结果,告诉你是0还是1、几率是什么样的,就完了,没有更多输出。它只算输入的钱,100万token是4.2美分,非常便宜。
真正该替换的,是昂贵的校验工序
为什么这样的模型有价值?这个需要跟大家讲清楚。现在让大模型干活,不是说生成一个报告就完了,而是这个报告必须使用真实的数据,必须引用可信信源的数据;哪些必须引用论文,哪些必须引用新闻媒体,不可信信源一定要标注出来,这才是报告真正的写法。
传统的大模型怎么干活?先生成一遍,后边不是还有一大堆要求吗?再让这个大模型一遍一遍去核实这些要求。在这个过程中,再调用搜索、网页提取等工具,做完以后再核实,而且所有这些动作都是用最贵的模型做的。因为前面生成内容的模型一定是最贵的,你说我写报告,这就是我交的作业,有贵的就不使,对的。所以整套系统都是用最贵的模型跑完。
我自己用一些技能做了这种拆解,校验用的token通常是整个token消耗量的一半左右,也就是50%。这就费劲了。你想,我用gpt5.6 Sol或者GPT-6 Astra做一个很复杂的技能流程,有一半的token都是去做校验,这没必要。所以干脆把这一部分省出来,所有需要做校验的部分都扔给Jev,你就不要自己去做校验了,成本一下就降低了。
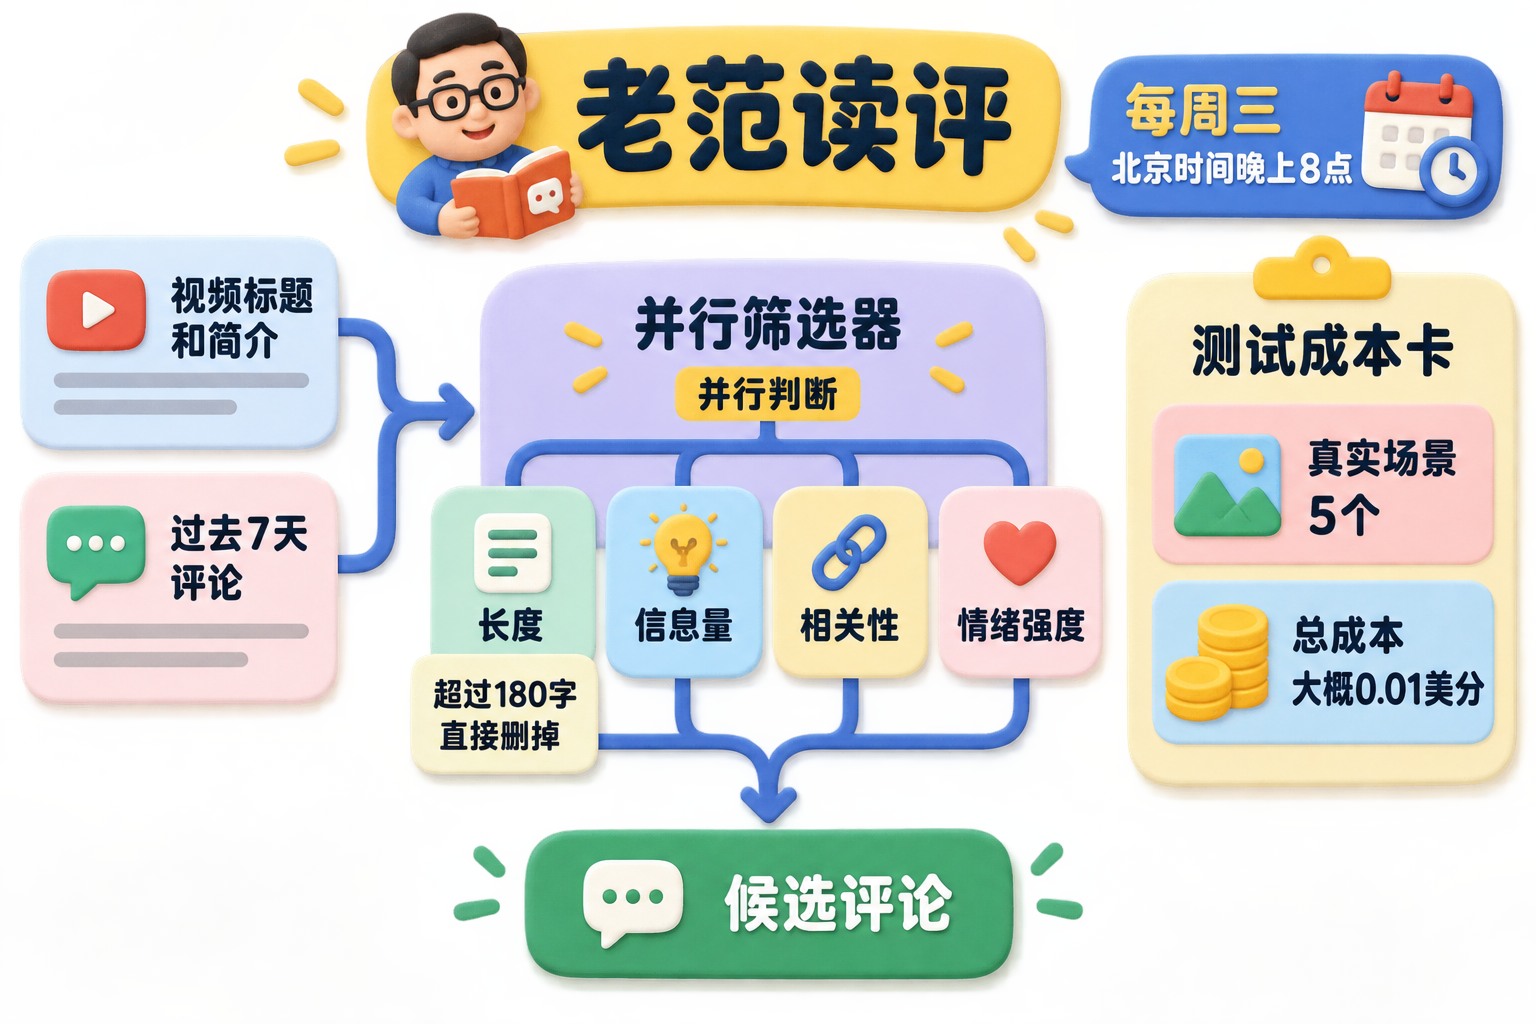
它现在的成本是GPT-5.6的二百分之一,效率比GPT-5.6大概快400倍左右。我举一个实例,我每周三要做“老范读评”。每周三北京时间晚上8点,我会把这一周的评论都拎出来,找其中有趣的跟大家聊一聊。像“老范你真棒”和“老范你真傻”这样的就删掉了。我最早是人工判断,要把一周的所有评论都看一遍,现在就改成让GPT去看。
我会要求它:太长的,超过180字直接删掉;太短的也删了;中间找一些情绪比较强烈、信息量比较大、跟我这个内容相关的发给我。GPT干的活是打开浏览器,先按时间排序,把过去7天所有评论都翻出来,然后一条一条地做判断。用GPT-5.6 Sol去做判断,这事是很痛苦、很贵的。
以后我就可以把这个事情交给Jev模型去干了。先把这个视频的标题和视频的简介拎出来,再把一个一个的评论拎出来,扔进去让它做判断:这个是不是太长,是不是太短,是不是有有效的信息补充,说的事跟我们现在讲的这个视频是不是相关,里头是不是有很强烈的正面或者负面的情绪。
而且注意,这个判断是可以并行做的。它可以一次性把所有的问题都提好,并行地把结果都吐出来,效率非常高。我自己也做了一个测试,拿5个真实场景跑了一轮,全部跑完以后,一共花了大概0.01美分,非常便宜,基本上可以忽略不计。就算每天调几千次,一个月大概也花不了几美金。
从Vercel接入,再把输入喂对
下一件事,大家把它用起来。怎么用呢?第一条最老实的路径,就是去官方排队。它现在在TypeSafe.ai上有waitlist,排队等个一两天就能批,这一块是可以用上的,但是没必要。现在我使用的是第二条路,叫Vercel。
Vercel是一个轻量化的云服务网站,上面有各种各样的AI模型调用服务,直接在上面绑卡、拿key就可以调用了,国内的Visa、Master卡都支持。因为实在非常便宜,所以不用太担心绑上以后钱哗啦哗啦就花掉了。我前面在OpenRouter上绑的卡,那个花钱确实很吓人,最后只能把它解掉了,实在受不了。
其他的,赛博菩萨Cloudflare上也有,但是你需要订阅一个5美金的Workers套餐,否则不让你用。现在最便宜、马上就能用上的,就是Vercel这个网站。很多人说:“你说了半天这么热闹,我使不了,我不是程序员,这API不会调,怎么办?”
这非常简单,直接找Codex、Claude Code,或者你自己用的豆包这些工具,然后直接跟它说:“我要在Vercel上使用Jev这个模型,我的key是什么,把它给我封装好。”完事了,它就直接给你做好了。下一次再去做技能的时候,你就直接跟它说:“你现在给我设计一个技能,其中所有判断的部分扔给Jev去做。”搞定。你不需要写任何程序,就可以在复杂技能中把所有判断都外包给Jev,这完全没有问题。
但是这一步有一个动作非常重要,不能省掉,就是质量评估。你让它修改技能的时候,一定要让它做质量评估,看看修改以后得到的结果质量是不是下降了。如果质量下降了,咱们再看看如何调整。怎么调整呢?就是调整输入信息。因为你直接问它:“这个硬币扔出去,应该是正面还是反面?”它能判断得准吗?肯定判断不准。你要找到充分的信息输入进去,它才可以进行比较好的判断。
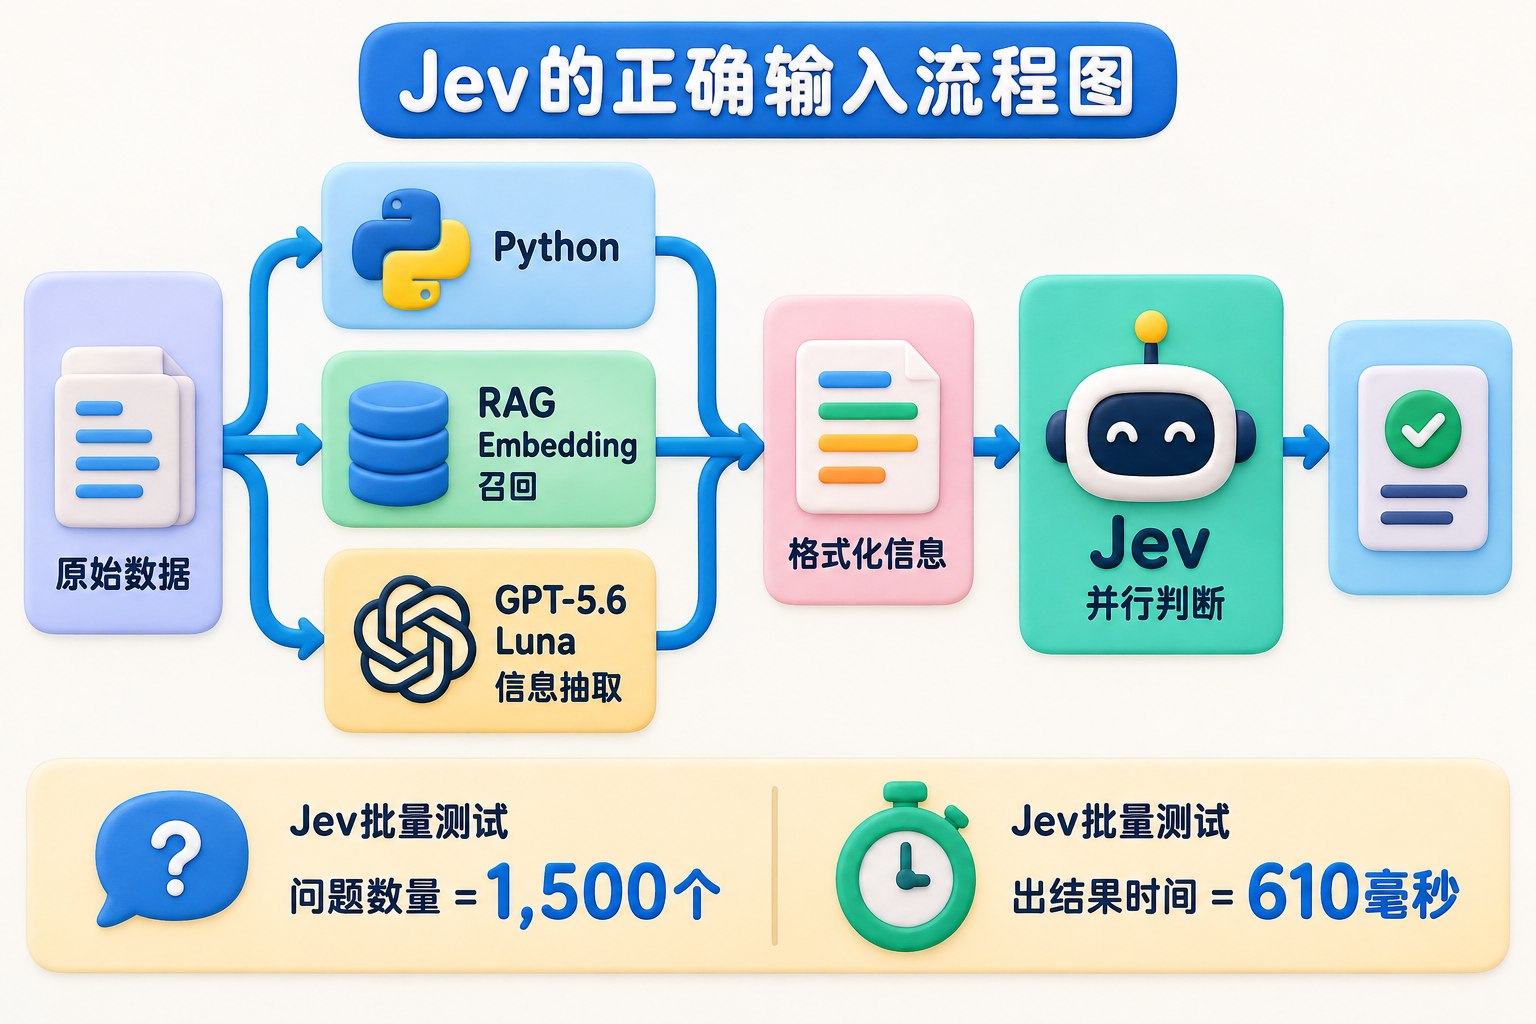
怎么把信息喂进去呢?最好的方法就是上程序,写一个Python代码。当然,这代码也不需要你写,让AI去写。你可以说:“请帮我对这个数据进行抽取,抽取以后做Jev的判定。”或者做RAG,通过Embedding模型做矢量空间的召回。
拿到这样的东西以后,再扔给Jev模型,让它去判定。把数据整理好、格式化好再给它,不是说越多越好,把不相干的内容放进去以后,准确率会下降。如果实在搞不定这些编程的东西,也没有RAG的本地知识库,怎么办呢?还有一个很简单的方法。
就是找最便宜的模型,比如GPT-5.6 Luna这样的模型,把这么多的数据扔进去,让它做信息抽取,按照一个什么样的格式抽好,然后把抽完的结果扔给Jev模型做判断,这也是可以的。而且记住,一次问一堆问题进去。
千万不要这次问“真的假的”,下次再问“给我打个分”,不要干这个活。一次把一堆问题全问进去,就是输入一堆的问题,效率非常高。有人做过测试,一次塞了1,500个问题进去,610毫秒也出结果了。
游戏、无人机与语义防火墙
所以外头已经玩疯了,游戏是重灾区。有人拿这东西去打超级马里奥,问这个界面怎么样。当然,读界面这一块是由其他模型来搞定的,Jev只负责判断往前走到底会不会有坑,现在跳一下能不能过去。还有人拿它去打Doom,以及俄罗斯方块、吃豆人、五子棋,都有人测试,非常好玩。
当然,也有人拿它去接无人机。刚才不是讲过,接机器人、接无人车是有问题的吗?它是这样的:基本动作还是要让传统的模型、飞控系统去做,但是一些逻辑上的战术判断可以交给Jev。我应该向左飞还是向右飞,应该采取什么样的策略,路径怎么选择,这些扔给Jev,效果也还是不错的。
真正有用的是工具这一类。比如我现在做语义防火墙,挡住Agent什么时候该调工具、什么时候不该调工具。因为如果不拦着它,有的时候Agent自己就找工具调用去了,会浪费很多token。让它先判断一遍,我到底应该向左边走还是向右边走,应该调哪个模型。
是应该调浏览器,还是应该调搜索,还是应该调页面提取,这些东西让Jev去判断,效果非常好。他们测试了,可以实现94%的错误工具调用拦截,这就可以省太多token了。还有人拿它去扫GitHub上的提交,自动分出来哪些是修bug,哪些是补安全漏洞,效果也很好。
我最喜欢的一个案例叫“人类编译器”,大家听听是不是很有意思。就是把公司里那些阴阳怪气的邮件当代码编译一遍,然后出一个报告,说哪句话是假装紧急,哪句话是在骂人。编译一次以后扔给老板看一看,以后这种性格耿直的老板就可以看出来:“原来你在阴阳我。”
这个以前可能很多人看不出来,让人阴阳了以后还自己暗自开心,以后就不会有了。当然,如果公司做了这种人类行为或者语言编译器以后,会不会造成一些其他的损害,咱就不负责任了,只作为趣事跟大家分享。
把这些加起来,就说明一个结果:判断这道工序一旦便宜到可以忽略不计,人就会开始往一切地方塞这个判断,杰文斯悖论就会实现。当这东西便宜以后,人们就会疯狂使用。
行业冲击:先承压,再腾飞
Jev会怎么改变AI行业?首先说Jev是不是可替代,它的门槛到底高不高。这件事判断不了,因为它什么都没公开:不开源,没发论文,权重不开放,参数量和架构没说,怎么训练的、用了多少数据、用了多少卡,也都没说。
它只是说,所有数据都是生成数据,是用这些生成数据训练的。创始人阿尔梅达的说法是,论文暂时先捂着。既然是这样,估计它的门槛应该不是特别高。它准备先申请专利,申请完专利以后再发论文,但是这层窗户纸应该并不厚。
有个叫休姆的人做了一整套探针测试,从外面推断Jev应该是一个稀疏专家混合模型,活跃参数大概是10B左右。最关键的一句是,Hacker News上有人留言说:“这东西说白了,不就是一个零样本分类器吗?”阿尔梅达的原话是:“完全正确,就是一个零样本分类器。”
所以,想得到这样的东西并不复杂。找一个几B,或者最多10B的MoE小模型,做微调不就完了吗?只干这一件事,效率可能比Jev稍微差一点,但是也差不了太多。Jev一方面是判断便宜,另一方面在效率和并行上应该还是下了一些功夫。但是,做这种判断模型本身应该并不难,各大厂现在应该都在路上,很快就会推出类似产品。
这东西一旦铺开,token消耗,特别是验证部分的token消耗,就会急剧下降。现在很多模型大家已经不敢用了,像GPT-6、Fable 5.1都不敢用。原因很简单:太多回路需要验证,太多循环在里面转圈,做一个很简单的事情,5小时额度就直接烧光了。
以后如果把判断部分外包给Jev这样的模型,把信息抽取扔给5.6 Luna这样的小模型,各行各业里的使用量一定会翻番地涨上去。所以对股票来说,可能会先承压、再腾飞。token使用量下降,对英伟达、美光、SK海力士这些股票来说会有压力,原来大家设计的这么多算力,可能用不掉了。
但是,就跟前面的杰文斯悖论一样,因为便宜了,应用场景就会大量爆发,未来一定还是会腾飞上去。至于TypeSafe AI这家公司,赶快把它卖了吧。因为这种单独做一件事情的公司,最后的商业变现会很痛苦。这样一个只有小聪明的产品,指望它做大做强,最后跟OpenAI、Anthropic竞争,想太多了。
趁着现在这个时间点正热,找个大团队把它卖掉。OpenAI、谷歌这些大公司赶快把它收进去,大家皆大欢喜就可以了。最后,我们要说一下,Jev这个模型可能会很危险。
最大的危险:把第一印象变成自动裁决
TypeSafe自己的公告也总结了Jev的准确率:67.8%,其实还不到68%。重点不在这里。同一套题,其他模型的分数是:GPT-5.6 Luna为66.8%,Terra为67.9%,比Jev还要稍微高一些;Sonnet 5为67.8%,跟Jev一样;Opus 5为73.1%;GPT-5.6 Sol为74.1%,是最高的一个。
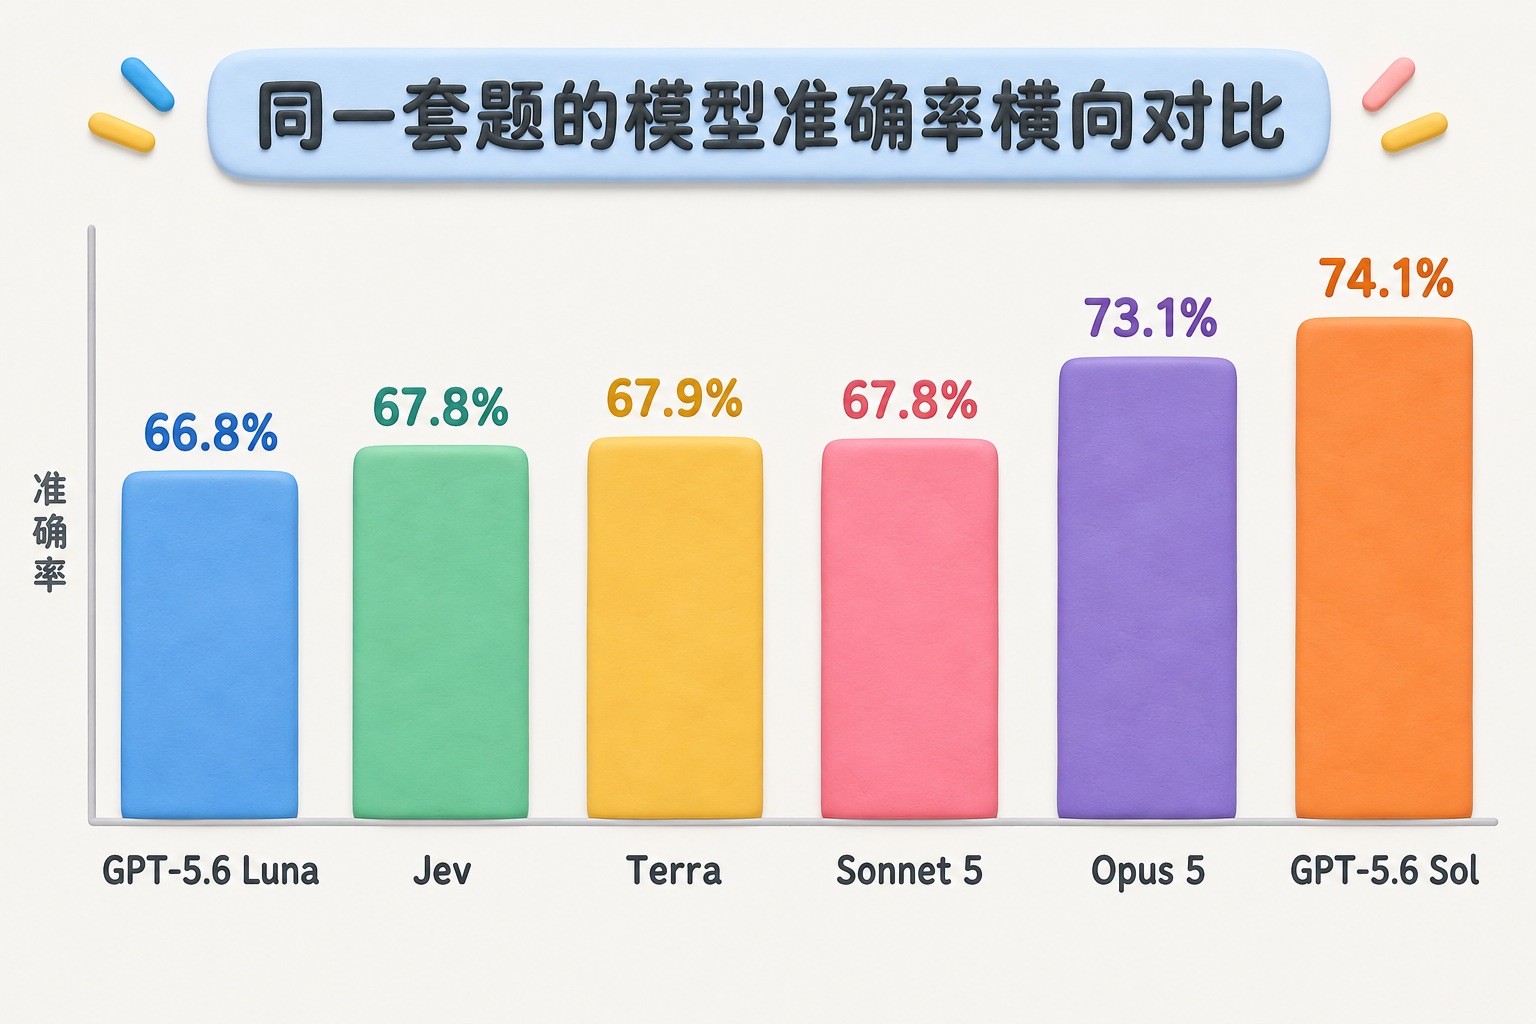
所以,Jev的准确率在这里面叫中规中矩,它真正强的地方是快和便宜。如果花了几百倍的钱,只得到一个比它高一点点的正确率,那就没必要了,还是用Jev吧。这样的情况下,为什么说它很危险?因为任何事情都让它做判断,而且很多人看判断时只看一个结果。
很多人并不看置信度。这样一来,很多冤假错案、很多固有印象,或者说得好听一点叫第一印象,就会参与判断,而且会让各种结果产生很大偏差,这才是真正危险的地方。
比如,我看着你不像好人,贷款就不给你审批了。假设做了这样的判定,它也不解释为什么。虽然里面有置信度,但是很多软件或者技能在制作时,可能压根就没读取置信度,于是就会出现这样的结果。
很多我们称为固有印象或者刻板印象的东西,其实已经被训练进这种模型里了。前面这位创始人也讲得很清楚:我们训练它,不是训练它做出正确的结果,而是训练它符合人的第一印象。以后这些刻板印象就会进入大模型,而且因为它太便宜、太快,以后大模型整体做出来的答案会更加符合我们的刻板印象。
还有一个很危险的地方是SEO。SEO就是针对搜索引擎进行优化,让我们的内容排得比较靠前。既然Jev这样的东西已经公开出来了,我们现在想做一些GEO,也就是生成式优化,就可以针对Jev这种判定模型做专项优化。
怎么能够让自己发出的新闻看起来更像是真的?大家注意,我说的不是“更加真实”,而是“看起来更像真的”,从而在Jev里面打分时得分更高。道高一尺,魔高一丈。只要有判别标准,就一定会有人做专项优化,这都是非常危险的。
说到底,这叫官僚主义。以前是有人看了你一眼,说“你这人不像好人”;以后可能连看你一眼的人都不见了。AI把你的简历、你提交的各种资料咵地一刷,直接刷掉了,为什么都不告诉你。
最后总结一下。Jev这个模型还是挺好玩的,该用就用,成本低到可以忽略不计。但是大家一定要注意,你请回来的并不是一个明白人,只是一个符合人类基本认知,或者说符合人类刻板印象,能够做题做到68分的判定器。不要盲目相信它,这就是我对大家提的最后要求。
今天这个故事就讲到这里。感谢大家收听,请帮忙点赞、点小铃铛、参加Discord讨论群,也欢迎有兴趣、有能力的朋友加入我们的付费频道。
再见。
背景图片