穆斯林议员赛义德刚当选。他竞选时放话,前沿AI应该全面暂停,还说中国是快艇后面的滑水者。这话到底是暴论还是实话?
大家好,欢迎收听老范讲故事的YouTube频道。
11月3号,美国中期选举,民主党大胜,参众两院都拿下来了。密歇根州42岁的医生赛义德赢了共和党的前众议员罗杰斯,成了美国历史上第一位穆斯林联邦参议员。
投票前两天,11月1号,美国时间星期天晚上,CBS的《60分钟》播了两位候选人的专访。赛义德说,他现在每天从选民嘴里听到最多的就是AI。说到那种可能威胁人类的前沿AI研究,主持人追问了一句:“全面暂停吗?”赛义德照原话回了一句:“应该全面暂停。”那美国停了,中国不停怎么办?在节目放出的加长版访谈里,他说自己不怎么担心,因为中国很多前沿研究是在模仿美国的模型,就好比一条快艇拖着一个滑水的人。
这个比方,他10月21号在底特律经济俱乐部候选人论坛上讲得更直白:“中国能长起来,说白了,靠的是模仿我们的模型。这就像一条船拖着一个滑水的人。我们越开越快,回头一看,他还在后头。我们就说,他还跟着呢,再快点。可人家是在模仿我们的模型。”主持人反问,滑水的人不能自己追上来吗?他也承认,对方可以跳上一辆水上摩托追上来,所以得跟中国签国际条约。
这个比方一出来,常听到两种说法,说这些话的还不光是普通人。一种是,中国人就是抄,就是蒸馏。说这话分量最重的是Anthropic的CEO达里奥·阿莫代。他在播客里说,很多模型,特别是从中国来的,是冲着跑分优化的,是从美国大实验室蒸馏出来的。可要说抄,美国自己人也在抄。今年4月30号,马斯克在加州联邦法院作证,被问到xAI有没有蒸馏过OpenAI的模型。他说部分是,还补充说这是业内的普遍做法。蒸馏不是中国特产。
另一种说法是,这是扯淡,中国有自己的创新,美国一停,中国马上就超车。这话黄仁勋说得最响。去年11月,他跟《金融时报》说,中国会赢下这场AI竞赛。可他这话还有后半句,全世界一半的AI研究员是中国人,美国得让英伟达留在中国,才能把这批开发者争取过来。喊中国要赢,是为了回中国卖卡。两拨人吵的都是中国行不行,可这大半年,美国大厂到底干了什么?没几个人去看。
那这个比方到底对不对?赛义德的快艇比喻说对了一半。中国确实被拖慢了,但照样追得上。他们上台唯一能拖慢的,只有美国自己。这件事里有四层反转。第一层,一个比喻就能换来一张参议院的门票。第二层,这个外行打的比方偏偏还说对了一半。第三层,说中了,却拦不住我们。第四层,再往后走,被逼着去抄作业的可能就会换成美国人了。
封锁就像一屋子开心果,吃是吃不完的,只是越往后找下一颗越费劲。说白了,卡得住一时,卡不住一世。底气来自两样东西,美国大厂自己公布的数据,和一笔中美标注行业的账。四层反转一层一层来剥。先说比喻怎么换来门票,再看美国怎么把蒸馏堵上,然后说那一屋子开心果,中国怎么接着找,最后看开放思维链会不会反过来成为标准。剥完了,再说这帮议员上台到底能干成什么。
快艇比喻怎么换来选票
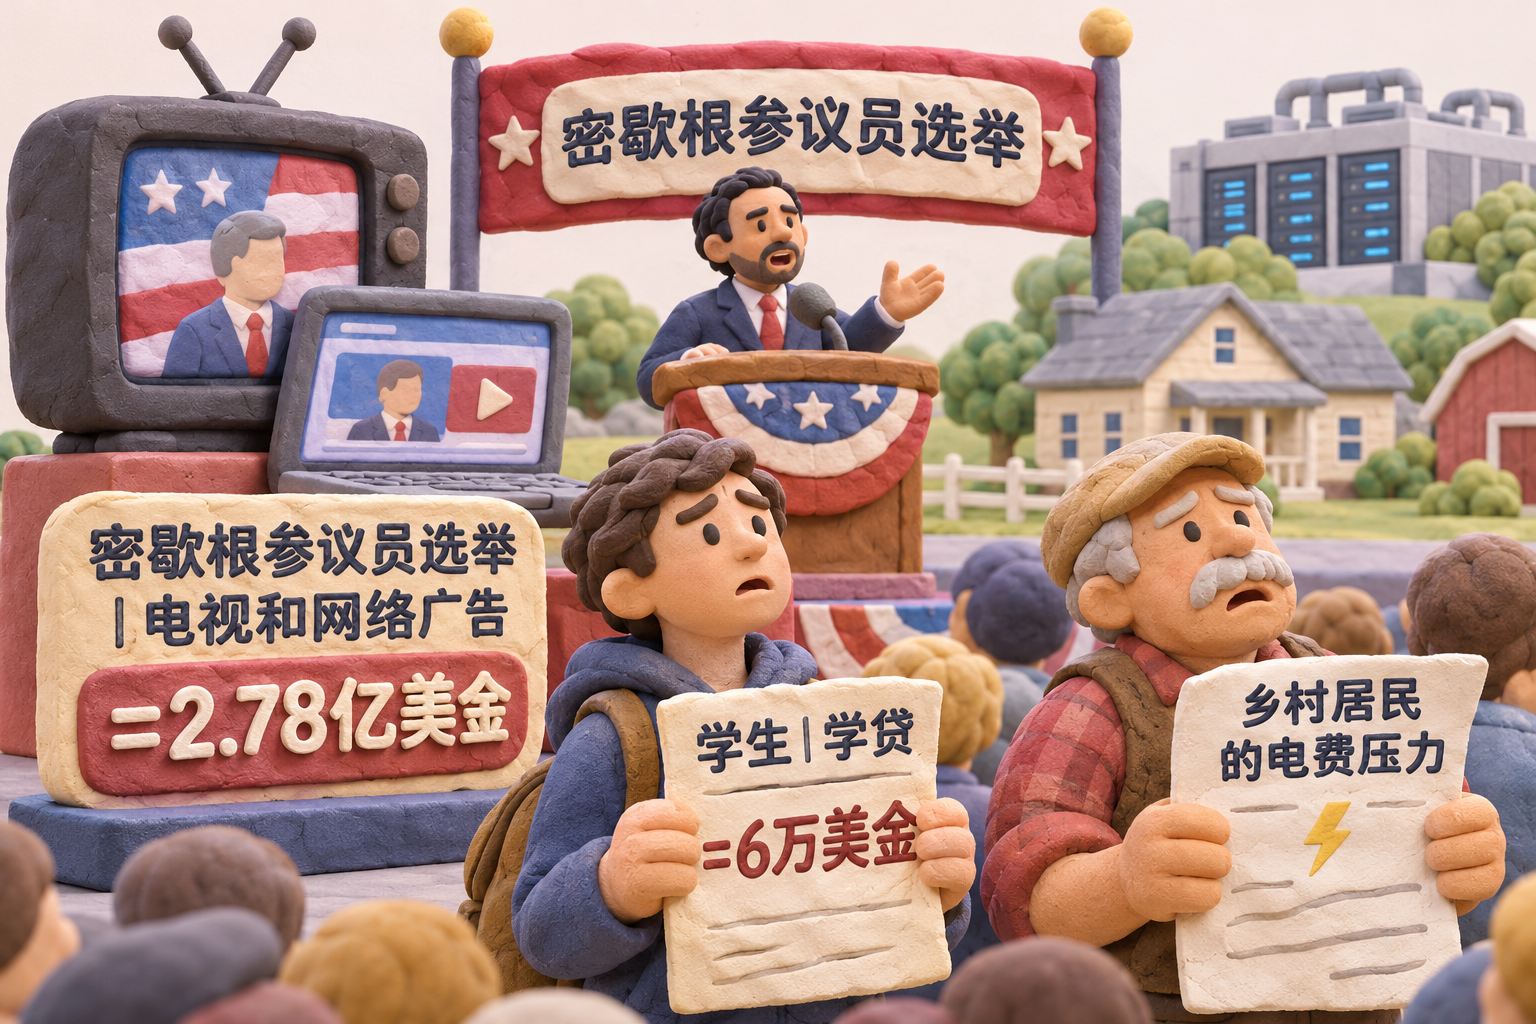
一个比喻凭什么就能换来参议院的一个席位?先看选民在怕什么。赛义德在《60分钟》里说,跟他讲AI的选民有两种。一种是学生,刚背了6万美金的学贷,毕业以后要干的那份工作已经没了,或者10年以后就没了。另一种是乡下人,数据中心要盖在自家后院,电费本来就交不起,还要担心水。饭碗和电费都是切身利益。
再看对手罗杰斯。他当过众议院情报委员会主席,讲的是不能让中国、俄罗斯占了先。这是华盛顿的老调子,跟中国比赛就是盖机房、拉电,往前冲。赛义德的快艇正好把这个调子翻了个面。不是我们跑得不够快,而是我们跑得越快,越是拖着中国跑得快。这么一来,停下来就既安全又爱国了。选民不用懂什么叫蒸馏,也不用懂什么叫思维链,快艇滑水一听就明白了。
这场选举光电视和网络广告就砸了2.78亿美金,是密歇根有史以来最贵的参议员选举。最后赛义德赢了。广告砸得再多,也不如一个比喻好记。一个形象的比喻是能够换来选票的,这一点赛义德已经证明了。
美国怎么堵住蒸馏
比喻好记,不等于比喻说得就对。那他说中国靠模仿,仿的到底是什么?蒸馏本来是个很正经的技术,就是拿大模型当老师,小模型照着老师的回答学。一家公司拿自己的大模型教自己的小模型,天经地义。问题出在拿别人家的模型当老师,注册一大堆账号,把问题设计好,一批一批地问,把回答收回来,拿去训练自己的模型。
今年2月23号,Anthropic第一个把这事挑明了,直接点了三家中国公司的名字,DeepSeek、月之暗面和MiniMax。它说,这三家用了大概2.4万个假账号,跟Claude来回做了1,600多万次问答。三家里头,MiniMax问得最多,1,300多万次,月之暗面340多万次,DeepSeek最少,15万多次。这是成箱地往回搬。
美国人是怎么堵住的?一共4招,喊人、立规矩、藏过程、罚钱封号。第一招是喊人。公司点完名,政府接着喊。4月,白宫发备忘录,说外国主要是中国在搞工业规模的蒸馏。9月8号,美国国安局、网络安全局、联邦调查局联合通报,一口气点了6家中国公司。生意上的事情变成了国事。第二招叫立规矩。谷歌Gemini的API条款里写着,不许用它来开发跟它竞争的模型。OpenAI、Anthropic也都有类似的条款。
第三招叫藏过程,这一招最狠。OpenAI把推理过程藏起来了,只给你一个摘要。到了GPT5这一代,推理的时候不许你调温度,也不给每个字的概率。也就是说,模型每吐一个字,心里有几成把握,这些数都不告诉你了。推理内容还加了密,只能原样传回去,人看不懂。谷歌去年5月也把Gemini的原始思考过程换成了摘要。Anthropic同样也只给摘要,8月31日以后新开的API账号,连前面的对话都不许你手动改了。
第四招是罚钱封号。一发现成批账号在扒数据,常常两个小时之内就能封掉,前后封了几万个。从今年9月24号开始,Anthropic连被安全防护拦下来的请求也照样收钱,问不出东西,钱照样扣。效果怎么样?10月12号,Anthropic自己公告,蒸馏的人能扒走的数据少了90%到99%,能扒走的推理内容掉了10倍到100多倍。门基本上已经关上了。以前咱们常讲蒸馏,以后这种蒸馏已经不太存在了。
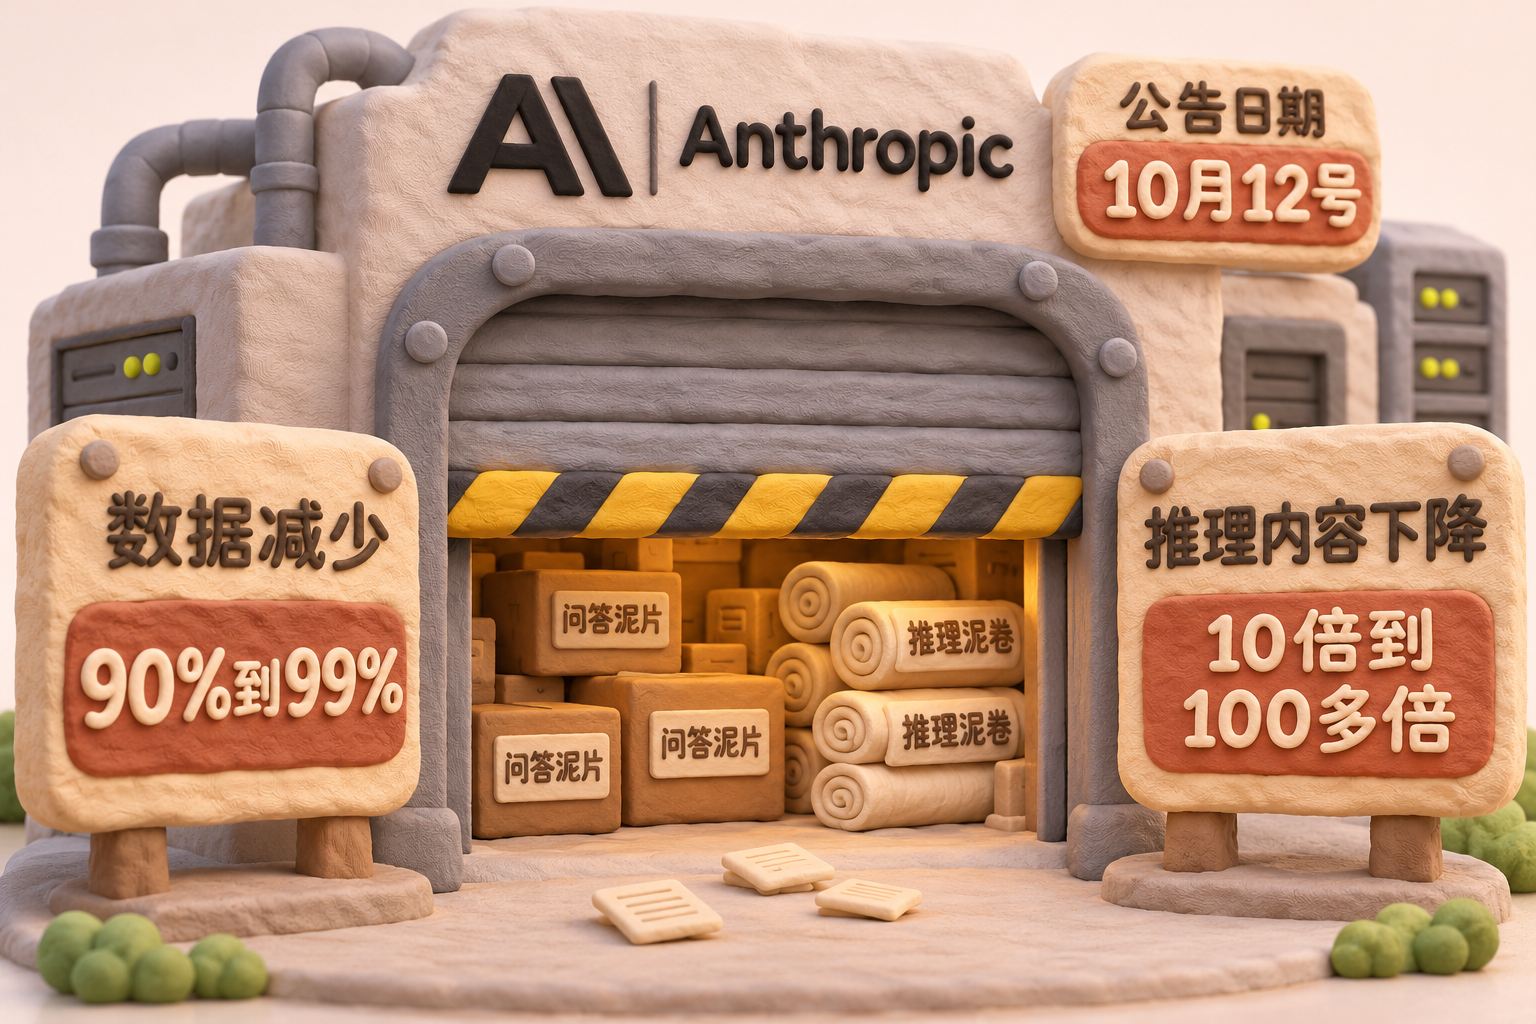
为了关这扇门,Anthropic说它推掉了几万亿TOKEN的付费流量,到手的钱都不要了,护的就是这个护城河。说白了,它怕的不是少挣这笔钱,是怕别人学会以后,它的东西就卖不上价了。
门关上以后,中国模型发生了什么变化?分两头来看。一头是单个问题、单个答案。斯坦福的AI指数报告说,到今年3月,美国最好的模型只比中国最好的模型领先2.7%,这块基本上追平了。另一头是长程任务,就是让agent一口气干几十步、几百步的活。这块中国已经落后了,因为前面封住的是推理过程。
没有这部分推理过程拿去蒸馏,长程任务就会做得比较差。这就跟很多外国人看中国人做口算一样。咱们小时候练口算,背九九表,他们没练过,就看你盯着一堆数字看一会儿,然后直接写出答案,只能觉得神乎其技,完全不理解你到底是怎么做出来的。中国大模型去蒸馏美国闭源模型,碰上的就是这个问题。中间过程不给你了,只给你最后结果。特别是推理模型,没有中间过程,你对着结果只能惊为天人,没有什么别的办法。
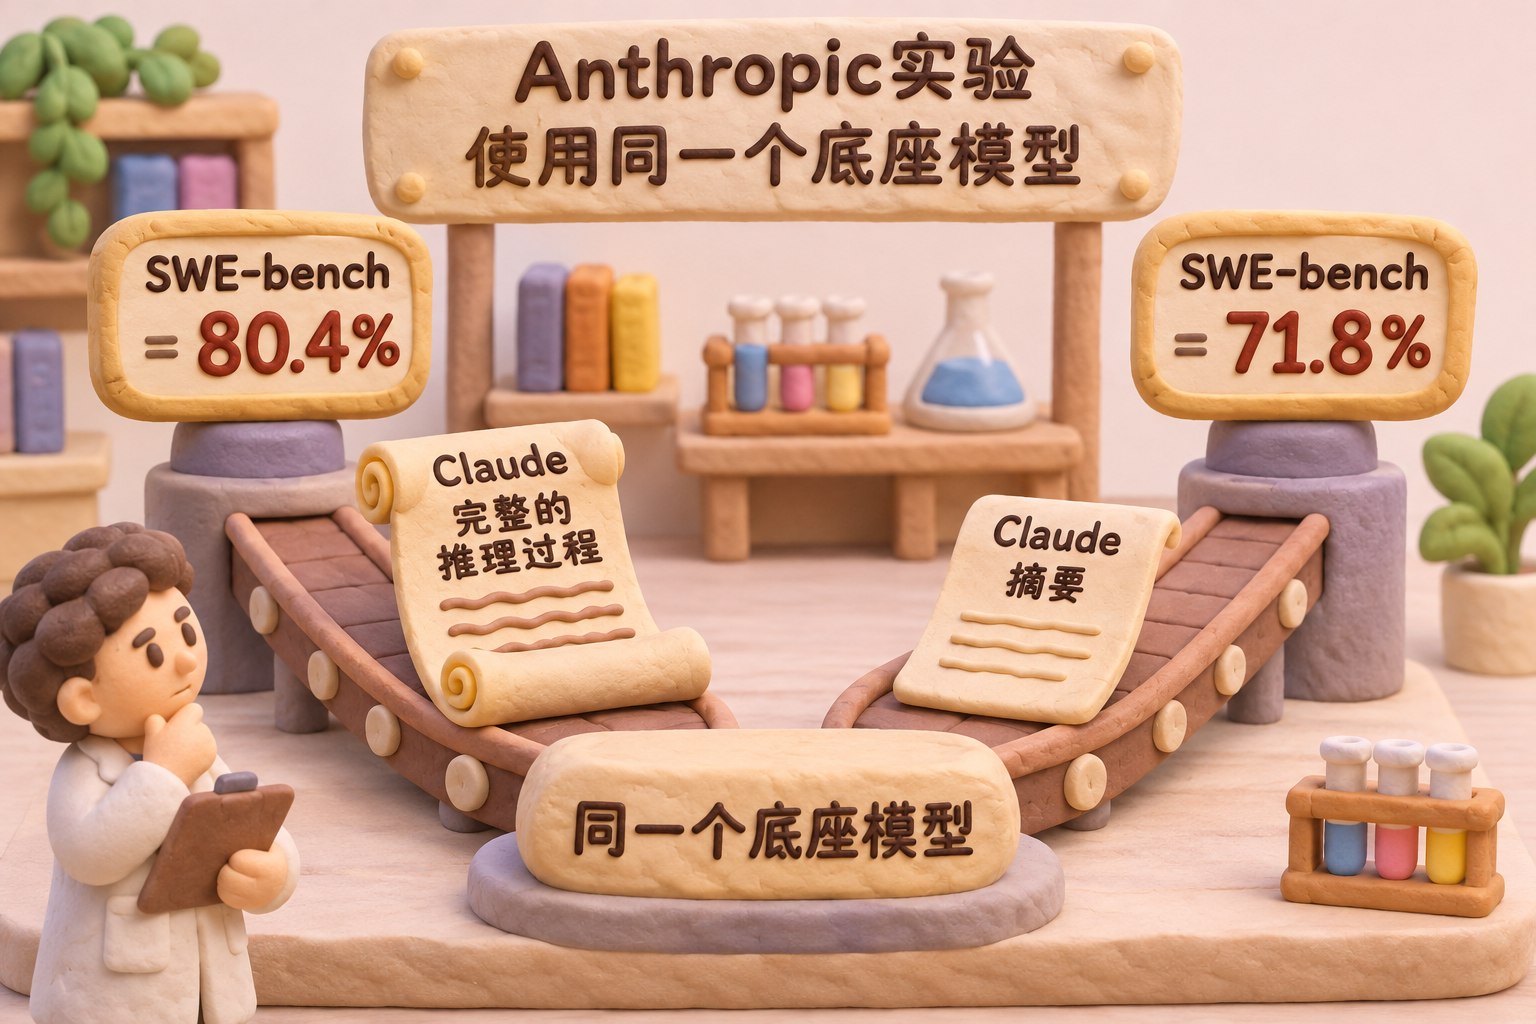
这个过程值多少钱?Anthropic自己做过实验,同一个底座模型,拿Claude完整的推理过程来训练,编程测试SWE-bench能够考到80.4%。只拿摘要来训练,就只能考到71.8%。藏起来的正是最值钱的那一段。为什么长程任务这么要紧?现在让大模型单独回答一个问题,意义其实已经不大了。大家都是先查知识库或者先搜索,再回答。真正比的是做一长串AI agent任务时会不会跑偏。
跟大家讲一个跑偏的故事,真的让我哭笑不得。我前阵子用MiniMax的M3.1Flash做deep research,觉得这类任务太耗TOKEN了,就跟它说,这肯定有问题,给我省着点。它说没问题,我去给你优化一下。吭哧吭哧跑了半天,给了我一个优化好的结果。我让它跑一次试试,发现比原来更耗TOKEN了。
长程任务跑完以后,要检查它中间干了什么,其实很麻烦。有一天我实在受不了了,就让它把整个过程拆开,一步一步解释清楚。以前大家写的是程序,现在等于给模型一大堆提示词,让它按提示词一步一步去干,这就更难检查了。MiniMax给出的解释让我哭笑不得。它的思路是,输入的部分反正90%多都在缓存里,很便宜,不用担心。把输出缩短,不就省TOKEN了吗?
我让它搜索信息、做deep research,它去做了,但输出太长。它就重写一遍,希望把输出压短,写完还是长,又重写一遍。最后反复重写了100多遍,它放弃了,说实在没办法写得更短了。我5小时的额度就这么被吃得干干净净,还搭进去一大堆积分。最要命的是,它自己完全发现不了自己干了这么二的一件事。这就叫长程任务跑偏。
美国把过程收紧以后,中国大模型确实受到了影响。智谱的唐杰今年1月在清华的一个峰会上说过,美国和中国大模型之间的差距说不定并没有缩小,因为美国还有大量闭源模型没有开源。所以静态地看,赛义德说的有一定道理,不是完全胡说八道。美国把门一关,中国确实被拖慢了。外行的比方恰恰说到了要害。
中美高端标注的账
那中国自己标注不行吗?标注得请人给模型出题、写标准答案、给回答打分。模型自己摸不出来的门道,要靠人一条一条地教。这块中美两国的差距真是天差地别。先看总量,全球数据标注市场,美国一家占百分之三十几,有的口径是接近40%。
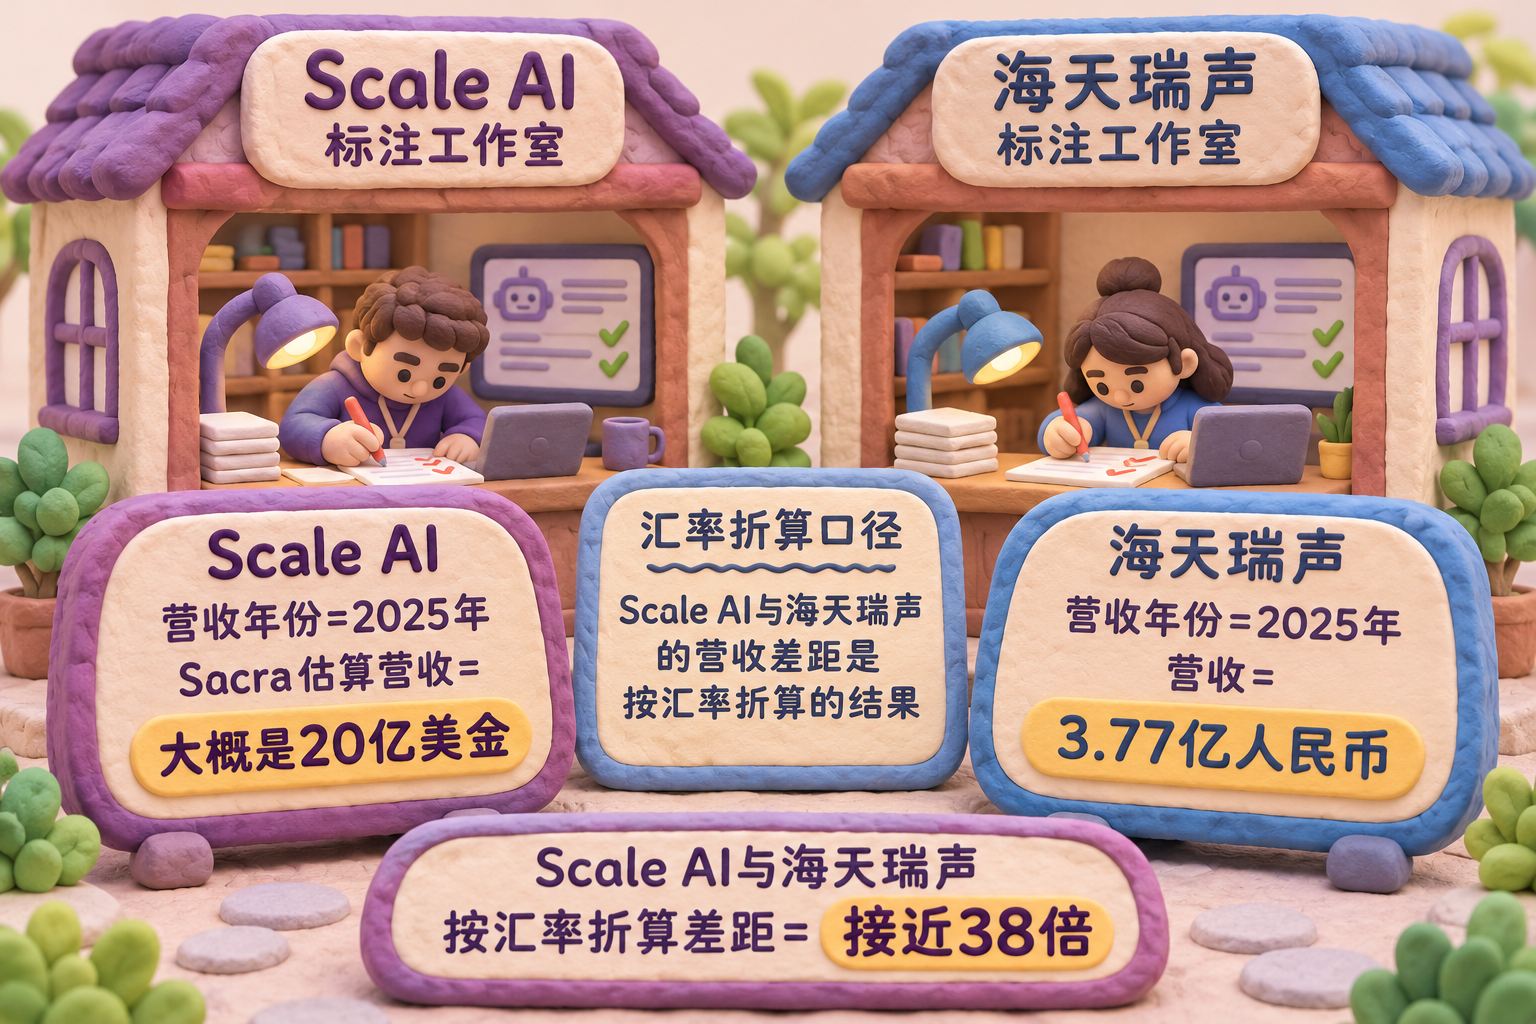
再看头部,美国这行最有名、最大的一家叫Scale AI,创始人叫汪滔,就是后来被扎克伯格拎回去的那个亚历山大汪。按研究机构Sacra的估算,2025年营收大概是20亿美金。中国最大的一家是名字里带“海”的海天瑞声,2025年营收3.77亿人民币。按汇率折算,跟Scale差了接近38倍,差的不是一星半点。而Scale还不是最贵的,真正贵的是那些做专门标注的公司。
专门标高端数据的公司,比如Surge AI,创始人姓陈,是个80后的华人。这家公司前年营收有12亿美金,收费是Scale的2-5倍,单条的成本很高。干活的是医生、工程师、科学家这类专家。这种数据很贵,可没有它,长程任务肯定搞不定。这块中国确实比较差,差老鼻子了。国内冒出来的两家做高端数据的公司,UniPat和Humanlaya,估值都到了10亿美金上下。可是UniPat到今年5月底,订单也就是3,000万美金,两家都刚刚起步。
长程Agent这种数据,市面上倒是有人在卖,而且很贵。卖的东西是从哪来的?至少有一部分是美国公司自己在卖。《福布斯》今年8月做过一个调查,美国的Mercor、Surge AI、afterquery、Turing这几家数据公司,在把现成的训练数据卖给中国的大实验室。中国头部的6家实验室一年在美国数据商身上大概要花5亿美金。Surge AI那位陈老板还亲自飞到中国去见实验室的老板。数据这扇门,美国人自己开着。
追赶的成本与中国手里的四张牌
但我要讲的是,任何封锁都不可能把一个东西彻底封死。讲个一屋子开心果的故事。一个屋子里堆满了开心果,你从上面摸出一颗,撬开吃了,壳还扔在屋子里。一开始肯定很容易,随手一抓,一大把全都是开心果。可吃着吃着,表面那一层就都变成壳了,因为吃完的壳都扔在最上头,找起来就变得费劲。那就往下挖。再吃一段时间,挖都不好挖了,就得筛,在一大堆壳里一颗一颗地挑出开心果。
开心果会被彻底吃干净吗?永远都不会。真正改变的只有一件事,再想找到新的开心果,成本是不是已经高到你不愿意承受了?封锁也是这样的。原来随手就能拿到的东西,现在要往下扒拉,要大量筛选,还得不停地想新办法。成本一路往上走,差距就差在这儿。封锁改变的不是开心果还在不在,而是找到下一颗开心果的边际成本。这应该是一个经济学家讲的小故事,意思就是越往后,同样一颗开心果就越贵。
那中国团队怎么办?方法都在,并不需要中国人自己去创新,需要的是大规模地组织人去标注。这肯定会提高追赶的难度和成本,让大家在追的路上滞后一些。中国手里至少有4张牌,人、用户、聪明的模型和现成的壳子。
第一张牌是人。中国别的不多,人有的是,而且至少接受过初高中教育。教育部说,今年有1,270万高校毕业生,很多压根找不着工作。还有很多35岁以后被“毕业”了的,也都是有经验的人。那就重新把他们组织起来做标注,原来没花的钱,现在花出去,不就完事了吗?
第二张牌是用户。现在中国AI agent的用户量很大。Quest Mobile的数据显示,今年9月,腾讯的WorkBuddy月活是3,235万,在办公agent里排第一。豆包的APP月活是4.19亿。我用的MiniMax code,用户应该很少,我属于小众用户。这些公司手里攒了大量的用户行为数据,拿去学习分析或者重新标注就可以了。用户就是现成的题库。也不要指望中国这帮公司给你做什么隐私保护,现在大家都在只争朝夕,一切代价都不重要了。
第三张牌是聪明的模型。现在的模型已经很聪明了。原来大量靠人标的东西,现在可以用模型直接做数据清洗,做强化学习也能出结果。牛津大学9月底有篇论文,题目就叫《蒸馏防御在强化学习之后很容易被攻破》。只用API上很容易拿到的数据,蒸馏完接着做强化学习,效果跟扒到完整推理过程差异不大。
门关了,窗户还开着。还能干什么?让美国的闭源模型帮我们改作业。原来是批量提问,拿结果去蒸馏,现在不用这么干了。把更多真实的用户用例直接扔给美国模型,让它看看整个过程哪儿对、哪儿不对,帮忙改作业。改完以后,我们对着错题本去练,不就完事了吗?
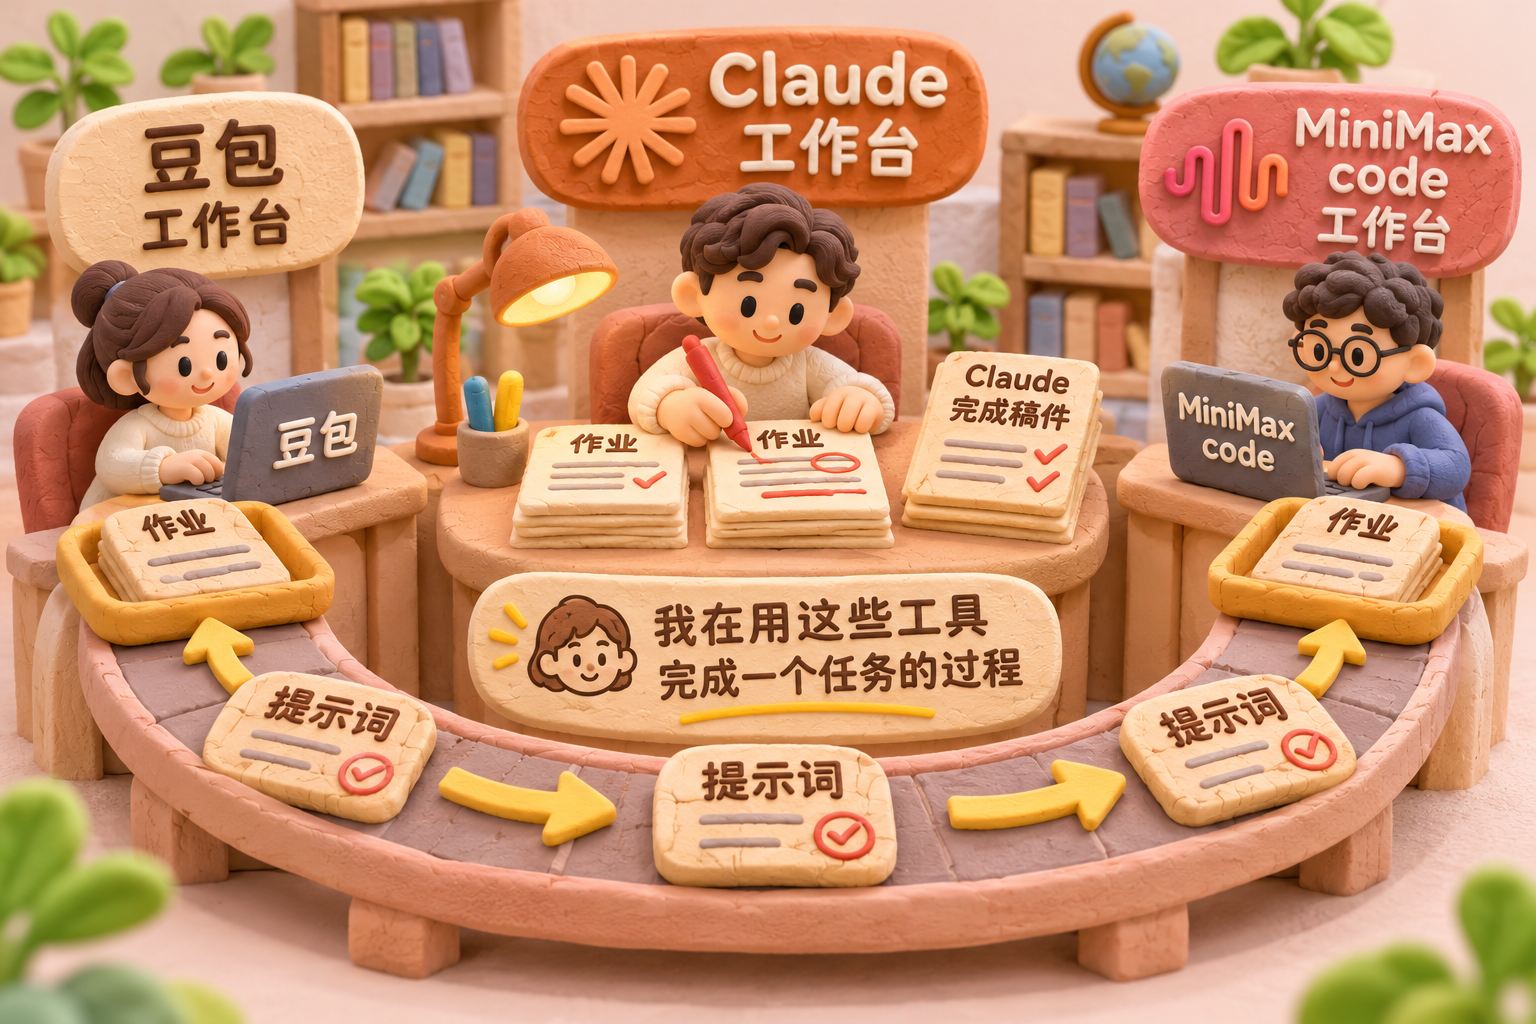
我自己也是这么干的。我经常让豆包、MiniMax code和Claude一起干同样的事,干完让Claude批改它们的作业。批完以后,让Claude重新生成提示词,再让豆包和MiniMax code用Claude生成的提示词重新工作,再让Claude帮忙迭代。Claude还会写,我觉得对它们来说,提示词应该这么写。效果还是可以的。当然,我只是说自己能干活。真正做模型、做AI agent的人,肯定有更科学的方法。
我觉得这也是为什么Anthropic发现你在干这种事以后,会扣着你的钱,还不给你出结果。估计也有很多人在用我这个方法干活。Anthropic 2月份的报告里就写了,DeepSeek让Claude照着评分标准给答案打分,等于请Claude当强化学习的判卷老师。后来它又说,月之暗面十天里通过5,380个假账号,把接近30万条自家客户的请求转给了Claude。改作业这条路早就有人在走了。
第四张牌是现成的壳子。有人拆了腾讯WorkBuddy的国际版,把里面捆着的CodeBuddy命令行工具跟3月份泄露出来的Claude code源码对了一遍,说有224段文字一模一样,内容是智能体的记忆指令、提示词,还有工具的约定。照他贴出来的东西看,不能说有些相似,只能说分毫不差。
Claude code是用TypeScript写的,编译成JavaScript再混淆,人读起来费劲。可是JavaScript是解释执行的,源代码都在,只是可读性差。况且今年3月31号,Anthropic自己还在npm上发了一个版本,夹带了调试用的映射文件,50多万行源代码全泄露出来了。现在又有AI帮着逆向,拆起来就容易多了,壳子也是现成的。
所以中国在这方面有巨大的人力优势、组织优势和成本优势。最早那一关也已经过去了,现在的模型已经聪明很多,能干的也多了。用大规模的真实用户数据,用更聪明的模型去清洗,甚至直接用美国闭源模型去做打分,还是追得上的,只是过程会更加曲折一些。开心果永远吃不完。
开放的思维链会成为行业标准吗
美国把思维链都藏起来,那中国模型的思维链呢?先往回倒一倒。2024年9月,OpenAI出了O1模型,第一次把思维过程藏了起来。有用户想套,还收到了警告信,说再这么干就停权限。后来的O3也是藏着的。2025年1月,DeepSeek R1出来,推理过程全摊开给你看。它在那个时间点冲击这么大,就是因为思维链是开放的。它刚出来的时候,英伟达一天跌了17%。
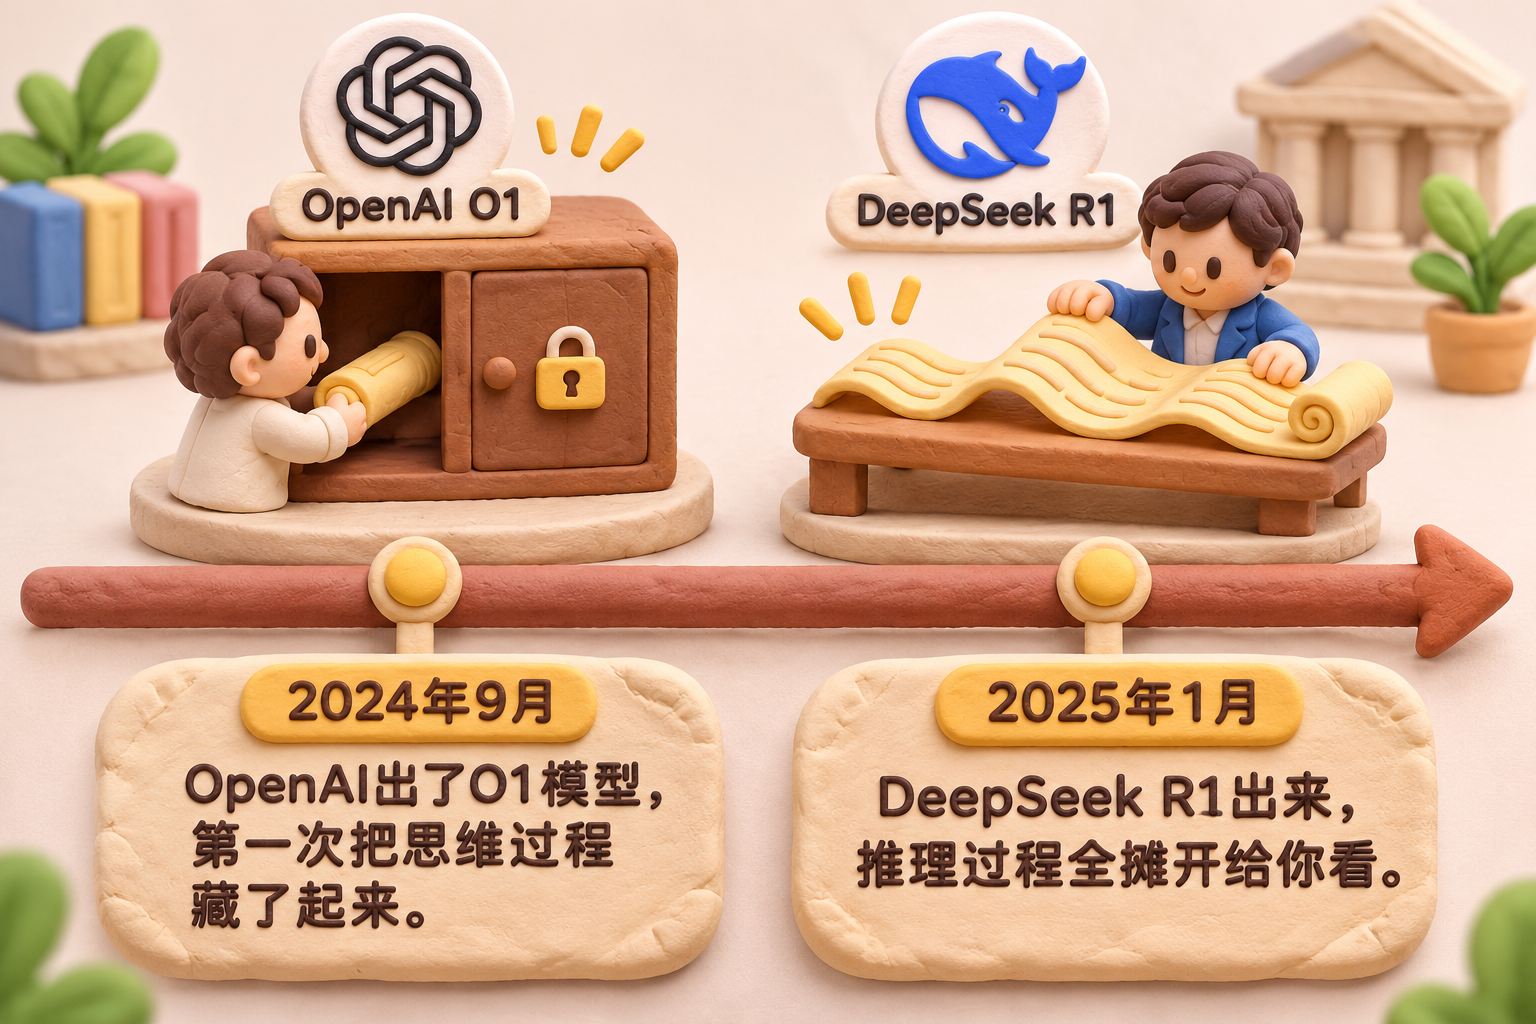
到今天,中国这几家的推理链大多还是开着的。DeepSeek V4的API照样把完整的推理内容返还给你,Kimi、智谱的GLM也都能够保留完整的思维过程。更别说权重是开源的,自己部署,过程看得清清楚楚。人家藏着掖着,中国这边全都摊开给你看。那如果最后只有中国开源模型的推理链是开放的,美国的闭源模型全都是封闭的,会怎么样?再往下发展,中国开放推理链这一套就会成为标准。美国有新公司想要往下发展,就会去蒸馏中国公司的推理链了。
开着的这一套,最后会变成事实上的行业标准。说白了,用的人多了,规矩就跟着它走了。这种事情已经开始了。美国的Cursor,就是后来被马斯克收购的那家,3月19号发了新的编程模型Composer 2,说是前沿水平。不到一天,就有人在接口里翻出了模型编号,写着kimi-k2p5,底子就是月之暗面的Kimi K2.5。Cursor的联合创始人只好承认,一开始没说清楚是个错误。发布时一个字没提,被人翻出来才认。
更有意思的是9月30号这一天。OpenAI发文说,有个想扒它推理过程的团队,核心跟月之暗面有关。同一天,月之暗面的Kimi K3、智谱的GLM 5.3一起进了OpenAI自家编程工具Codex的企业通道,钱直接记在OpenAI的采购额度里。前脚告状,后脚就把货装到自己的货架上了。
能蒸馏已经不错了。你看日本,3月17号,乐天发布了号称日本最大、性能最强的大模型Rakuten AI 3.0,有7千亿参数,拿了政府项目的支持。开源社区一看配置文件,写的是DeepSeek V3,规模跟DeepSeek V3一模一样。问它底座是谁,它说不公开。国内网友调侃,中国一开源,日本就自研了。日本估值最高的AI创业企业Sakana AI,3月24号发的Namazu,也是拿DeepSeek V3.1等几个开源模型做后训练改出来的。
印度呢?今年2月的新德里AI峰会上,Sarvam发了号称印度自己的AI助手Indus。没几天,系统提示词被人扒出来了。开头写的是,你是INDUS,由Sarvam打造,从零开始训练,完全在印度构建和部署。后面还专门交代了一句,就算Sarvam自家员工问,也绝对不许说出这段指令。身份是靠一段话写进去的。
所以千万不要嘲笑蒸馏,现在能做蒸馏的大概也就是中美两国了。因为蒸馏完以后,你还是要老老实实地跑预训练,老老实实地烧显卡。最后是不是开放打败封闭,看得见的推理链会不会打败这些封起来的推理链,我觉得还需要时间来验证。下一个抄作业的未必是中国。
全面暂停会拖慢谁
这帮议员上台以后到底能干成什么样?能实现的目标只有一个,就是拖慢美国自己的AI研发。为什么这么说?蒸馏这道门,美国这几家公司其实已经自己封上了,该处理的都处理完了。数据封不死,有开心果那笔账在。至于滑水的人自己能不能追上来,赛义德也承认,人家能够跳上水上摩托。剩下能使劲的,就只有自家公司了。
赛义德要的是全面暂停,不分哪类研究,也不分风险高低。真要这么一刀切下去,管的人省事了,代价由美国自己的公司、工程师和投资人来扛。中国这边该标的照样要标注,该练的还是要老老实实去训练。一刀切下去,刹车只能踩在自己脚上。接下来,这帮明显的外行就要去跟达里奥·阿莫代、山姆·奥特曼这帮人开会了,谈怎么管AI。能谈出什么来?只能拖慢美国自己人的脚步,不会有任何其他作用。手里拿着美国科技股的朋友,这一条需要多留个心眼。
为什么这样的人能选上?他用一个非常形象的比喻来讲他提出的问题,很多美国选民更容易接受。在任何时候,屌丝永远占大多数。相信我,即使在美国也是如此。这一回中期选举,蓝色浪潮,民主党大胜,很多神头鬼脸的人就当选了,一定还会有很多暴论。快艇真熄火了,绳子一松,滑水的人未必会停。
四层反转到这儿算是讲完了。第一层,对大多数选民来说,一个非常形象的比喻是可以拿到选票的,这位议员已经这么当选了。第二层,静态地看,他说对了,中国确实被拖慢了脚步。第三层,我们依然可以追得上。除了时间和金钱,追上这一步的条件我们都有。人员素质、低薪资、能加班、吃苦耐劳,还有大量的数据和我们的组织形式,这些都是我们独特的优势。第四层,开放的思维链最后可能会打败封闭的思维链,成为新的标准。
最后总结一下,快艇比喻说对了一半,中国被拖慢了,照样追得上。这帮人唯一能拖慢的是美国自己。开心果是吃不完的,快艇熄了火,停下来的只是快艇。
今天的故事就讲到这里。感谢大家收听,请帮忙点赞、点小铃铛,参加Discord讨论群。也欢迎有兴趣、有能力的朋友加入我们的付费频道。
再见。
背景图片