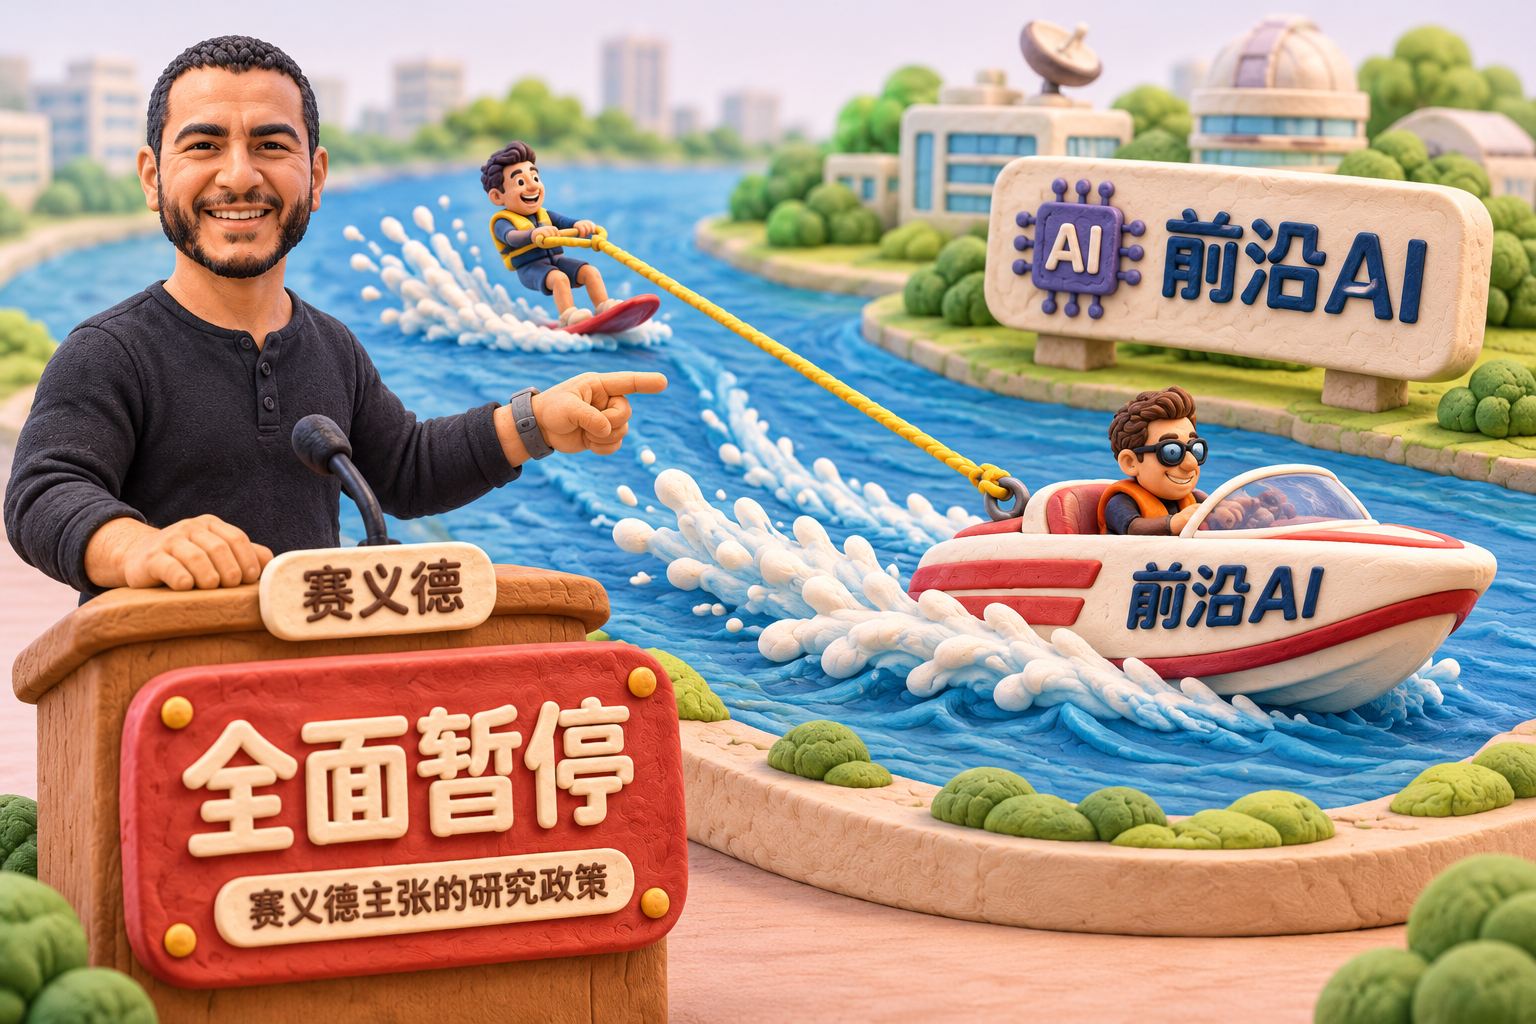
赛义德的快艇比喻说对了一半:若美国全面暂停前沿AI研究,刹住的是自己

赛义德的立体橡皮泥人物站在前景的小讲台后,抬手指向讲台旁的水道微缩模型;一条快艇朝右前方驶去,拖绳斜向画面左后方,连着踩在滑水板上的人物

穆斯林议员赛义德刚当选。他竞选时放话,前沿AI应该全面暂停,还说中国是快艇后面的滑水者。这话到底是暴论还是实话?

大家好,欢迎收听老范讲故事的YouTube频道。

11月3号,美国中期选举,民主党大胜,参众两院都拿下来了。密歇根州42岁的医生赛义德赢了共和党的前众议员罗杰斯,成了美国历史上第一位穆斯林联邦参议员。

投票前两天,11月1号,美国时间星期天晚上,CBS的《60分钟》播了两位候选人的专访。赛义德说,他现在每天从选民嘴里听到最多的就是AI。说到那种可能威胁人类的前沿AI研究,主持人追问了一句:“全面暂停吗?”赛义德照原话回了一句:“应该全面暂停。”那美国停了,中国不停怎么办?在节目放出的加长版访谈里,他说自己不怎么担心,因为中国很多前沿研究是在模仿美国的模型,就好比一条快艇拖着一个滑水的人。

这个比方,他10月21号在底特律经济俱乐部候选人论坛上讲得更直白:“中国能长起来,说白了,靠的是模仿我们的模型。这就像一条船拖着一个滑水的人。我们越开越快,回头一看,他还在后头。我们就说,他还跟着呢,再快点。可人家是在模仿我们的模型。”主持人反问,滑水的人不能自己追上来吗?他也承认,对方可以跳上一辆水上摩托追上来,所以得跟中国签国际条约。

这个比方一出来,常听到两种说法,说这些话的还不光是普通人。一种是,中国人就是抄,就是蒸馏。说这话分量最重的是Anthropic的CEO达里奥·阿莫代。他在播客里说,很多模型,特别是从中国来的,是冲着跑分优化的,是从美国大实验室蒸馏出来的。可要说抄,美国自己人也在抄。今年4月30号,马斯克在加州联邦法院作证,被问到xAI有没有蒸馏过OpenAI的模型。他说部分是,还补充说这是业内的普遍做法。蒸馏不是中国特产。

另一种说法是,这是扯淡,中国有自己的创新,美国一停,中国马上就超车。这话黄仁勋说得最响。去年11月,他跟《金融时报》说,中国会赢下这场AI竞赛。可他这话还有后半句,全世界一半的AI研究员是中国人,美国得让英伟达留在中国,才能把这批开发者争取过来。喊中国要赢,是为了回中国卖卡。两拨人吵的都是中国行不行,可这大半年,美国大厂到底干了什么?没几个人去看。

那这个比方到底对不对?赛义德的快艇比喻说对了一半。中国确实被拖慢了,但照样追得上。他们上台唯一能拖慢的,只有美国自己。这件事里有四层反转。第一层,一个比喻就能换来一张参议院的门票。第二层,这个外行打的比方偏偏还说对了一半。第三层,说中了,却拦不住我们。第四层,再往后走,被逼着去抄作业的可能就会换成美国人了。

封锁就像一屋子开心果,吃是吃不完的,只是越往后找下一颗越费劲。说白了,卡得住一时,卡不住一世。底气来自两样东西,美国大厂自己公布的数据,和一笔中美标注行业的账。四层反转一层一层来剥。先说比喻怎么换来门票,再看美国怎么把蒸馏堵上,然后说那一屋子开心果,中国怎么接着找,最后看开放思维链会不会反过来成为标准。剥完了,再说这帮议员上台到底能干成什么。

阅读更多

疯狂抢人 vs 闪电离职:Meta AI团队为何刚组建就内乱不断?两个月上演的收购神话与破灭 — Meta AI 战略、AI 模型、Scale AI、扎克伯格、Llama

Meta的抢人大战,难道要一地鸡毛了吗?

大家好,欢迎收听“老范讲故事”的YouTube频道。

到底发生了什么呢?跟着亚历山大·王一块入职的ScaleAI的高管,突然因为个人原因离职了。有些人呢,刚被挖过来,屁股还没坐热呢,又离职回去了。ScaleAI被曝出数据质量太差,Meta在采购ScaleAI的数据同时,还去采购了竞争对手的高质量数据。因为大家知道,ScaleAI是做数据标注的,你要想去训练新模型,你就要去采购数据。我这边投了这么多钱了,发现不能使,还得买别人的。

还有什么呢?ScaleAI失去了谷歌和OpenAI这些大客户以后,被爆出来进行了大力的裁员。Meta现在正在使用竞争对手的产品,比如跑去使用ChatGPT、使用Gemini、使用Anthropic的Claude,去使用这玩意儿去了。以及爆出Meta内部的管理非常混乱。

阅读更多

Meta为何砸下百亿重金投资而非直接收购AI数据标注巨头Scale AI?揭秘扎克伯格剑指AI生态霸权,欲借华人天才少年之力挽救Llama开源模型困局的深层战略与考量。

Scale AI得到了Meta超过百亿美金的投资,AI圈又热闹起来了。大家好,欢迎收听老范讲故事的YouTube频道。

Scale AI这个名字怎么好像在哪听说过呢?好像有点耳熟,对吧?他呢,有一位特别传奇的CEO,或者叫创始人吧,叫华人天才少年CEO亚历山大王。当时呢,跳出来指责DeepSeek用H100的就是他。

DeepSeek R1到底是怎么训练的?引起了广泛的关注。DeepSeek自己讲呢,我使用了2,000多块的H800就完成了训练。但是亚历山大王呢,在一次接受采访的时候就出来说了,中国实验室里边拥有的H100的数量远超大家的想象,DeepSeek自己至少有5万块H100。但是这个话呢,没有实际证据,讲完了也就完了。DeepSeek跟亚历山大王之间呢,并没有就这个事情进行认真的探讨,所以这个我们把它当成一种谣传吧。

3月份呢,DeepSeek自己再次发了声明,说他们训练的都是使用的合规的GPU,也就是允许向中国出口的这些GPU。因为如果不说这个的话,美国就有可能要求说禁止使用这玩意儿。DeepSeek就讲了说,甭管是R1也好,V3也好,训练呢都是使用的H800,或者是后面的H20这些GPU训练的。

阅读更多

马斯克率领Neuralink团队揭示脑机接口新未来:神秘访谈带你解读核心技术与人类成神之路

马斯克的脑机接口已经成为了人类的成神之路。大家好,这里是老范讲故事的YouTube频道。今天咱们来讲一讲,在上周五,马斯克和整个脑机接口团队一起接受了8小时的访谈,都谈了些什么。时间是8月2号,名字叫做《Neuralink与人类未来》。著名的科技博主莱克斯·弗里德曼主持了这场访谈。参加访谈的有Neuralink公司的创始人埃隆·马斯克,还有他们的首席科学家DJ·SEO,以及首位Neuralink脑机接口的植入者诺兰·阿伯。

那么主要讲的是一些什么样的内容呢?首先,现在的技术还比较可笑。虽然方向是指明了,但并不是那么看起来高大上的样子。64根导线就真的是往脑子里塞线,每根线上有16个电极。这些电极是在三四个毫米的范围内进行分布。应该是一根线出去以后,有16个小电极从线里的中间插出来,这个长度三四个毫米。在这个线的周围把它分布出来,这16个电极是以200微米的间隔进行排布。这些电极的深度是3-5毫米,它真的是要插进去的,而不是说贴在上面的,是要插到我们的脑皮层里边去的,是一个有损害的手术,这个还是有点吓人的。

阅读更多

番茄小说AI附加条款引发网文作者激烈反击,停更、转场、抗议。小说写手,直面AIGC的第一仗,谁能赢?

网文作者向AIGC发起了反击。中国最大的网文平台番茄小说,因为在协议里要求网文作者授权他们使用作品进行大模型训练,导致这些作家纷纷退网,纷纷停更,向他们正式发起了反击。

大家好,这里是老范讲故事的YouTube频道。今天咱们来讲一讲番茄小说的AI附加条款到底是怎么回事。上面写了,任何作者到任何的小说平台上去写小说,都是要跟人家签协议的。说我在你这里写小说,遵守你的规则,你给我分钱。

番茄小说的协议里头呢,就突然多了一个条款,这个条款呢叫做AI附加条款。条款怎么写的?甲方可将签约作品的全部部分内容以及相关信息,包括作品名称、简介、大纲、章节、人物、作者个人信息、封面等数据语料、文本素材等,用于标注合成数据数据库建设、AI人工智能研发、机器学习模型训练、深度合成算法研发等目前已知或未来开发的新技术研发应用领域,包括但不限于:一、用于智能对话、智能文本、图像、视听语音等作品成品的编辑生成转换、深度合成、虚拟现实技术等再研发和应用;二、用于任何技术下的AI人工智能模型训练,或用于生成提供给模型训练的合成数据数据库;三、其他任何新技术研发或应用场景。

阅读更多